[JVM] G1 GC의 보충설명
해당 글은 지난 글의 보충을 위해 작성한 글이며 6절과 7절에 대한 내용의 보충을 위해 쓴 글이다
6. Concurrent Mark는 언제 시작되는가?
G1 GC는 평소에는 Young GC를 반복해서 수행한다.
Normal Young GC
        ↓
Normal Young GC
        ↓
Normal Young GC
하지만 Old 영역의 사용량이 계속 증가하면 언젠가는 Old 영역도 회수해야 한다.
이때 G1은 Old 영역이 완전히 가득 찬 뒤에 움직이는 것이 아니라, 미리 Concurrent Mark를 시작한다.
Concurrent Mark를 시작할 시점을 판단하는 기준이 IHOP(Initiating Heap Occupancy Percent) 이다.
초기에는 기본값을 기준으로 판단하지만, 일반적으로 G1은 이전 GC 사이클에서 다음 정보를 학습해 Concurrent Mark 시작 시점을 동적으로 조정한다.
- Concurrent Mark에 얼마나 시간이 걸렸는지
- Old 영역이 얼마나 빠르게 증가하고 있는지
- Mixed GC를 시작하기 전까지 얼마나 여유 공간이 필요한지
즉 IHOP의 목적은 단순히 Old 사용량이 일정 비율을 넘었으니 GC 시작 하는 것이 아니다.
핵심 목적은 Heap이 부족해지기 전에 Concurrent Mark 후에 Mixed GC까지 완료할 수 있도록 충분히 일찍 시작하는 것이다.
6-1. Initial Mark는 별도의 GC가 아니다
IHOP 조건을 만족했다고 바로 별도의 Initial Mark GC가 발생하는 것은 아니다.
G1은 다음 Young GC를 Concurrent Start GC로 수행한다.
Normal Young GC
        ↓
IHOP 조건 만족
        ↓
Concurrent Start GC
Concurrent Start GC는 기존 Young GC가 수행하던 작업과 함께 Concurrent Mark를 시작하기 위한 초기 작업도 수행한다.
Concurrent Start GC

Young Region Evacuation
        +
Initial Mark
즉, Initial Mark를 위해 별도의 STW를 한 번 더 발생시키는 것이 아니라 원래 Young GC 때문에 STW가 발생할 때 Initial Mark 작업까지 함께 수행하는 것이다. Concurrent Start GC가 끝나면 본격적인 Concurrent Mark 사이클이 시작된다.
Young-only Phase
        ↓
Normal Young GC
        ↓
Normal Young GC
        ↓
IHOP 조건 만족
        ↓
Concurrent Start GC
(Young GC + Initial Mark)
        ↓
Root Region Scan
        ↓
Concurrent Mark
6-2. Concurrent Mark의 가장 큰 문제
Concurrent Mark라는 이름처럼 G1은 애플리케이션을 완전히 멈추지 않고 객체의 생존 여부를 조사한다.
Application Thread 실행하면서 GC Thread를 이용해 Marking 하게 되면서 문제가 발생한다.
GC가 객체 관계를 조사하는 동안 애플리케이션 역시 객체의 reference를 계속 변경할 수 있기 때문이다.
이 문제를 이해하기 위해 먼저 Tri-color Marking을 알아야 한다.
6-3. Tri-color Marking
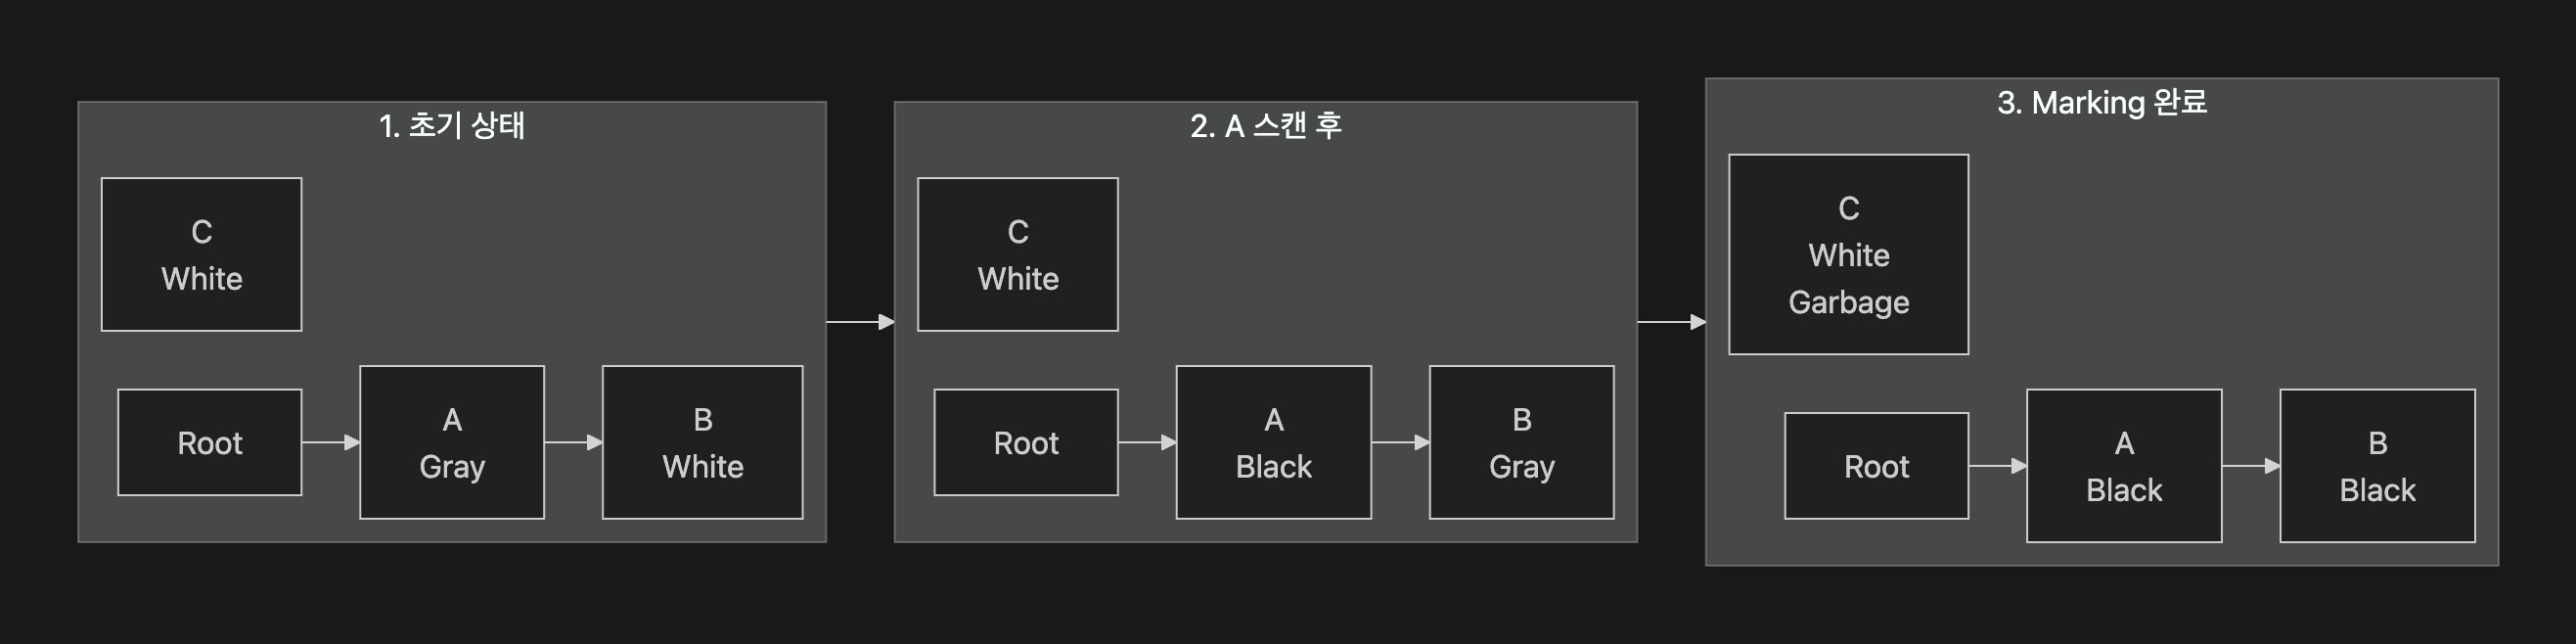
Tri-color Marking에서 객체를 개념적으로 세 가지 상태로 나눠 생각할 수 있다.
White는 아직 GC가 발견하지 못한 객체다. Marking이 모두 끝난 이후에도 White라면 Garbage로 판단한다.
Gray는 Root에서 도달할 수 있다는 것은 확인했지만 해당 객체가 참조하고 있는 다른 객체는 아직 모두 조사하지 않은 상태다.
Black은 객체 자체도 살아있고 해당 객체가 참조하고 있는 다른 객체까지 모두 조사한 상태다.
6-4. Concurrent Mark에서는 객체 그래프가 계속 바뀐다
문제는 G1의 Concurrent Mark가 애플리케이션과 동시에 실행된다는 것이다.
GC가 객체 그래프를 탐색하고 있는 동안에도 애플리케이션은 객체의 reference를 계속 변경할 수 있다.
예를 들어 Concurrent Mark 시작 시점에 다음과 같은 객체 그래프가 있다고 하자.
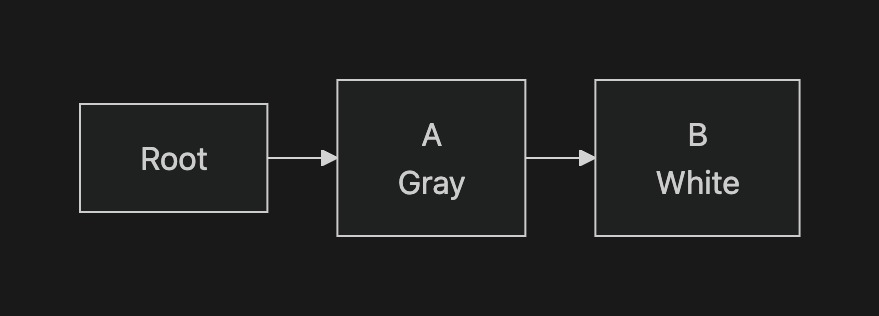
이 시점에서 B는 Root → A → B 경로를 통해 도달할 수 있으므로 분명히 Live 객체다.
하지만 아직 GC는 A만 발견한 상태이고, A가 가리키는 B까지는 조사하지 않았다고 가정하자.
즉 현재 상태는 다음과 같다.
A = Gray
B = White
이때 GC가 A를 스캔하기 전에 애플리케이션 스레드가 다음 코드를 실행할 수 있다.
a.ref = null;그러면 객체 그래프는 다음처럼 변경된다.
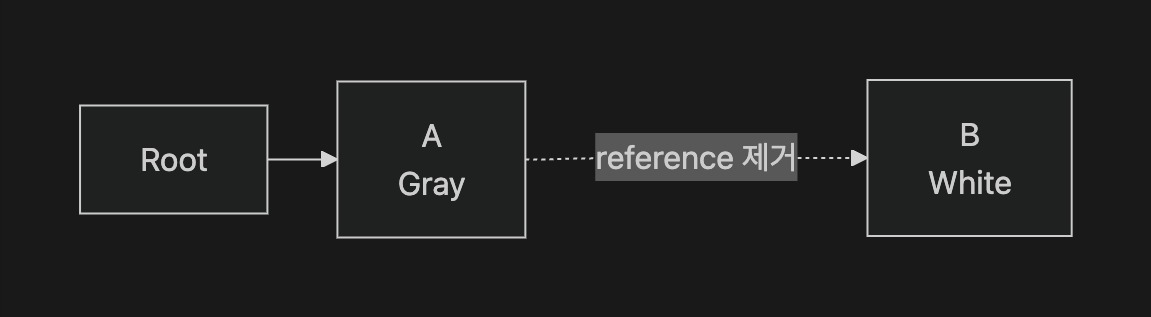
원래 존재하던
A → B참조가 사라진 것이다. 이제 GC가 A를 스캔하면 A가 더 이상 B를 참조하지 않기 때문에 B를 발견할 수 없다.
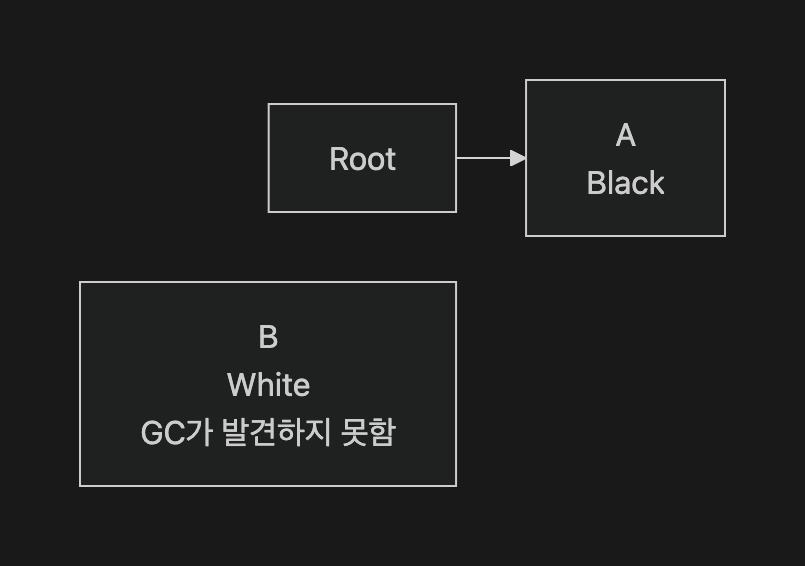
Marking이 그대로 끝난다면 B는 마지막까지 White 상태로 남게 된다. Tri-color marking 관점에서는
White
→ 발견되지 않은 객체
→ Marking 종료 후 Garbage로 판단 가능
이므로 GC는 B를 Garbage로 판단할 수 있다. 하지만 중요한 점은 Concurrent Mark가 시작되던 순간에는 B가 분명히 Live 객체였다는 것이다. 전체 과정을 한 번에 보면 다음과 같다.
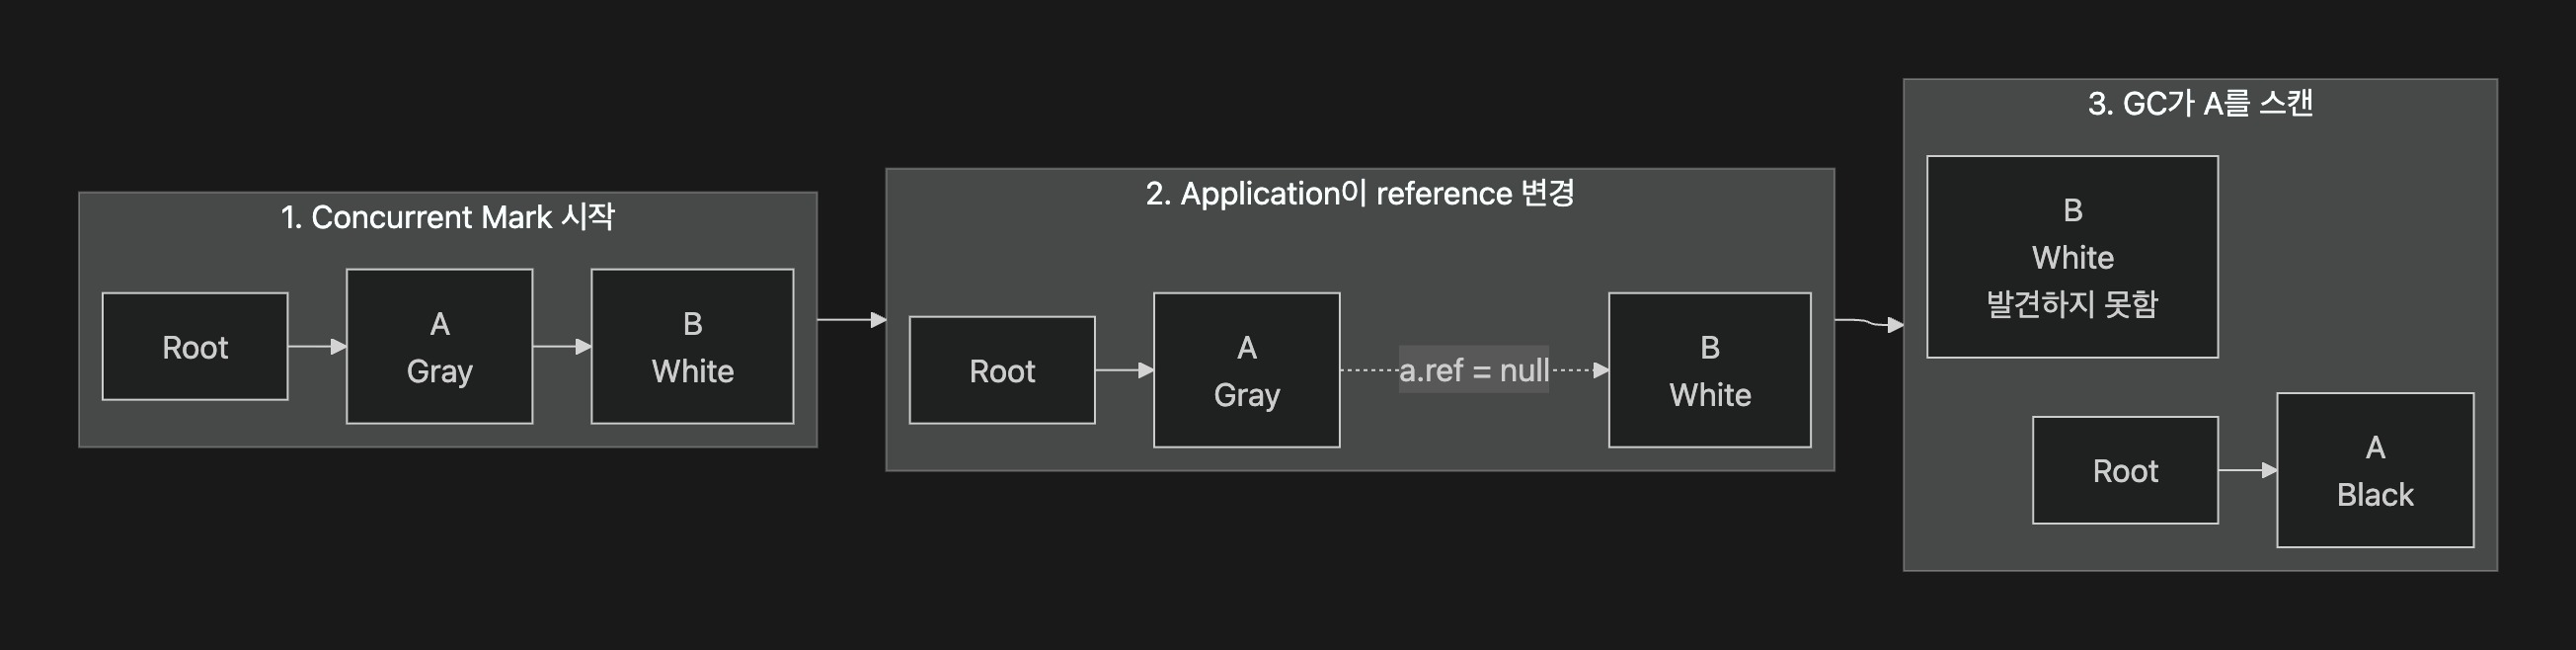
즉 문제의 핵심은 다음과 같다. GC 객체 그래프를 탐색 중 동시에 Application이 객체 그래프를 변경 하여 Concurrent Mark에서는 GC가 Heap을 조사하는 동안 객체 그래프 자체가 계속 바뀐다. 따라서 아무런 보완 장치가 없다면 Marking 시작 시점에는 살아있던 객체가 reference 변경 때문에 GC의 탐색 경로에서 사라질 수 있다. G1은 이 문제를 해결하기 위해 SATB(Snapshot At The Beginning) 를 사용한다.
6-5. SATB - Snapshot At The Beginning
SATB의 핵심 아이디어는 이름 그대로 Snapshot At The Beginning이다.
즉, Concurrent Mark가 시작된 시점에 살아있던 객체를 놓치지 않도록 하자라는 방식이다.
앞에서 본 것처럼 Concurrent Mark 도중 애플리케이션이 객체의 reference를 변경하면 GC가 아직 탐색하지 못한 객체로 향하는 경로가 사라질 수 있다. 예를 들어 Concurrent Mark 시작 시점에 다음과 같은 객체 관계가 있다고 하자.
현재 B는
Root → A → B경로를 통해 도달할 수 있으므로 Live 객체다.
그런데 GC가 아직 B를 발견하기 전에 애플리케이션이 다음 코드를 실행하려고 한다.
a.ref = null;아무런 처리를 하지 않고 reference를 바로 제거하면 다음과 같은 상태가 된다.
이제 GC가 A를 탐색하더라도 B로 향하는 reference가 존재하지 않기 때문에 B를 발견하지 못할 수 있다.
SATB는 이를 막기 위해 reference가 변경되기 전에 기존 reference를 먼저 기록한다. 이 작업을 담당하는 것이 SATB Pre-Write Barrier다. 전체 과정을 보면 다음과 같다.
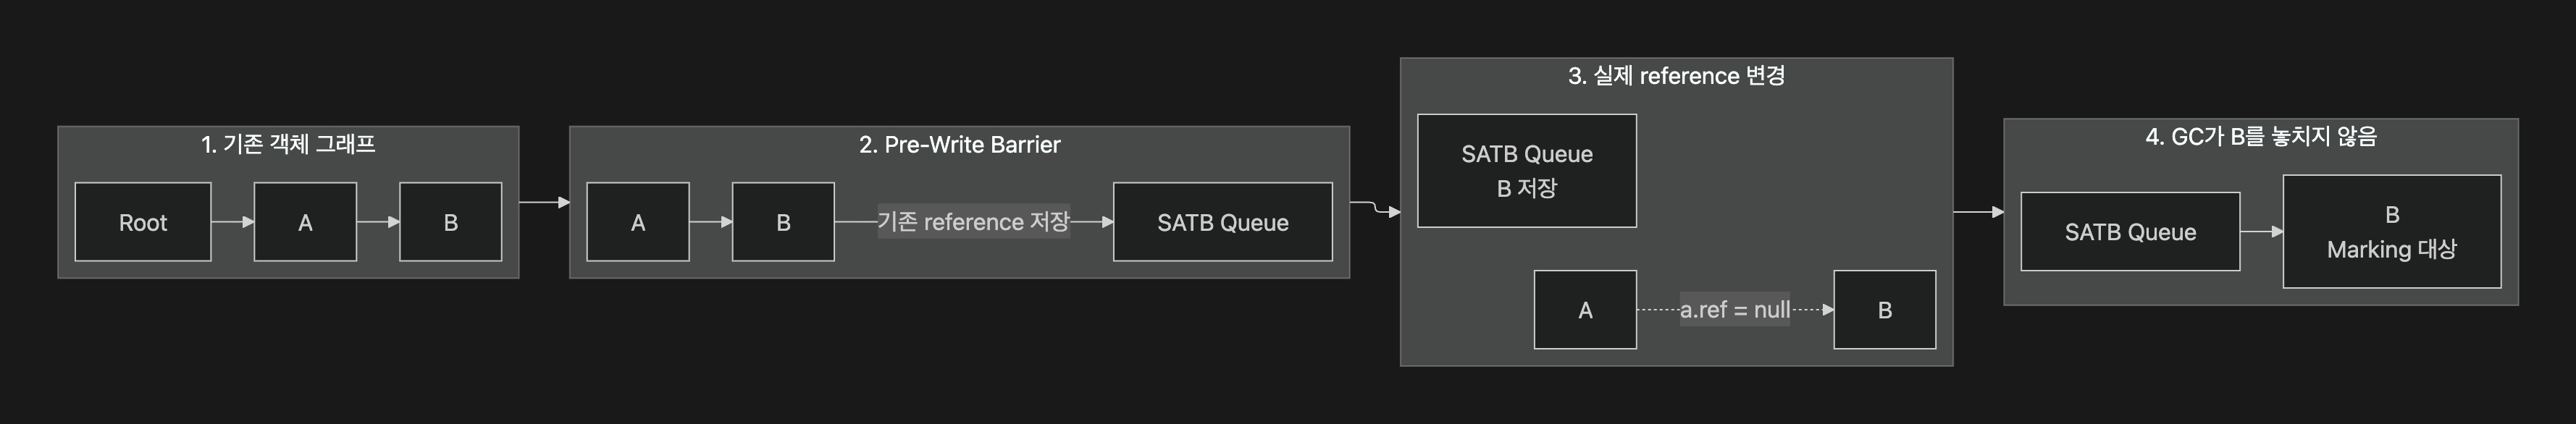
조금 더 코드 관점에서 보면 다음과 같은 흐름이다.
a.ref = null이라는 reference 변경이 일어날 때 개념적으로는 바로 값을 변경하는 것이 아니다.
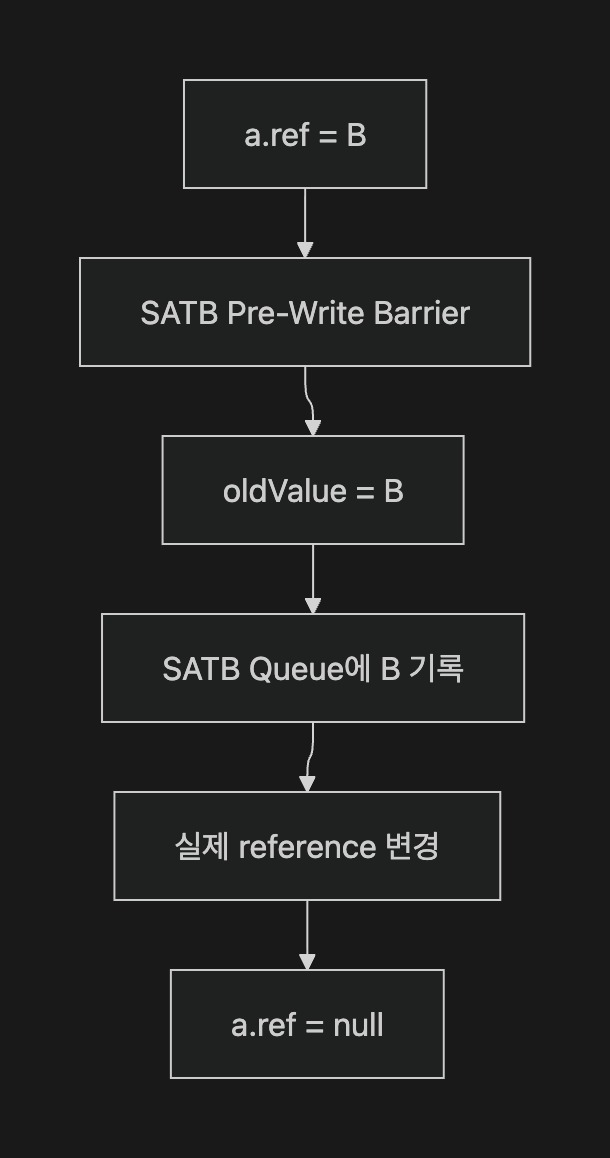
즉 SATB는 다음 순서로 동작한다.
1. 기존 reference 확인

oldValue = a.ref   // B


2. SATB Queue에 기존 reference 기록

SATB Queue ← B


3. 실제 reference 변경

a.ref = null
reference 변경이 끝난 뒤 실제 Heap의 객체 그래프는 다음과 같다.
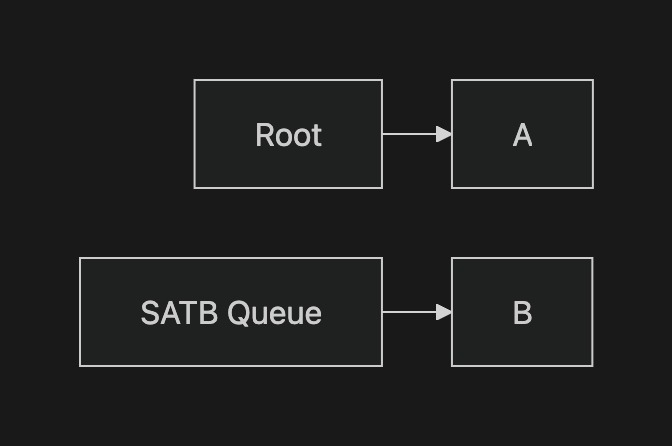
A → B 연결은 이미 사라졌다. 하지만 B가 SATB Queue에 기록되어 있기 때문에 GC는 B를 Marking 대상으로 다시 처리할 수 있다. 따라서 Concurrent Mark 도중 객체 그래프가 변경되어도 시작 시점에 살아있던 객체를 놓치지 않는다.
전체 과정을 한 그림으로 정리하면 다음과 같다.
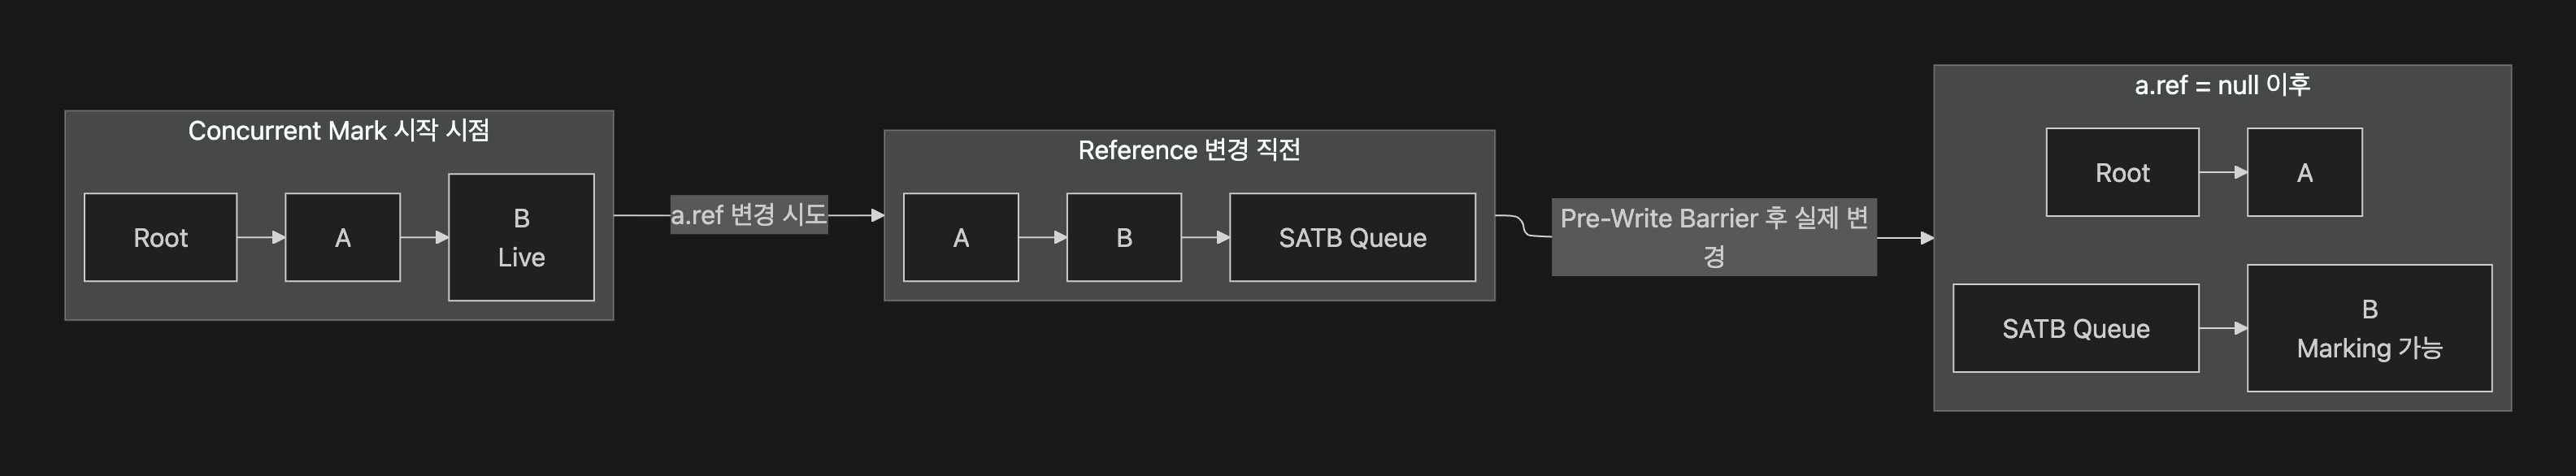
핵심은 새롭게 저장되는 reference가 아니라 사라질 기존 reference를 기억한다는 것이다. 그래서 SATB Barrier는 reference 변경 이전(Pre) 에 동작하는 Pre-Write Barrier다. 결국 SATB는 객체 그래프가 Concurrent Mark 도중 계속 변경되더라도 Mark 시작 시점에 살아있던 객체로 향하던 reference가 사라지는 순간 그 기존 reference를 따로 기록해 GC가 객체를 놓치지 않도록 하는 방식이라고 이해할 수 있다.
6-6. 왜 Pre-Write Barrier인가?
SATB Barrier가 Pre-Write Barrier라고 불리는 이유는 reference가 바뀐 이후가 아니라 바뀌기 직전에 기존 reference를 기록하기 때문이다. 예를 들어 다음 코드가 실행된다고 하자.
a.ref = newObject;개념적으로는 다음과 같은 과정이 수행된다.
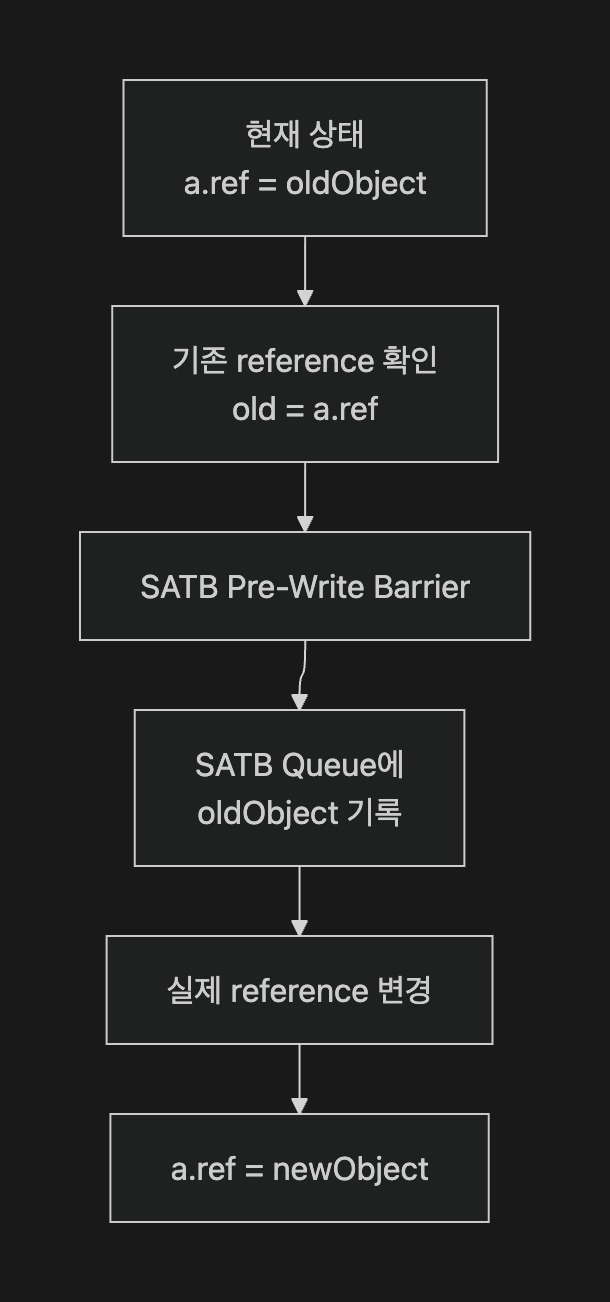
즉 SATB가 관심을 가지는 것은 새롭게 연결될 newObject가 아니다.
reference 변경으로 인해 사라질 기존 reference인 oldObject를 보존하는 것이 목적이다.
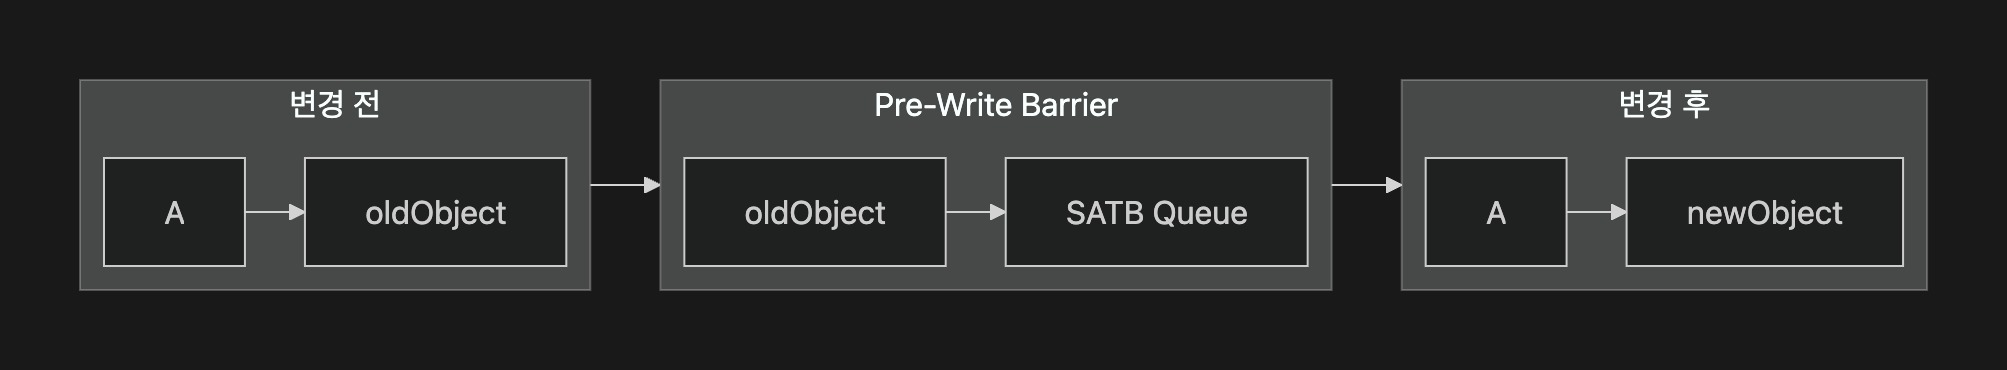
정리하면 다음과 같다. SATB는 reference가 사라진 뒤에 복구하는 것이 아니라, 사라지기 전에 기존 reference를 미리 기록한다.
6-7. SATB의 대가 - Floating Garbage
SATB는 Concurrent Mark가 시작된 시점의 Heap 상태를 기준으로 Live 객체를 추적한다.
이 때문에 실제로는 Garbage가 된 객체가 이번 GC Cycle에서는 Live로 남을 수 있다.
예를 들어 Concurrent Mark 시작 시점에 다음과 같은 객체 그래프가 있다고 하자.
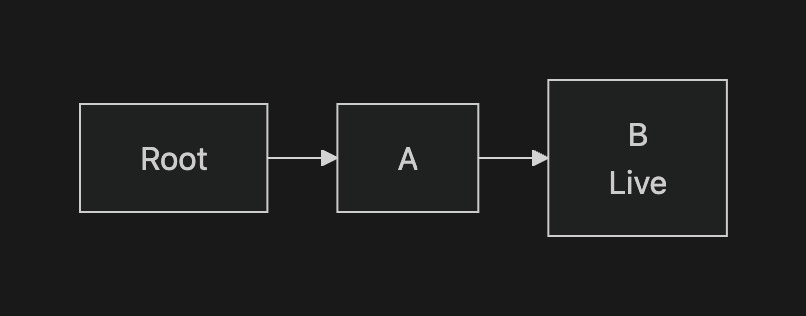
이 시점에서 B는 Root → A → B 경로를 통해 도달 가능하므로 Live 객체다.
그런데 Concurrent Mark 도중 애플리케이션이 다음 코드를 실행한다.
a.ref = null;그러면 실제 객체 그래프에서는 B로 향하는 reference가 사라진다.
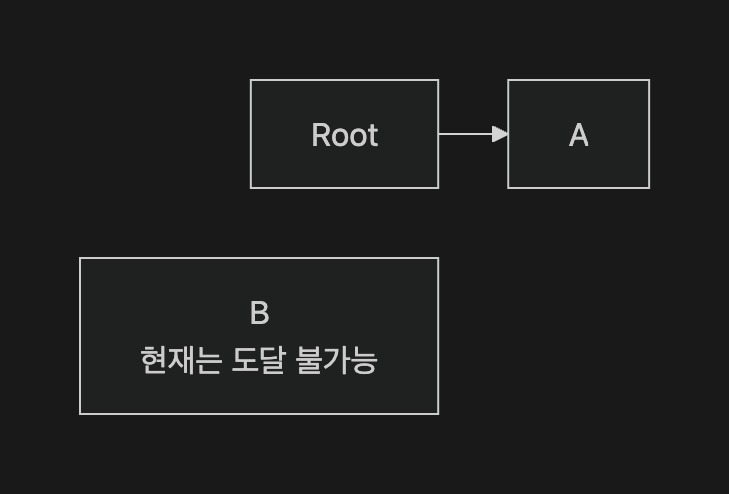
현재 Heap만 본다면 B는 Garbage다.
하지만 SATB는 reference가 제거되기 전에 기존 reference인 B를 SATB Queue에 기록해 둔다.
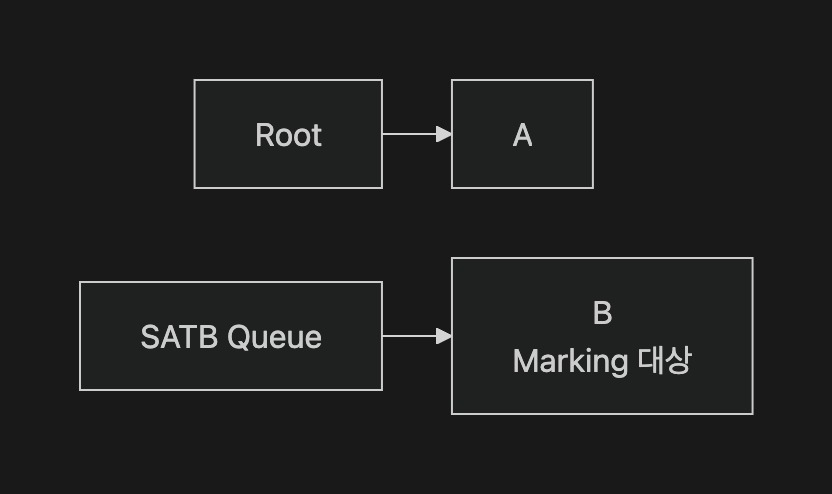
따라서 B는 실제로는 더 이상 Root에서 도달할 수 없더라도 이번 Marking Cycle에서는 Live로 취급될 수 있다.
전체 흐름을 보면 다음과 같다.
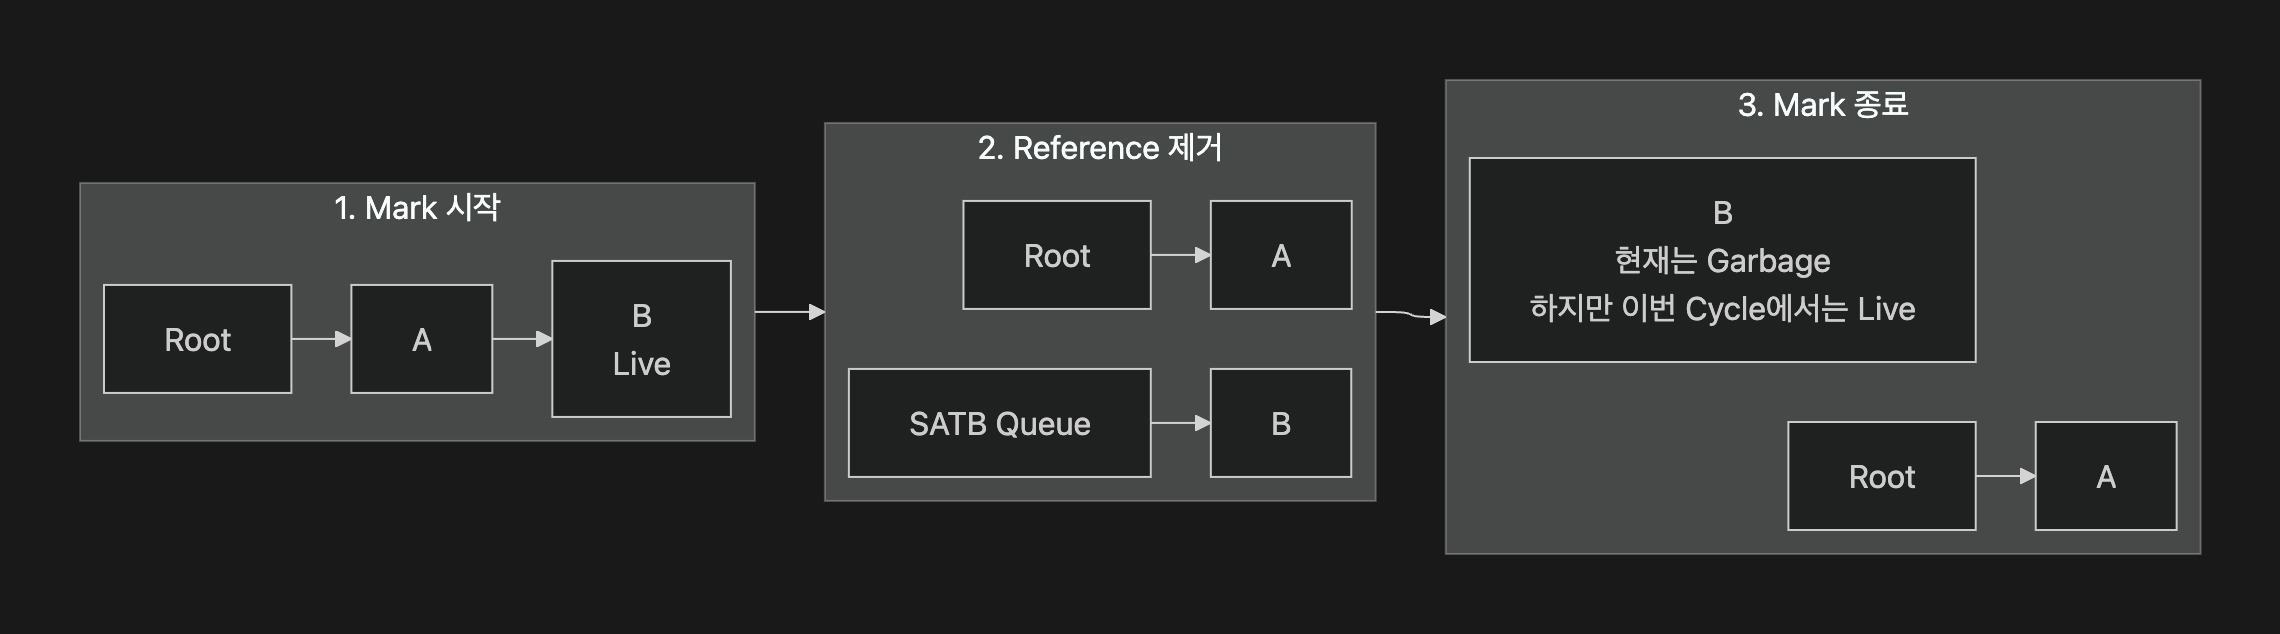
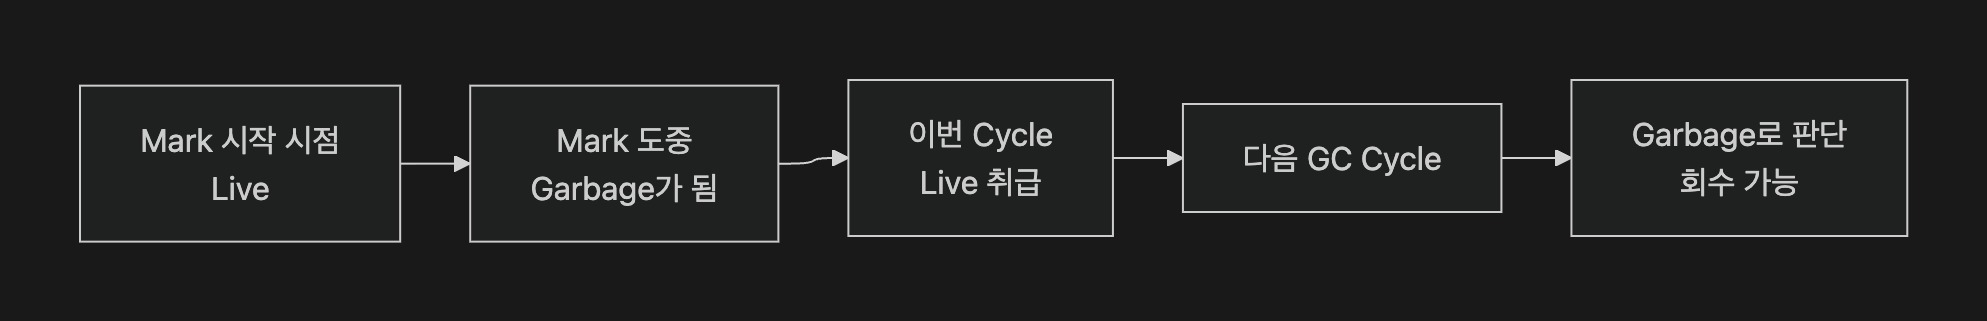
이러한 객체를 Floating Garbage라고 한다.
즉 SATB는 현재 순간의 Garbage를 100% 즉시 찾아내는 방식이 아니다. SATB가 보장하려는 것은 Concurrent Mark 시작 시점에 살아있던 객체를 놓치지 않는 것이다. 따라서 Concurrent Mark 도중 Garbage가 된 객체는 이번 Cycle에서는 살아남고 이후 GC Cycle에서 다시 Garbage로 판단되어 회수될 수 있다.
6-8. Concurrent Mark 이후 생성된 객체는 어떻게 처리할까?
Concurrent Mark를 시작한 이후에도 애플리케이션은 새로운 객체를 계속 생성한다.
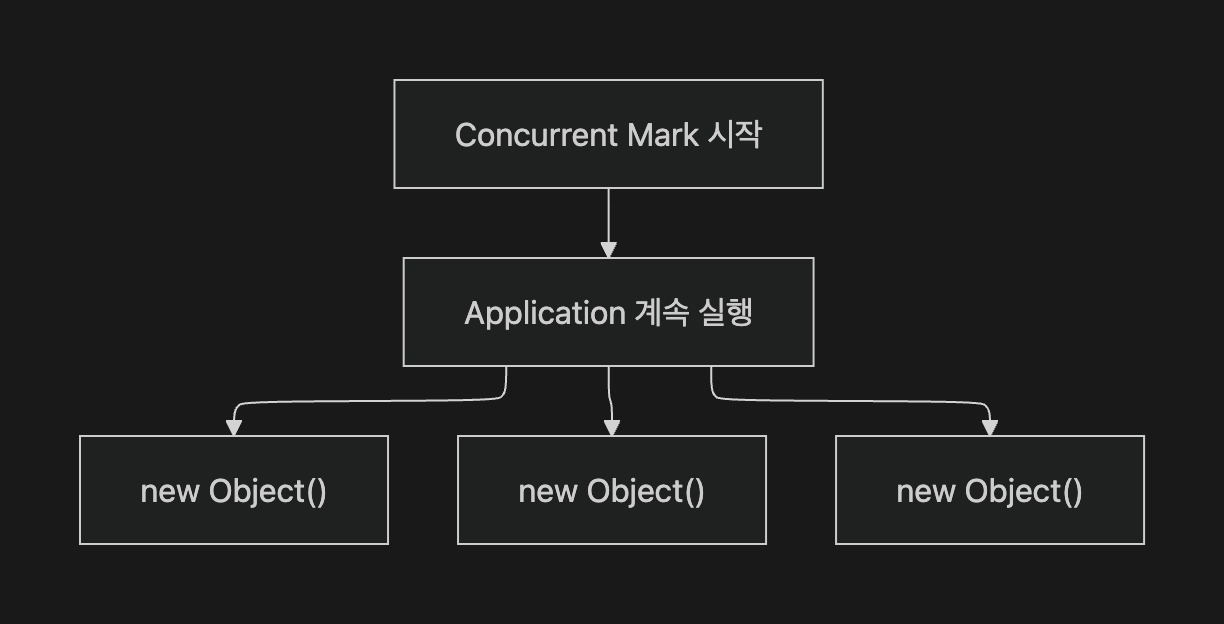
그렇다면 Marking 시작 이후 생성된 객체들은 어떻게 처리해야 할까? G1은 Region마다 Marking을 시작했던 시점의 top 위치를 기억한다. 이때 사용하는 개념이 TAMS(Top At Mark Start) 다. Region을 단순화하면 다음과 같이 볼 수 있다.
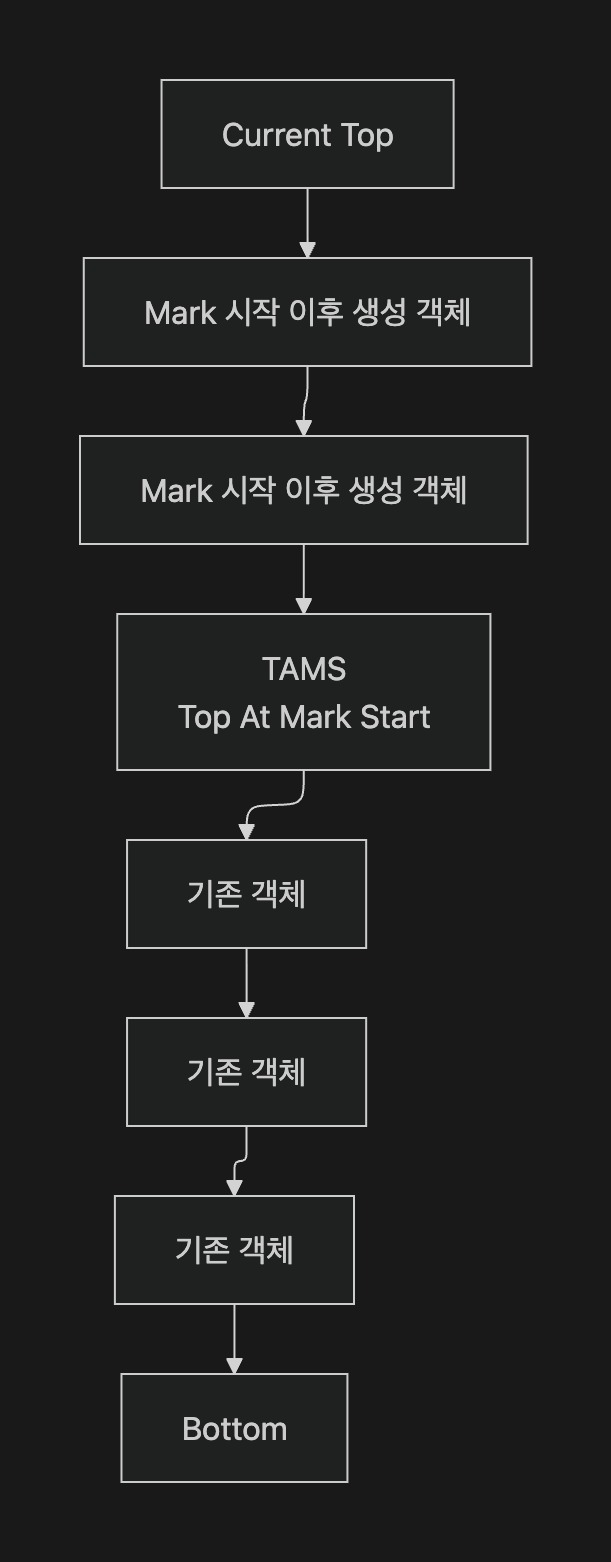
TAMS 아래쪽은 Concurrent Mark가 시작되기 이전부터 존재했던 객체들이다.
반면 TAMS 위쪽은 Mark가 시작된 이후 새롭게 할당된 영역이다. 이 영역은 이번 Marking Cycle에서 기본적으로 Live로 취급한다.
SATB와 TAMS를 같이 보면 Concurrent Mark의 전략은 다음처럼 이해할 수 있다.
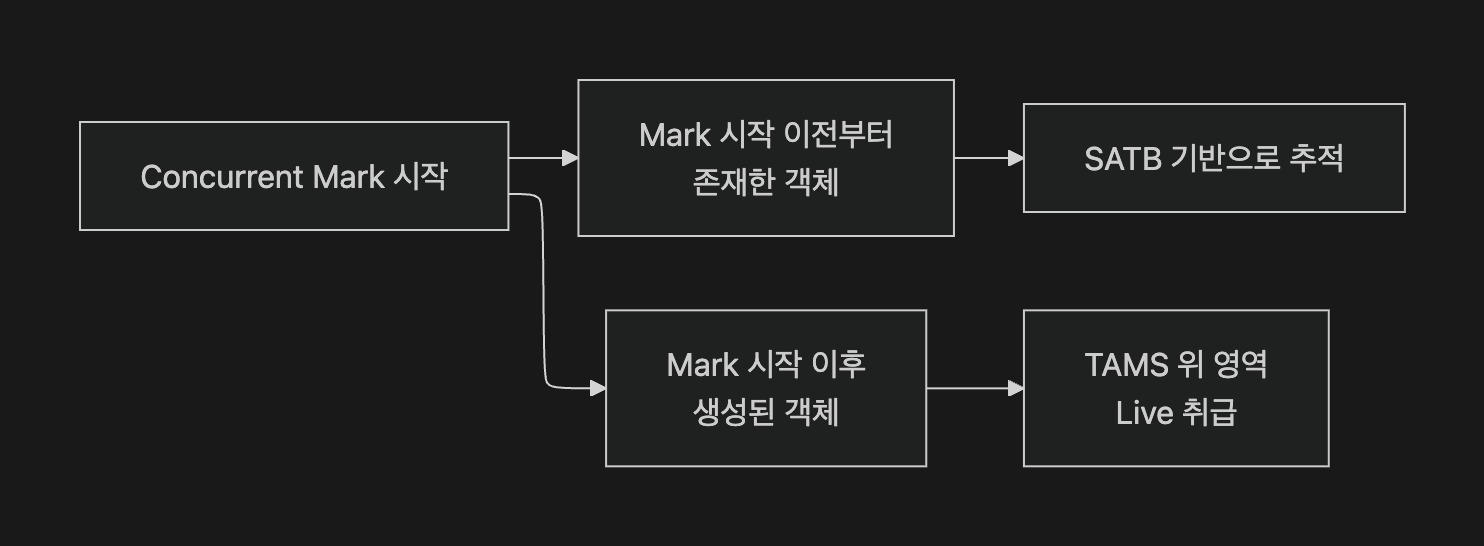
역할을 나누면 다음과 같다.
구분처리 방식
| Mark 시작 이전 객체 | SATB와 Marking을 통해 생존 여부 추적 |
| Mark 시작 이후 객체 | TAMS를 기준으로 이번 Cycle에서는 Live 취급 |
6-9. SATB와 Remembered Set Barrier는 목적이 다르다
G1에서는 reference 변경 과정에서 서로 다른 목적을 가진 Barrier들이 사용된다.
대표적인 것이 다음 두 가지다.
- SATB Pre-Write Barrier
- RSet Post-Write Barrier
둘은 같은 reference 변경에서 동작할 수 있지만 해결하려는 문제는 완전히 다르다.
| 구분 | SATB Barrier | RSet Barrier |
| 시점 | reference 쓰기 전 | reference 쓰기 후 |
| 종류 | Pre-Write Barrier | Post-Write Barrier |
| 기록 대상 | 변경되기 전 기존 reference | 변경이 발생한 Card |
| Queue | SATB Queue | Dirty Card Queue |
| 목적 | Concurrent Mark 정확성 | Region 간 reference 추적 |
| 결과 | Marking 정보 | Remembered Set |
예를 들어 다음 코드가 실행된다고 하자.
a.ref = b;개념적으로는 다음 흐름으로 볼 수 있다.
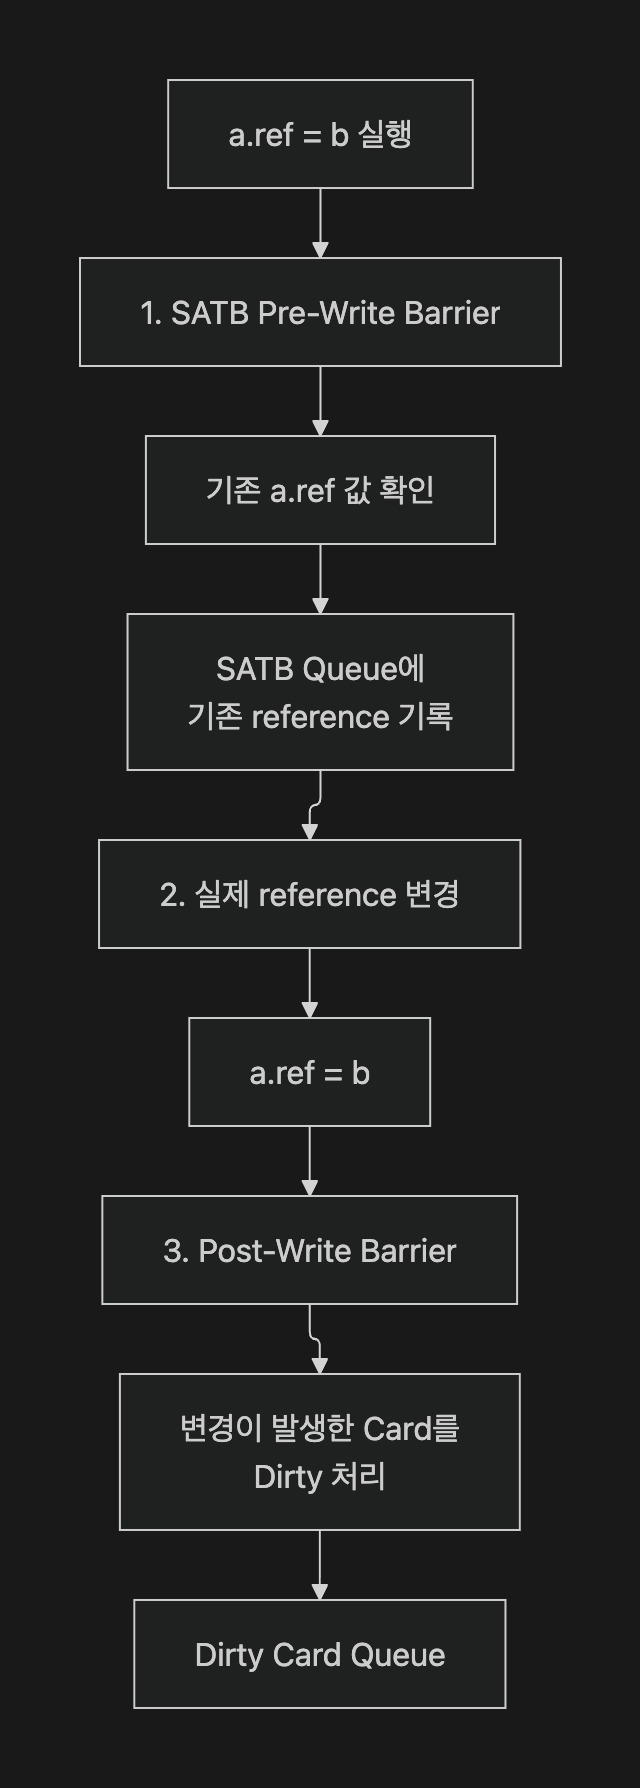
이후 Dirty Card Queue는 Refinement Thread가 처리한다.
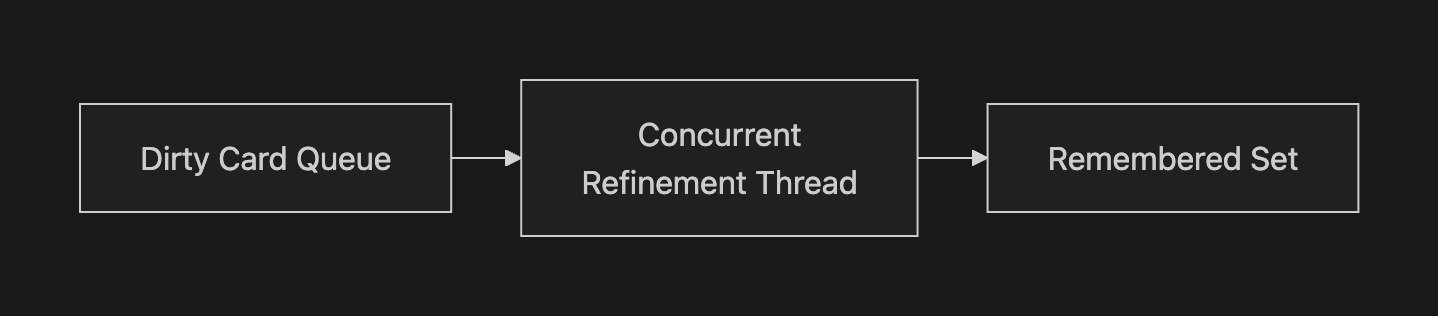
따라서 두 Barrier를 한 문장으로 비교하면 다음과 같다.

즉, SATB는 Concurrent Mark의 정확성을 위한 장치이고, RSet Barrier는 Region 단위 GC의 효율성을 위한 장치다.
6-10. Refinement Thread가 처리를 못 따라가면?
애플리케이션이 reference를 매우 빠르게 변경하면 Dirty Card 역시 빠르게 생성된다.
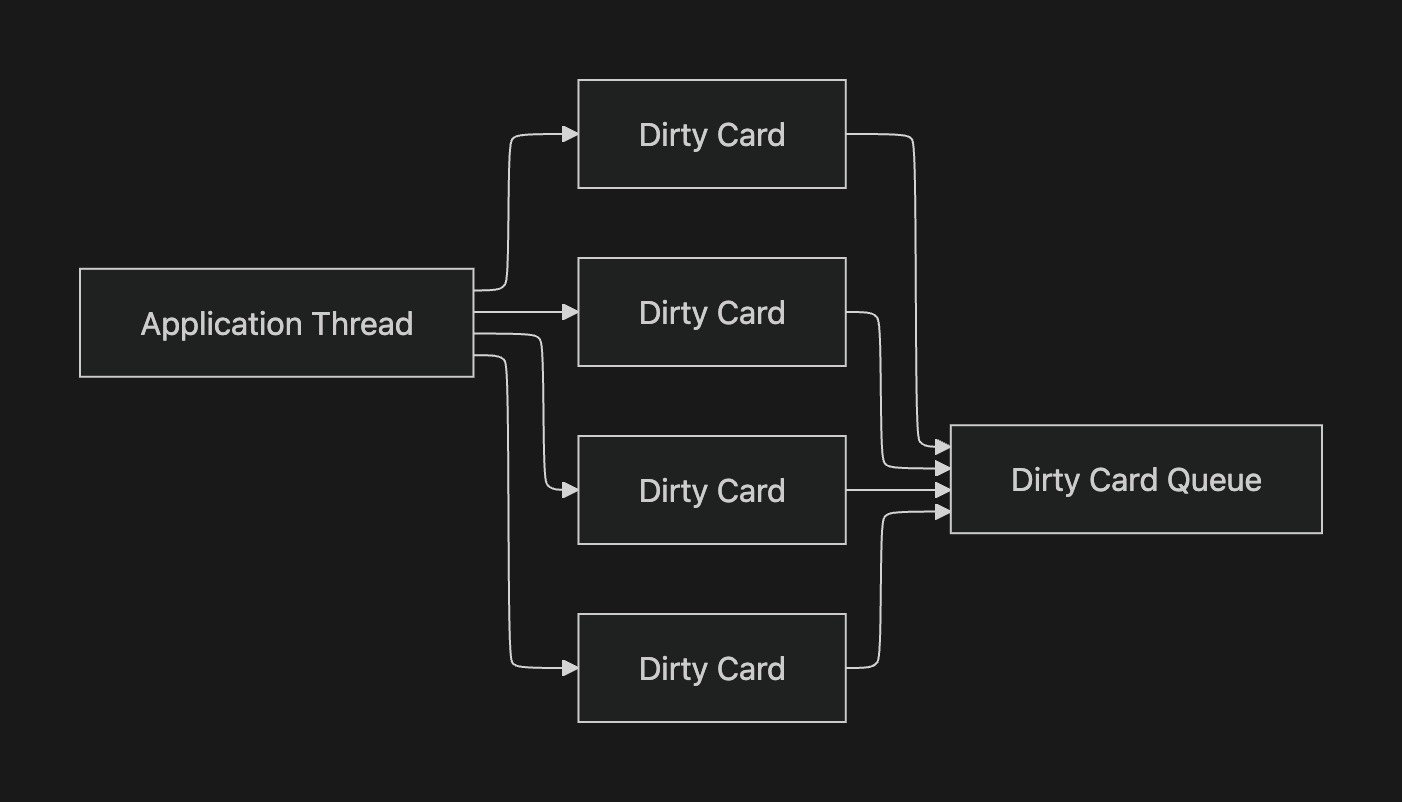
Refinement Thread는 Dirty Card Queue를 비동기로 처리하면서 Remembered Set을 갱신한다.

문제는 Dirty Card 생성 속도가 Refinement Thread의 처리 속도보다 빠를 경우다.
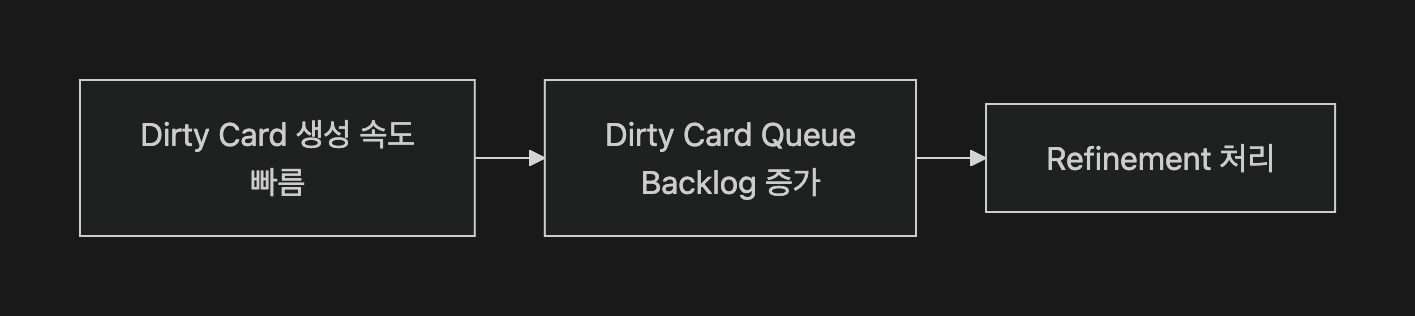
Queue가 계속 쌓인 상태에서 GC Pause가 발생하면 아직 처리되지 않은 Card를 GC가 처리해야 할 수 있다.
결국 Concurrent 영역에서 처리하지 못한 작업이 Pause 시간으로 넘어오는 것이다.
따라서 G1은 backlog가 증가하면 Refinement 작업을 더 적극적으로 수행한다.
그리고 backlog가 일정 수준 이상 증가하면 Application Thread도 일부 Refinement 작업에 참여할 수 있다.
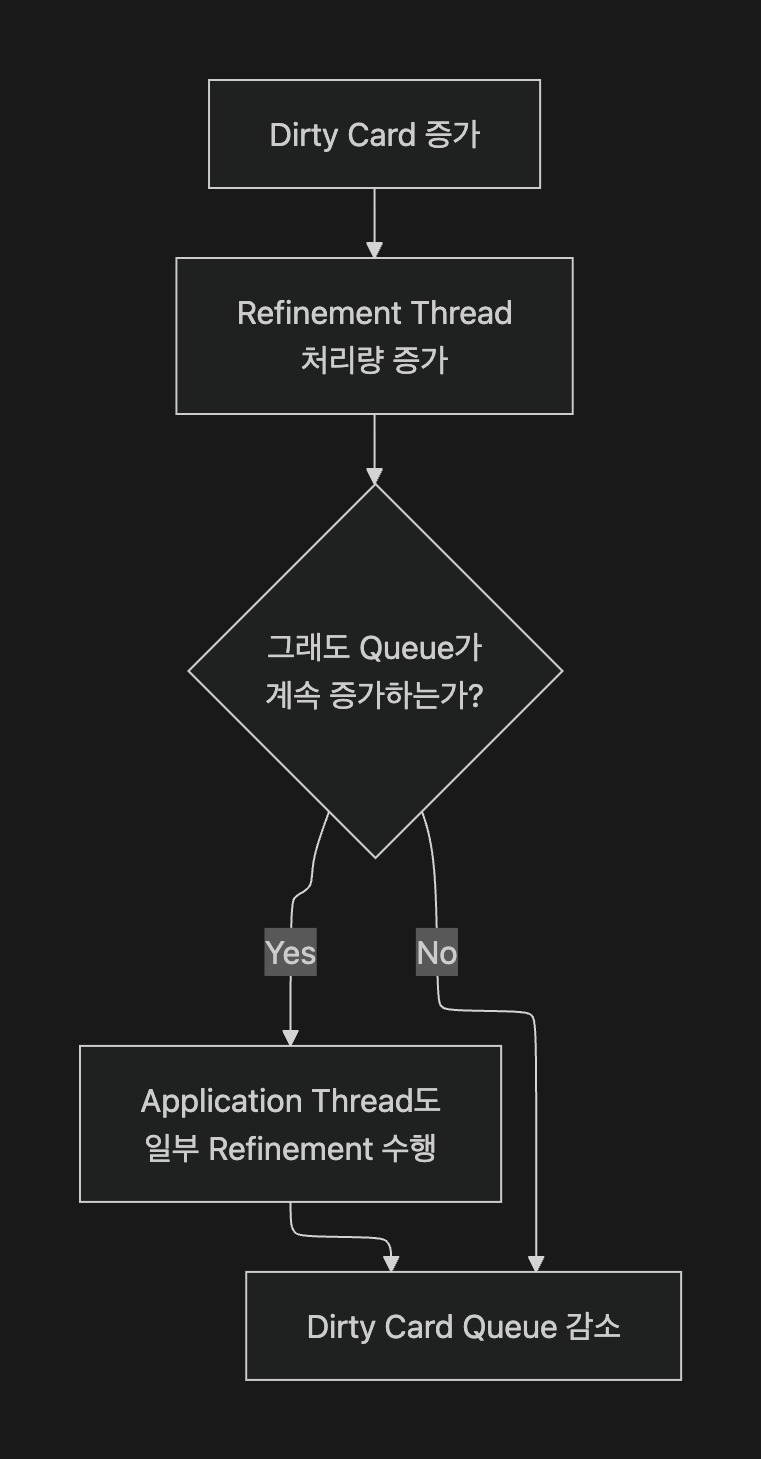
이를 일종의 Back Pressure라고 볼 수 있다. Dirty Card를 생성하는 속도가 너무 빠르면 생성 주체인 Application Thread도 처리 비용을 부담하게 된다. 즉 Refinement는 단순히 Background Thread에게 무한정 떠넘길 수 있는 작업이 아니다.
6-11. Concurrent Mark 전체 흐름
지금까지의 내용을 G1의 전체 GC Cycle에 연결하면 다음과 같다.
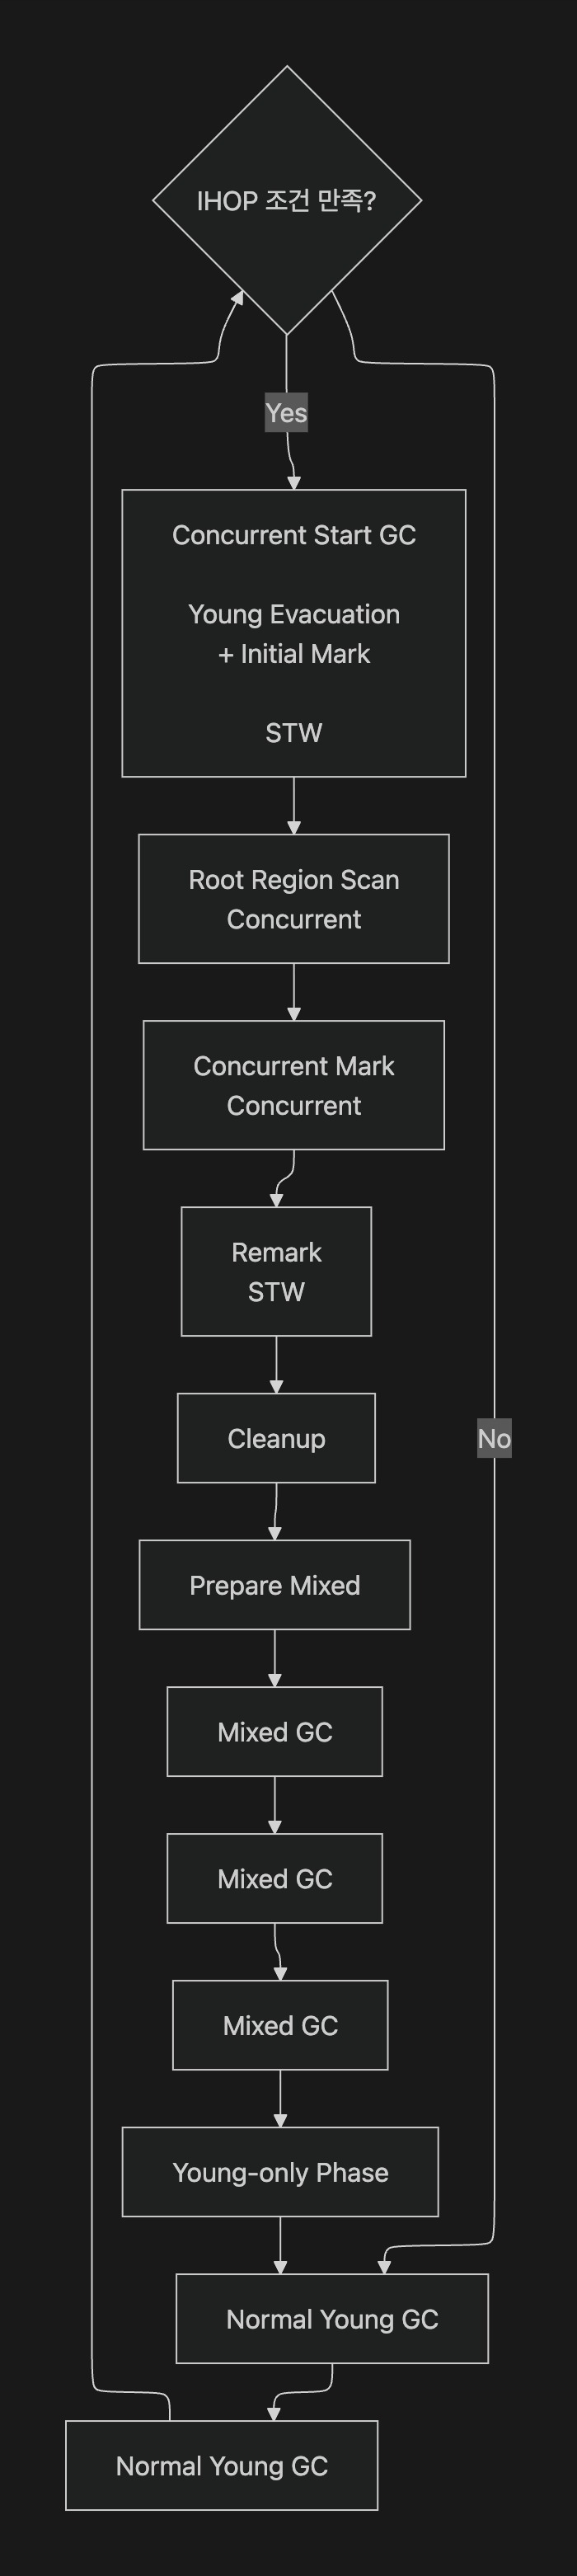
중요한 점은 Concurrent Mark가 수행되는 동안에도 Application은 계속 동작하며 필요하면 Young GC 역시 발생할 수 있다는 것이다. G1의 전체 동작을 크게 나누면 두 Phase가 반복된다고 볼 수 있다.

7. Concurrent Mark 이후 바로 Mixed GC가 시작되는가?
Concurrent Mark가 끝났다고 바로 Mixed GC가 시작되는 것은 아니다. Marking 결과를 최종 확정하고 어떤 Old Region을 회수할지 결정하는 과정이 필요하다. 전체 흐름은 다음과 같다.

7-1. Remark
Concurrent Mark는 애플리케이션과 동시에 수행된다.따라서 Concurrent Mark Thread의 기본 탐색이 끝났다고 해서 모든 Marking 작업이 완전히 끝났다고 볼 수는 없다. 예를 들어 SATB Queue에 아직 처리하지 못한 reference가 남아 있을 수 있다. 따라서 Remark에서는 Application을 잠시 멈춘 뒤 남아 있는 Marking 정보를 처리하고 생존 객체를 최종 확정한다.
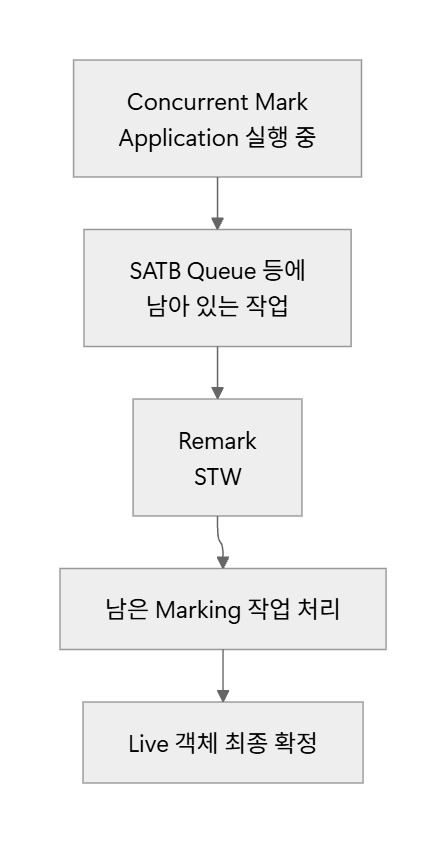
즉 Remark는 Concurrent하게 진행하던 Marking의 마지막 오차를 STW 상태에서 정리하는 단계라고 볼 수 있다.
7-2. Cleanup
Marking이 완료되면 G1은 각 Old Region에 얼마나 많은 Live 객체가 남아 있는지 알 수 있다.
예를 들어 다음과 같다고 하자.
| Region | Live | Garbage | 회수 가능 |
| Region A | 10MB | 90MB | 90MB |
| Region B | 80MB | 20MB | 20MB |
두 Region의 크기가 동일하다면 Region A를 회수하는 편이 훨씬 효율적이다.
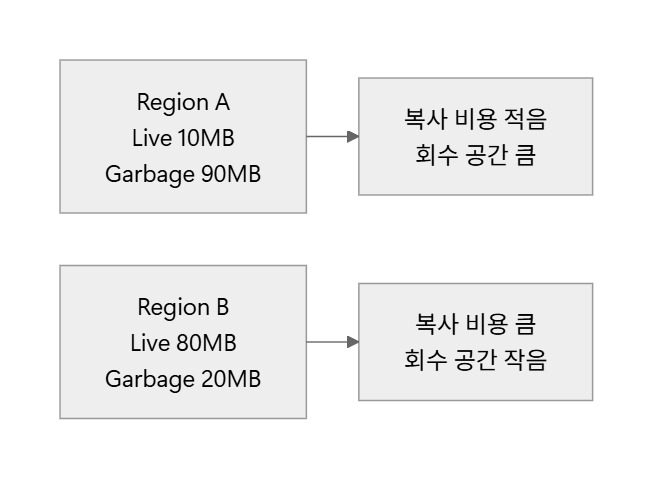
따라서 G1은 Marking 결과를 기반으로 Old Region의 회수 효율을 계산한다.
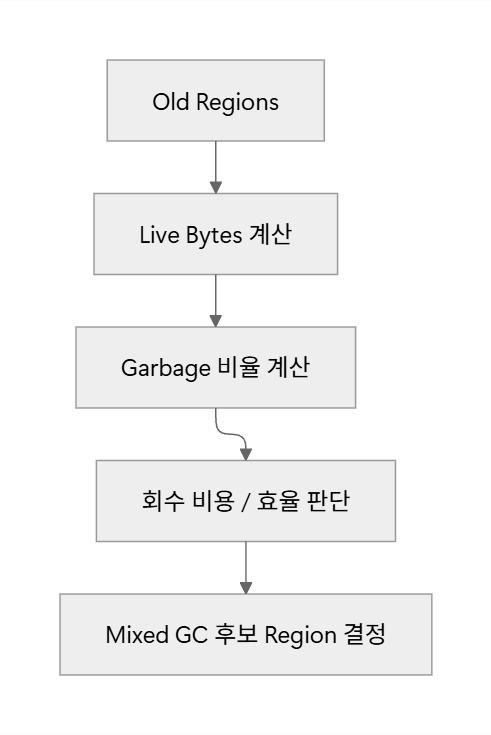
Garbage뿐인 완전히 빈 Region은 즉시 회수할 수도 있다.
7-3. Prepare Mixed
Cleanup 이후 바로 모든 Old Region을 Mixed GC에 넣는 것은 아니다.
G1은 실제 Mixed GC Phase로 들어가기 전에 Mixed GC를 준비하는 단계를 거친다.
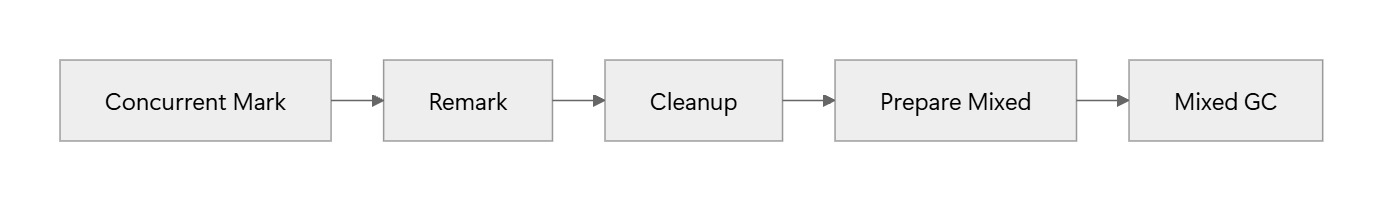
따라서 다음처럼 이해하는 것이 좋다. Concurrent Mark 완료 → 바로 Mixed GC가 아니라,
Concurrent Mark
→ Marking 결과 정리
→ Old Region 후보 준비
→ Mixed GC
이다.
7-4. Mixed GC
Mixed GC는 이름 그대로 Young Region과 일부 Old Region을 함께 Collection Set에 포함하는 GC다.
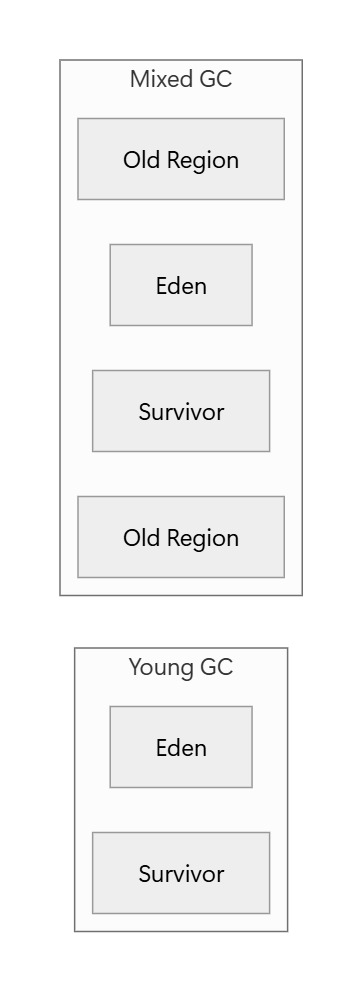
즉, Young GC = Young Regions, Mixed GC = Young Regions + 일부 Old Regions이다.
중요한 점은 모든 Old Region을 한 번에 처리하지 않는다는 것이다. G1의 목표는 Old를 한 번에 최대한 많이 회수하는 것이 아니다. Pause Time 목표를 지키면서 회수 효율이 높은 Old Region을 여러 번에 나눠 처리하는 것이 목적이다.
7-5. 어떤 Old Region이 Mixed GC에 들어가는가?
Concurrent Mark가 끝나면 G1은 각 Old Region의 Live 정보를 알고 있다.
예를 들어 다음과 같다고 하자.
| Region | Live | Garbage |
| Region A | 10% | 90% |
| Region B | 30% | 70% |
| Region C | 90% | 10% |
회수 효율만 본다면 Region A가 가장 좋다.
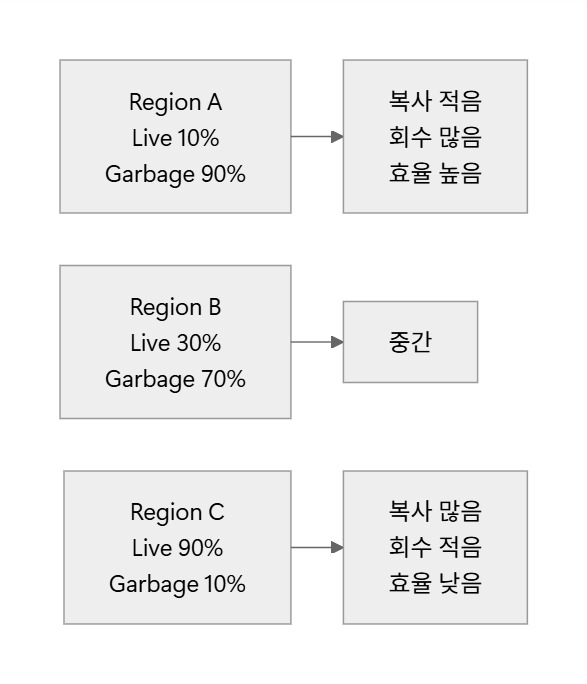
G1은 이러한 정보를 기반으로 회수 효율이 높은 Old Region을 Mixed GC 후보로 선택한다.
7-6. Mixed GC 역시 Pause Time을 고려한다
Mixed GC에서는 Young Region과 선택된 Old Region이 Collection Set에 포함된다.
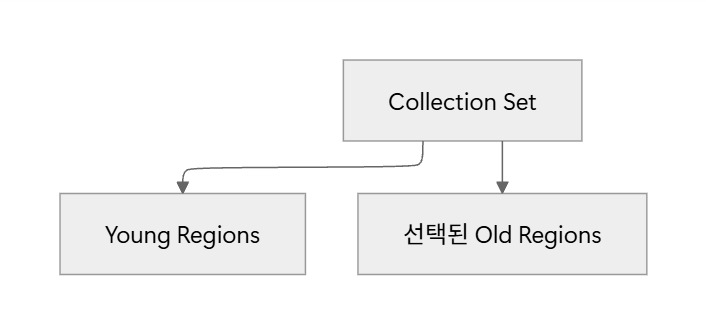
하지만 Old Region을 많이 포함할수록 복사해야 할 Live 객체도 증가한다. 즉 Collection Set을 크게 만들면 Pause Time 역시 길어질 가능성이 높다. 따라서 G1은 목표 Pause Time을 기준으로 Collection Set의 크기를 조절한다.
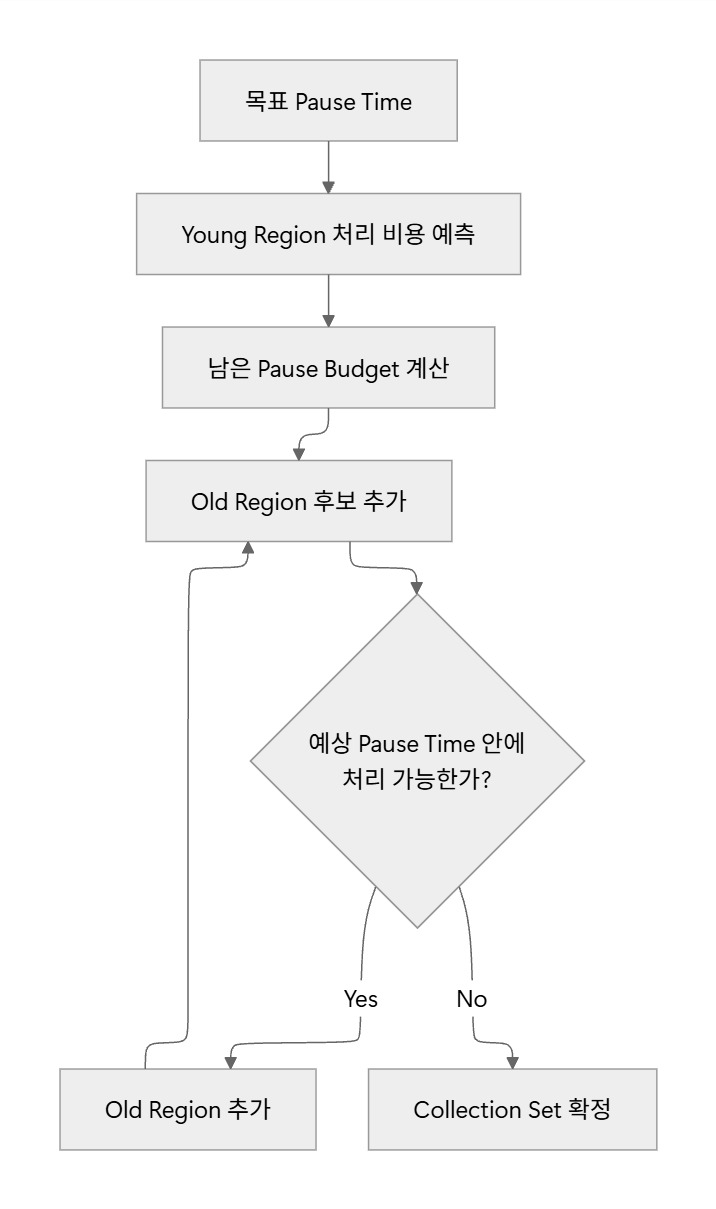
즉 Mixed GC 역시 G1의 기본 정책인 Pause Time을 예측하고 제어한다라는 목표를 그대로 따른다.
7-7. Mixed GC는 여러 번 수행된다
Old Region은 한 번의 Mixed GC에서 전부 회수되지 않는다.
예를 들어 다음처럼 여러 번에 나눠 처리할 수 있다.
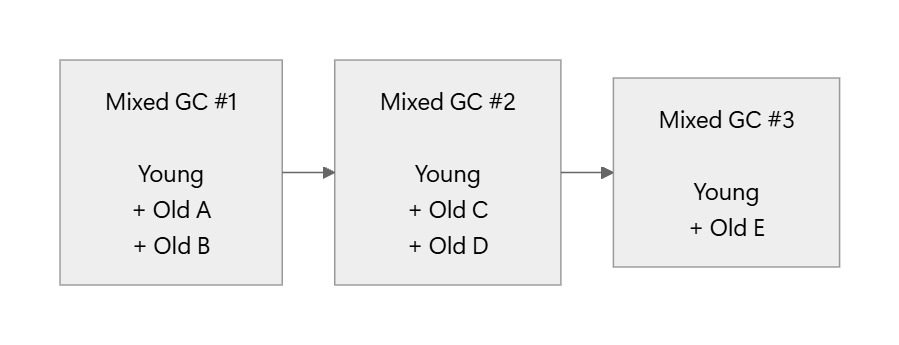
이를 통해 G1은 매우 긴 한 번의 Pause 대신 Old Region을 여러 번에 걸쳐 점진적으로 회수한다.
7-8. Mixed GC는 언제 끝나는가?
Mixed GC를 반복하면 Garbage 비율이 높은 Old Region부터 점점 사라진다.
초기에는 다음처럼 회수 효율이 높은 Region이 많다.
Garbage 90%
Garbage 80%
Garbage 70%
하지만 Mixed GC가 진행될수록 남은 Region은 다음처럼 회수 효율이 낮아질 수 있다.
Garbage 20%
Garbage 15%
Garbage 10%
즉 Live 객체를 복사하는 비용에 비해 회수할 수 있는 공간이 줄어든다.
전체 흐름을 보면 다음과 같다.
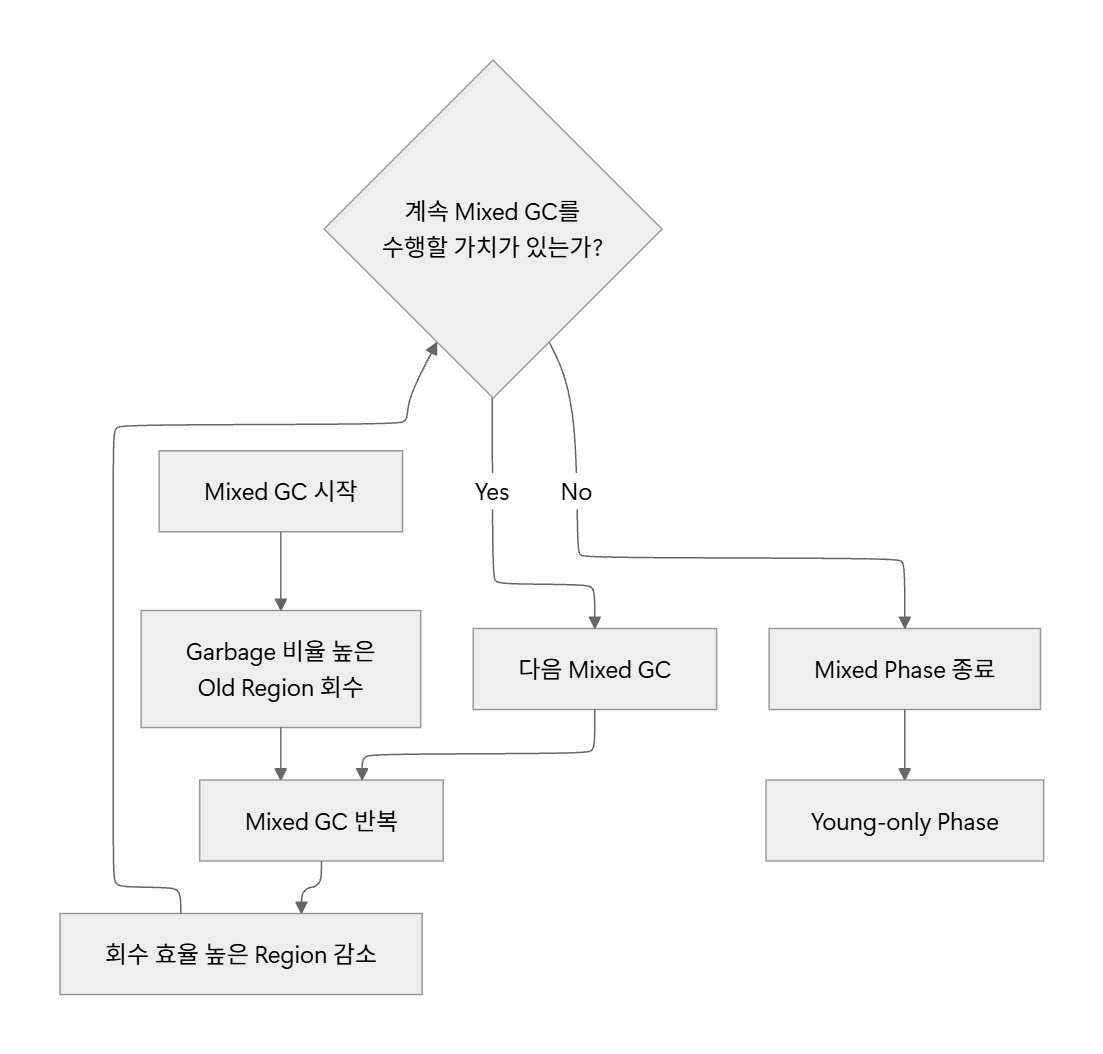
이후 Old 영역이 다시 증가하면 새로운 Concurrent Mark Cycle이 시작된다.

결국 G1은 이 Cycle을 반복하면서 Heap을 관리한다.
정리
G1의 Concurrent Mark와 Mixed GC 흐름을 한 문장으로 정리하면 다음과 같다. Old 영역이 부족해지기 전에 Concurrent Mark를 시작하고, SATB를 이용해 Application과 동시에 객체의 생존 여부를 조사한 뒤, 회수 효율이 높은 Old Region을 골라 여러 번의 Mixed GC를 통해 Pause Time 목표 안에서 점진적으로 회수한다. 전체 구조는 다음 그림으로 정리할 수 있다.
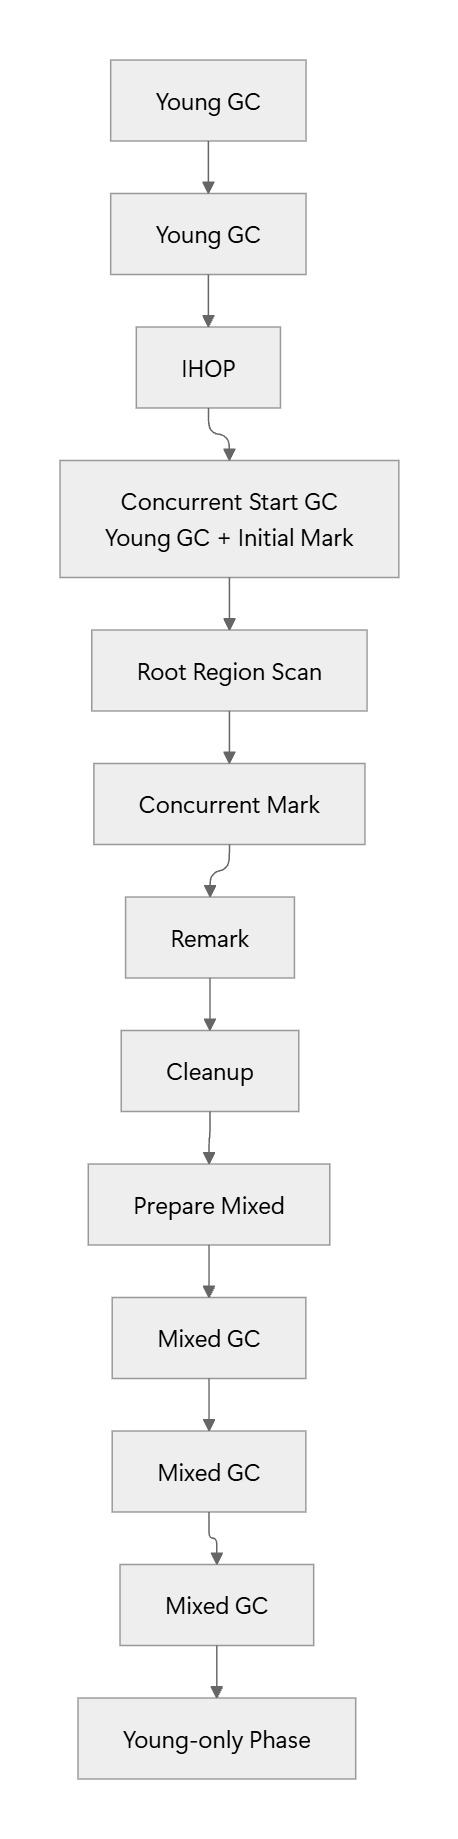
각 기술의 역할은 다음과 같이 정리할 수 있다.
기술역할
| IHOP | Concurrent Mark를 언제 시작할지 결정 |
| Initial Mark | Concurrent Mark의 시작점 설정 |
| Tri-color Marking | 객체의 Marking 상태를 이해하기 위한 모델 |
| SATB | Concurrent Mark 도중 기존 Live 객체를 놓치지 않도록 함 |
| TAMS | Mark 시작 이후 생성된 객체 영역을 구분 |
| Refinement Thread | Dirty Card를 처리해 RSet 갱신 |
| Remembered Set | 다른 Region에서 들어오는 reference 추적 |
| Mixed GC | Garbage 비율이 높은 Old Region을 Young과 함께 회수 |
'Java & Kotlin' 카테고리의 다른 글
| [JVM] G1 GC (1) | 2026.09.02 |
|---|---|
| [JVM] GC 알고리즘의 역사 (0) | 2026.09.01 |
| [JVM] JIT(Just-In-Time) 컴파일러의 발전과정 알아보기 - 1 (0) | 2026.08.27 |