[JVM] JIT(Just-In-Time) 컴파일러의 발전과정 알아보기 - 1
"자바는 느리다."
한 번쯤 들어봤을 말이다. 그런데 요즘 자바로 짠 서버가 느려서 문제가 되는 경우는 별로 없다. 언어 문법이 크게 바뀐 것도 아닌데, 그 사이에 무슨 일이 있었던 걸까?
그 간극을 메운 것이 바로 JIT 컴파일러다.
JIT 컴파일러란?
JIT(Just-In-Time) 컴파일러는 프로그램이 실행되는 도중에, 자주 실행되는 코드를 네이티브 기계어로 번역해 두고 재사용하는 컴파일러다.
번역을 "미리" 하지도, "매번" 하지도 않고 필요한 순간에(just in time) 한다는 것이 이름의 뜻이다.
| 방식 | 번역 시점 | 특징 |
|---|---|---|
| 컴파일 (AOT) | 실행 전에 전부 | 빠르지만 플랫폼마다 다시 컴파일해야 함 |
| 인터프리터 | 실행하면서 매번 | 이식성은 좋지만 느림 |
| JIT | 실행 중, 자주 쓰이는 부분만 | 인터프리터로 시작해 뜨거운 코드만 기계어로 |
말로만 보면 당연한 아이디어 같지만, JIT은 자바의 시작부터 있던 기능이 아니다. 오히려 자바가 처음에 택했던 방식의 한계를 메우려고 뒤늦게 등장한 기술에 가깝다. 그래서 JIT의 발전과정을 이해하려면, 그 출발점부터 봐야 한다.
출발점: JVM은 인터프리터였다
자바는 원래 셋톱박스나 리모컨 같은 소형 가전에 넣으려고 만들어진 언어다. 이런 기기들은 CPU 아키텍처가 제각각인 데다 그 위에 올라가는 운영체제도 제조사마다 달랐으며 심지어 다음 모델에서 아무렇지 않게 칩을 갈아치우기도 하였다. 이러한 상황에서C 같은 컴파일 언어는 소스를 곧바로 특정 환경의 기계어로 번역하기 때문에 아키텍처나 운영체제가 바뀌면 그때마다 다시 컴파일해야 한다. 지원할 기기가 늘어날수록 따로 관리해야 할 빌드도 같이 늘어난다는 뜻이다. 그래서 자바는 한 번 만든 코드가 어떤 환경에서도 그대로 돌아가는 것(Write Once Run Anywhere) 을 최우선 목표로 잡았다.
이를 위해 자바는 실제 CPU 대신 가상의 CPU(JVM) 를 정의하고 javac는 그 가상 CPU용 기계어인 바이트코드만 만들도록 했다. 물론 가상의 CPU용 기계어이니 실제 CPU는 이걸 이해하지 못한다. 그래서 CPU와 운영체제 조합마다 바이트코드를 대신 읽어서 실행해 주는 JVM을 따로 만들어 둔다. 새로운 환경이 생겨도 거기에 맞는 JVM 하나만 포팅하면 되고, 이미 만들어진 .class 파일은 손댈 필요가 없다. 조합마다 다시 컴파일해야 하는 부담을 개발자가 아니라 JVM 쪽으로 옮겨 놓은 것이다.
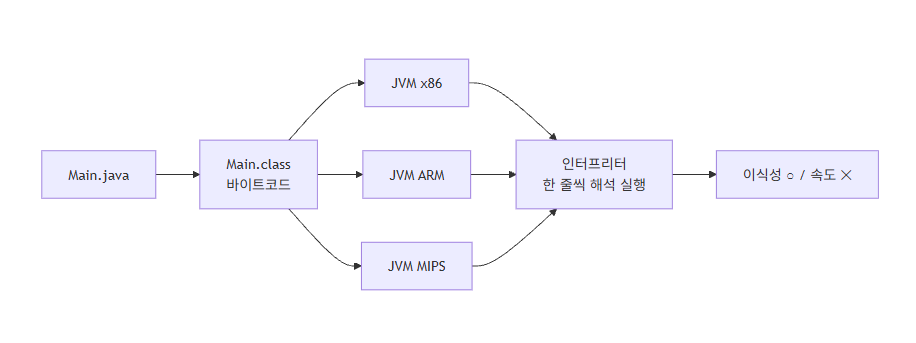
문제는 그 JVM이 바이트코드를 한 줄씩 읽어서 해석해 실행하는 인터프리터였다는 점이다. 인터프리터는 그냥 평범한 C 코드라 어떤 플랫폼에든 쉽게 올릴 수 있었으니 이식성이라는 목표에는 완벽했다. 대신 명령어마다 읽고 판별하고 실행하는 비용이 붙고, 반복문 안에서 같은 코드를 백만 번 돌려도 매번 똑같이 해석한다. 최적화라는 개념 자체가 없었다.
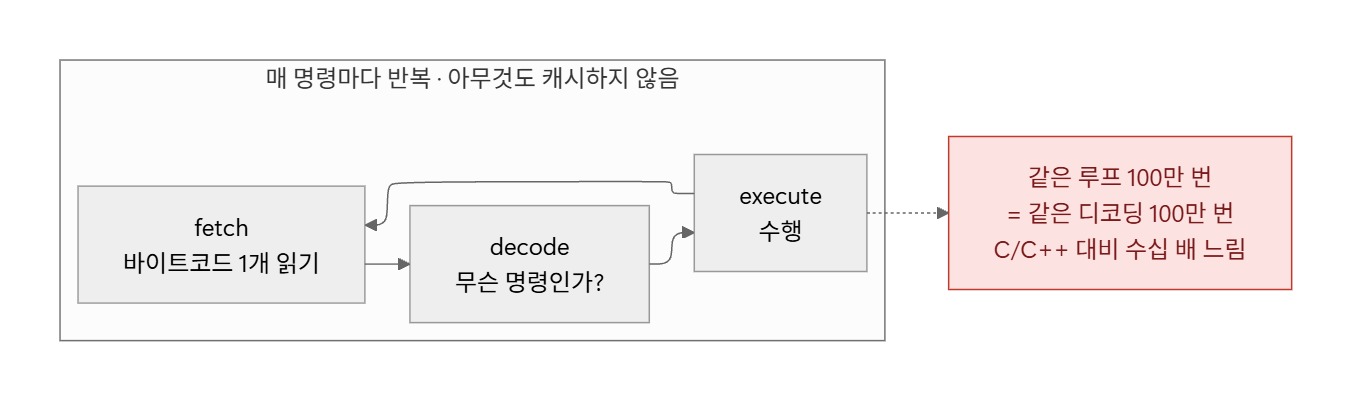
자바가 한동안 "느린 언어"로 불린 이유가 여기에 있다. 이식성을 얻은 대가를 성능으로 치르고 있었던 것이다.
웹 붐: 문제가 드러나다
정작 가전 사업은 잘 풀리지 않았지만, 그 사이 웹이 폭발적으로 성장했다. 그런데 웹의 요구사항은 셋톱박스의 요구사항과 사실상 같았다. 어떤 기기인지 모르는 남의 컴퓨터에서 코드가 돌아가야 하고, 네트워크로 내려받아야 하니 코드가 작아야 한다. 자바가 이미 갖춘 조건이었다. 1995년 넷스케이프가 애플릿(Applet)1 을 지원하게 되면서 자바는 웹의 언어가 되었으며 1996년 JDK 1.0이 정식 출시된다.
문제는 여기서 드러났다. 가전 펌웨어와 달리 애플릿1은 사용자가 화면을 보며 기다리는 코드였다. 인터프리터의 느림이 그대로 체감된 것이다. 이식성 덕분에 웹에 올라탔는데, 정작 그 이식성을 위해 치른 비용 때문에 욕을 먹는 상황이 됐다. 그래서 JVM은 이식성을 포기하지 않으면서 속도를 되찾는 방향으로 발전하기 시작한다.
1단계 — JIT 컴파일러의 등장 (JDK 1.1, 1997)
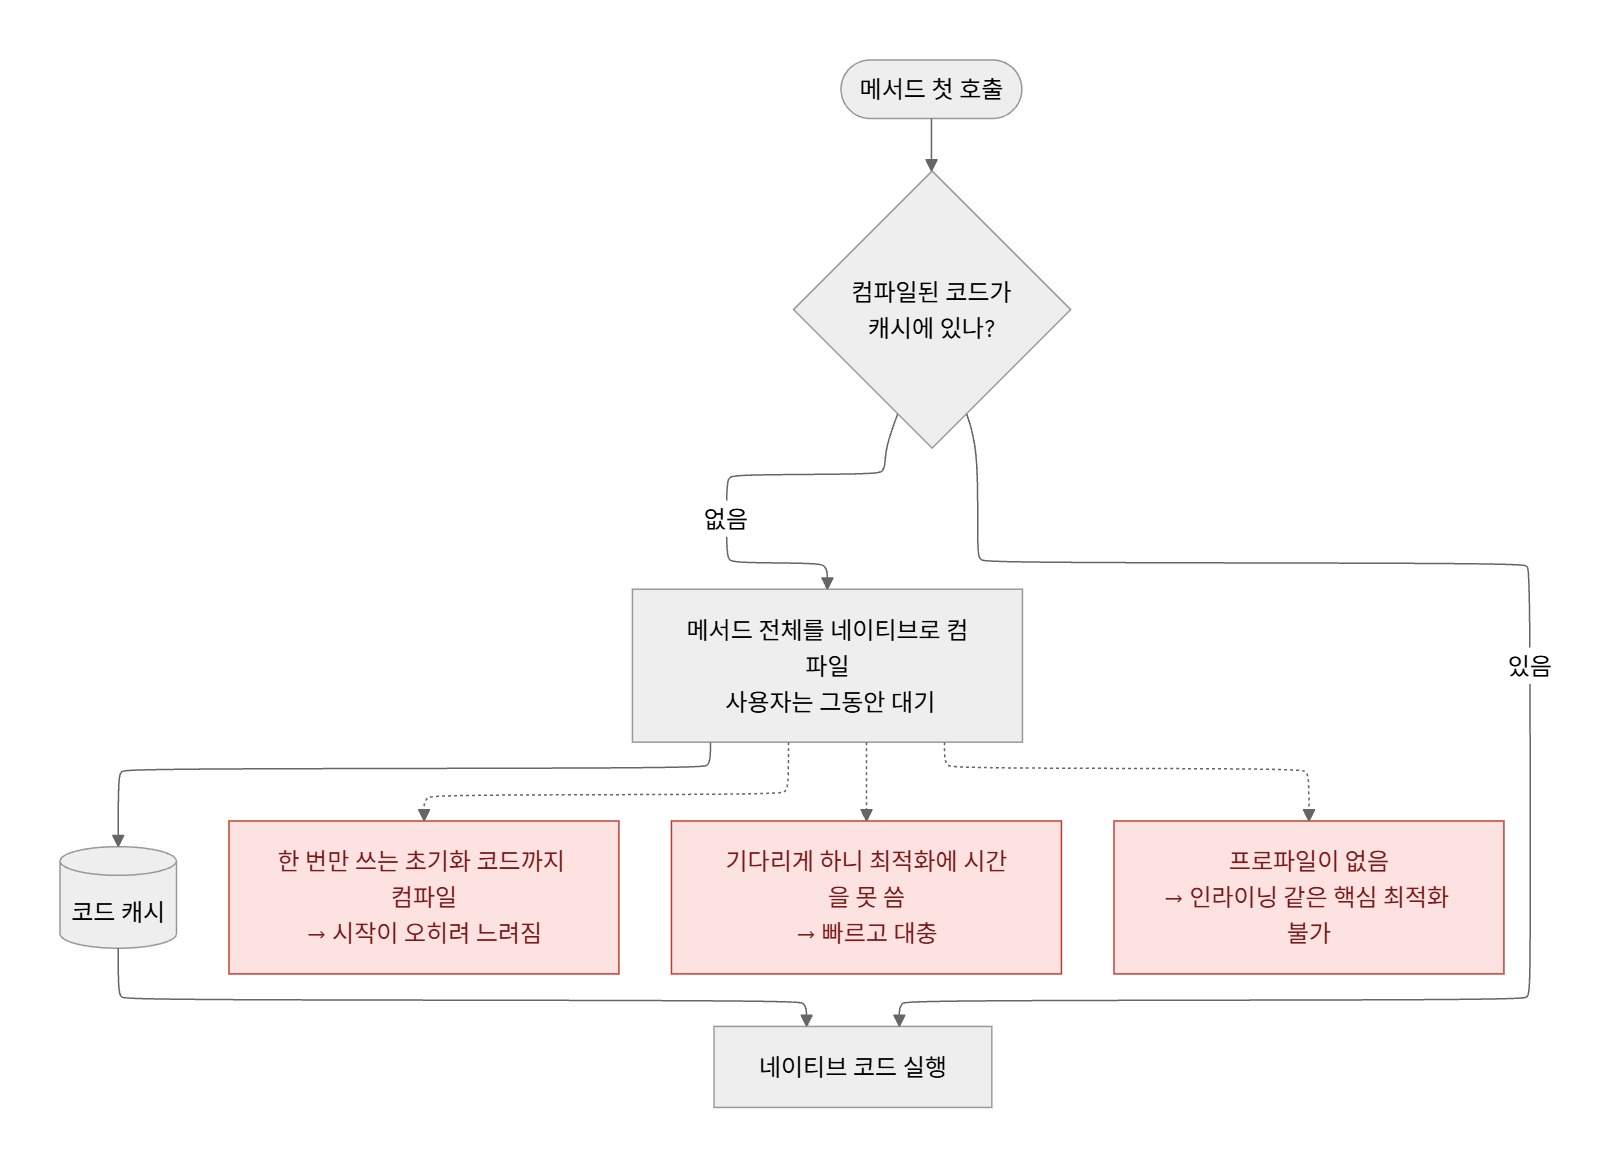
가장 단순한 해법이 먼저 나왔다. 매번 해석하지 말고, 통째로 기계어로 컴파일해서 저장해 두자. 메서드가 처음 호출되는 순간 그 메서드 전체를 네이티브 코드로 컴파일해 캐시하고, 이후엔 캐시된 네이티브 코드를 직접 실행한다. 이렇듯 필요한 순간에 컴파일한다고 해서 Just-In-Time이다.
효과
반복 실행 비용이 사라져 인터프리터보다 몇 배에서 10배 가까이 빨라졌다.
남은 불편함
1.모든 메서드를 첫 호출에 컴파일한다.
딱 한 번 실행되고 끝날 초기화 코드까지 컴파일 비용을 낸다. 컴파일 비용이 실행 비용보다 큰 코드가 대부분이라, 오히려 시작 시간이 느려졌다. 메서드 하나에 30ms가 든다고 치면 메서드 3,000개짜리 애플리케이션은 컴파일에만 90초를 쓰는 셈이다.
2.사용자가 기다리는 동안 컴파일한다.
최적화에 시간을 쓸 수 없으니 바이트코드를 거의 그대로 옮기는 수준에 그쳤고 코드 품질에 한계가 생겼다. 인터프리터와 병행할 수도 없어서 처음 실행하는 사용자는 컴파일이 끝날 때까지 그냥 기다려야 했다.
3.프로파일 정보가 없다.
어느 분기를 자주 타는지, 이 호출 지점에 실제로 어떤 타입이 오는지 모르는 채로 컴파일한다. 그래서 인라이닝 같은 핵심 최적화를 할 수 없었다.
4.넷째, 번역된 네이티브 코드가 메모리를 잔뜩 차지한다.
5.여기에 자바 특유의 문제
자바는 메서드가 잘게 쪼개져 있고, 평범한 인스턴스 메서드가 전부 가상 호출이다. 즉 인라이닝이 가장 절실한 언어인데, 정보가 없어서 그걸 못 하는 상황이었다.
여담 — 왜 인라이닝이 "최적화의 어머니"인가
메서드 호출 자체에 비용이 있다.CPU 입장에서 보면 인자들을 정해진 위치에 옮기고, 돌아올 주소를 저장하고, 호출된 쪽으로 점프하고, 스택 프레임을 새로 만들고, 끝나면 반환값을 챙겨 되돌아와야 한다. 프레임이 정확히 무엇이고 호출 때마다 어떻게 만들어지는지는 JVM 명세 2.6 Frames에 정리되어 있다. 인라이닝은 "호출하지 말고, 호출되는 쪽의 본문을 그 자리에 붙여넣자"는 최적화다.
// 원래 코드
int d = p.getX() - q.getX();

// 인라이닝 후 (컴파일러가 내부적으로 이렇게 변환)
int d = p.x - q.x;
호출 오버헤드가 통째로 사라졌다. 그런데 인라이닝의 진짜 위력은 그게 아니다. 인라이닝은 다른 최적화의 문을 여는 열쇠다.컴파일러의 최적화(불필요한 계산 제거, 경계 검사 제거 등)는 기본적으로 한 메서드 안에서만 작동한다. 메서드 호출은 컴파일러 입장에서 "저 너머에서 무슨 일이 일어나는지 모르는 벽"이다. 코드가 잘게 쪼개져 있으면 벽이 사방에 있어서 최적화할 공간 자체가 없다. 인라이닝으로 벽을 허물면 여러 메서드가 하나의 큰 코드 덩어리가 되고, 그제서야 컴파일러가 전체를 보면서 "이 계산은 중복이네", "이 검사는 필요 없네" 하고 다듬을 수 있다. 그래서 인라이닝을 최적화의 어머니(mother of all optimizations)부른다.
그런데 가상 호출이 이걸 막는다.
Shape s = ...;  // Circle일 수도, Square일 수도 있음
s.area(); // 어느 area()가 실행될까?s.area()가 Circle.area()인지 Square.area()인지는 실행 시점에 s에 실제로 뭐가 들어있는지 봐야 안다. 그래서 컴파일된 코드는 매번 "이 객체의 실제 클래스가 뭐지? → 그 클래스의 메서드 테이블에서 area()의 주소를 찾자 → 그 주소로 점프"를 거친다. 이렇게 목적지가 실행 시점에 결정되는 호출이 가상 호출이다.
반대말은 정적 호출이다. C의 함수 호출처럼 목적지가 컴파일 시점에 딱 정해져 있는 것. 자바에서는 static, private, final 정도만 여기 해당하고, 평범한 인스턴스 메서드는 전부 기본이 가상 호출이다. C++은 virtual을 붙여야 가상인데, 자바는 반대로 기본이 가상이다.
가상 호출이 인라이닝을 막는 이유는 단순하다. 인라이닝은 "본문을 복사해 넣기"인데, 목적지를 모르면 뭘 복사해 넣을지 알 수 없다. s.area() 자리에 Circle.area()를 넣을지 Square.area()를 넣을지 컴파일 시점엔 결정되지 않는다.
2단계 — HotSpot: 관찰하고 뜨거운 곳만 컴파일
1단계의 문제는 한 문장으로 요약된다.
메서드 첫 호출 시점에 · 실행을 멈추고 · 전체를 컴파일한다
세 조건이 전부 문제였다. 그래서 셋 다 뒤집는다.
핵심 통찰은 90/10 법칙이다. 실행 시간의 대부분은 극히 일부 코드에서 소비된다. 그러니 전부 컴파일하지 말고, 그 뜨거운 지점(hot spot) 만 찾아서 정성껏 컴파일하자.
여담 — 90/10 법칙은 어디서 왔나
"프로그램 실행 시간의 90%는 전체 코드의 10%에서 소모된다"는 경험 법칙이다. 문헌마다 90/10으로도, 80/20으로도 쓴다. 정확한 수치가 중요한 게 아니라 극소수 코드가 대부분의 시간을 먹는다는 비대칭이 핵심이기 때문이다.
이건 이론적으로 유도된 게 아니라 실제 프로그램을 프로파일링해 보니 반복적으로 관찰된 사실이다. 기원으로 가장 자주 인용되는 건 도널드 크누스의 1971년 논문 An Empirical Study of FORTRAN Programs다. 스탠퍼드 전산 센터에서 실제로 돌던 포트란 프로그램 수백 개를 분석했더니, 실행 시간의 대부분이 전체 소스의 4% 미만 문장에 집중되어 있었다. 대부분 안쪽 반복문 몇 개였다.
매커니즘
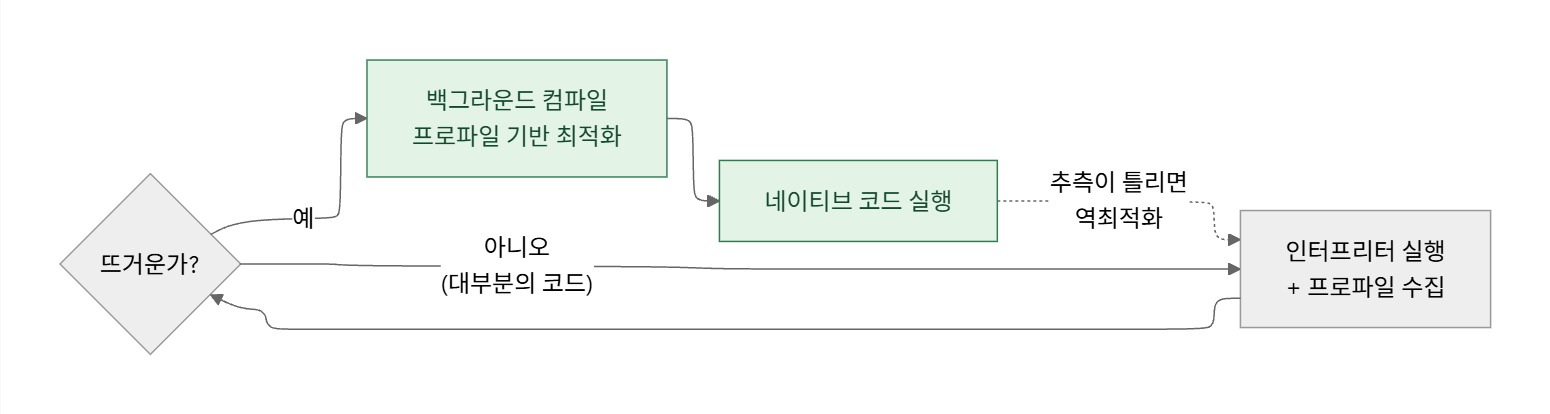
1단계의 문제 하나하나에 대응한다.
1. 인터프리터로 시작한다.
컴파일 비용 없이 즉시 실행되니 기동이 빠르다. 인터프리터 자체도 템플릿 인터프리터로 개선됐는데, VM 시작 시 각 바이트코드에 대응하는 기계어 조각을 미리 만들어 두고 점프하는 방식이라 switch문보다 훨씬 빠르다.
여담 — 템플릿 인터프리터란
초기 JVM의 인터프리터는 C로 작성된 거대한 switch문이었다.
while (true) {
    opcode = *pc++;              // fetch
    switch (opcode) {            // decode
        case ILOAD_1: push(locals[1]);                    break;  // dispatch
        case ILOAD_2: push(locals[2]);                    break;
        case IADD:    b = pop(); a = pop(); push(a + b);  break;
        case IRETURN: return pop();
        ...
    }
}
이 구조에는 두 가지 낭비가 있다. 명령어 하나를 처리할 때마다 거대한 switch로 돌아와 분기해야 하고, 그 분기의 목적지가 매번 달라서 CPU의 분기 예측이 거의 항상 빗나간다. 예측이 빗나가면 파이프라인을 비우고 다시 채워야 하니, 정작 하려던 덧셈보다 분기 비용이 더 큰 상황이 벌어진다.
템플릿 인터프리터는 이 중앙 switch를 없앤다. VM이 시작될 때 각 바이트코드에 대응하는 기계어 조각(template) 을 미리 생성해 테이블에 넣어두고, 조각의 마지막에 "다음 바이트코드의 조각으로 점프"하는 코드를 붙여둔다.
[iload_1 조각] → [iload_2 조각] → [iadd 조각] → [ireturn 조각]
   기계어           기계어           기계어          기계어
   (끝에서 바로 다음 조각으로 점프 — 중앙 루프로 돌아가지 않음)
돌아올 중앙 루프가 없으니 분기 지점이 명령어마다 흩어지고, 그러면 CPU의 분기 예측기가 각 지점별로 패턴을 학습할 수 있게 된다. 해석 방식은 그대로인데 해석하는 비용 자체가 크게 줄어든 것이다.
2. 카운터로 뜨거운 코드를 찾는다.
- 호출 카운터: 이 메서드가 호출될 때마다 +1
- 백엣지 카운터: 이 메서드 안의 루프가 한 바퀴 돌 때마다 +1
임계값을 넘으면 컴파일 큐에 넣는다.
3. 컴파일은 백그라운드에서 한다.
큐에 넣고는 그냥 인터프리터로 계속 실행한다. 별도의 컴파일러 스레드가 다른 코어에서 여유 있게 컴파일하고, 끝나면 코드 주소를 등록한다. 다음 호출부터 컴파일된 코드로 실행된다. 사용자가 멈춰 서서 기다리는 구간이 사라졌다.
4. OSR(On-Stack Replacement).
3 의 규칙에는 구멍이 하나 있다. "다음 호출부터 컴파일된 코드로 실행된다"는 건, 뒤집으면 다음 호출이 없으면 영원히 적용되지 않는다는 뜻이다.
public static void main(String[] args) {
    long sum = 0;
    for (int i = 0; i < 1_000_000_000; i++) {   // 10억 번 도는 루프
        sum += compute(i);
    }
    System.out.println(sum);                     // 루프가 끝나야 여기 도달
}main은 딱 한 번 호출됐다. 호출 카운터는 영원히 1이다. 그런데 이 프로그램이 쓰는 시간의 99.9%가 저 루프 안에 있다. 백엣지 카운터가 아무리 치솟아도 다음 호출이 없으니 컴파일된 코드로 갈아탈 기회가 오지 않는다. 그래서 루프가 도는 도중에 실행을 갈아탄다. 이것이 OSR이다.
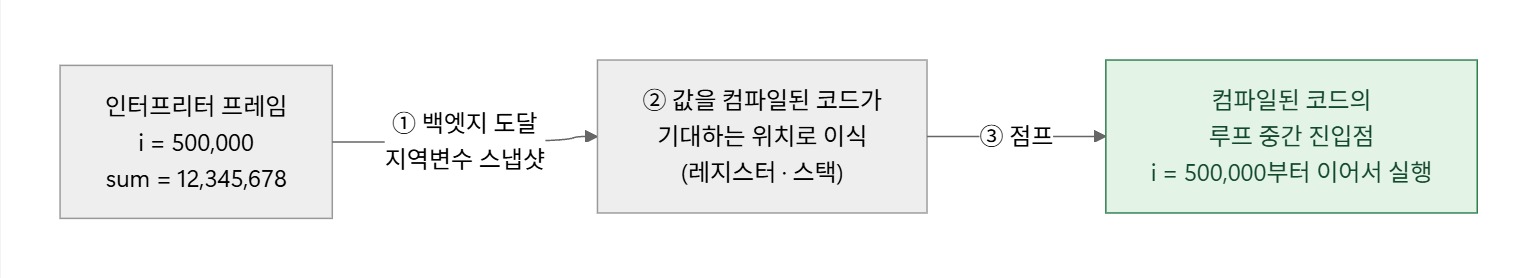
백엣지 카운터가 임계값을 넘으면 컴파일러는 메서드 처음이 아니라 루프 중간부터 시작할 수 있는 특별한 진입점을 가진 코드를 만든다. 인터프리터가 백엣지에 도달한 순간 지역변수 값을 그대로 옮겨 심고 그 진입점으로 점프하면 루프는 아무 일 없었다는 듯 이어서 돌되 이제 네이티브 코드로 돈다.
5. 프로파일 기반 추측 최적화.
- 타입 추측 인라이닝:
list.get(i)지점에 지금까지ArrayList만 왔다면, "ArrayList가 맞는지 검사 한 번 +ArrayList.get의 본문을 직접 넣기"로 컴파일한다. 가상 호출의 벽이 사라지고 인라이닝 연쇄가 시작된다. - 안 타는 분기는 코드를 아예 만들지 않는다.
- 경계 검사 제거: 자바는 배열 접근마다 인덱스 범위를 검사하는데, 루프 프로파일과 결합하면 "이 루프에서 어디부터 어디까지만 움직인다"를 증명해 검사를 통째로 들어낼 수 있다.
- 이건 정적 컴파일러가 할 수 없는 일이다. 미리 컴파일하는 방식은 "지금까지 항상 이랬다"는 관찰 자체가 불가능하기 때문이다. 실행 중에 컴파일하기 때문에 오히려 더 빠를 수 있다는 JIT의 역설이 여기서 나온다.
6. 역최적화(Deoptimization).
추측은 틀릴 수 있다. 새 클래스가 로드돼 다른 타입이 등장하거나, 안 타던 분기에 진입하면 어떻게 될까.
- 1.컴파일된 코드에 심어둔 검사가 실패를 감지한다 — "어? 클래스가
ArrayList가 아니네" - 2.실행을 멈추고 컴파일된 코드의 현재 상태를 인터프리터가 이해하는 상태로 번역한다. 여기가 기술적으로 제일 어렵다. 최적화된 코드는 변수를 레지스터에 흩어놓고, 인라이닝 때문에 여러 메서드가 한 덩어리로 뭉쳐 있다. 그래서 컴파일러는 코드 요소요소에 이 지점에서 각 변수가 어디에 있는지의 지도를 메타데이터로 남겨둔다.
- 3.그 지도를 보고 인터프리터 스택 프레임을 재구성한다. 인라이닝됐던 메서드들은 각각의 프레임으로 다시 펼치고, 레지스터의 값들은 인터프리터가 기대하는 스택 위치로 옮긴다.
- 4.인터프리터가 정확히 그 지점부터 실행을 이어받는다. 프로그램 입장에선 아무 일도 없었던 것처럼.
- 5.문제의 코드는 폐기하거나 재컴파일 대상으로 표시하고, 새 관찰을 반영해 나중에 다시 컴파일한다.
7. 그런데 이 "컴파일러"는 하나가 아니다.
지금까지 "컴파일한다"고 뭉뚱그려 말했지만, 정작 컴파일러를 만들려고 보면 곧바로 벽에 부딪힌다. 얼마나 공들여 컴파일할 것인가. 컴파일러는 두 가지를 맞바꾼다. 컴파일에 쓰는 시간과 나오는 코드의 품질이다. 대충 만들면 금방 나오지만 느리고, 정성껏 만들면 빠르지만 오래 걸린다. 문제는 어느 쪽이 이득인지가 프로그램마다 정반대라는 것이다. 클릭에 반응해야 하는 GUI 프로그램은 컴파일에 500ms를 쓰는 순간 손해지만, 몇 주씩 떠 있는 서버는 처음 1분을 태워서라도 최고의 코드를 얻는 게 남는 장사다.
그래서 HotSpot은 성격이 정반대인 컴파일러를 아예 두 개 만들었다. 빨리 만드는 C1과, 잘 만드는 C2다. 그리고 이 시점에는 둘을 섞어 쓸 방법이 없었다. VM을 띄울 때 둘 중 하나를 골라야 했다.
java -client MyApp   # C1만 사용
java -server MyApp   # C2만 사용
옛날 자바 문서에 "운영 서버에서는 반드시 -server 옵션을 주라"는 조언이 반복해서 나오는 게 이 때문이다. 안 주면 기동만 빠르고 최종 성능은 절반에 머무는 코드로 몇 주를 돈다.
여담 — HotSpot 기술의 뿌리: Self와 Animorphic
HotSpot의 핵심 기술은 자바를 위해 발명된 게 아니다. 스탠퍼드와 Sun 연구소에서 만든 Self라는 연구용 언어에서 나왔다. Self는 자바보다 훨씬 극단적이었다. 모든 것이 객체고, 심지어 if문이나 정수 덧셈조차 메시지(가상 호출)로 처리했다. 즉 모든 호출이 가상 호출이라 정적 최적화가 불가능한 언어의 끝판왕이었다. 이걸 빠르게 만들려고 연구자들이 새 기법들을 발명한다.
- 적응형 최적화(adaptive optimization): 일단 빠르고 대충 컴파일해서 돌리고, 실행 중 뜨거워진 코드만 골라 고급 컴파일러로 재컴파일
- 타입 피드백: 실행하면서 "이 호출 지점엔 실제로 어떤 타입이 오더라"를 기록하고, 그 관찰에 근거해 가상 호출을 인라이닝
- 역최적화(deoptimization): 추측이 틀리면 최적화된 코드를 버리고 안전하게 인터프리터로 되돌아가는 장치
"정적으로 알 수 없다면, 실행하면서 관찰한 걸 근거로 추측하고, 틀리면 되돌리자"는 철학이다. 1단계 JIT의 문제를 정확히 겨냥한 조합이다. Self 프로젝트가 축소되자 연구자들이 Animorphic Systems(정식명 Longview Technologies)라는 스타트업을 차린다. 처음엔 Smalltalk용 고성능 VM(Strongtalk)을 만들다가 1995년 자바가 폭발적으로 뜨는 걸 보고 방향을 튼다. "Self에서 만든 기술, 자바에 그대로 먹히겠는데?" — 자바도 가상 호출투성이의 객체지향 언어였으니까.
마침 "자바는 느리다"는 문제로 골머리를 앓던 Sun이 1997년에 이 회사를 통째로 인수한다. Animorphic이 만들던 VM이 Sun 내부에서 다듬어져 1999년 4월, Java 1.2용 애드온 "HotSpot VM"으로 출시된다. 이름 자체가 원리를 설명한다 — 코드의 뜨거운 지점을 찾아 거기에만 화력을 집중한다는 뜻이다. Java 1.3(2000)부터 기본 VM이 되면서 "자바는 느리다"는 평가를 실제로 뒤집기 시작한다.
남은 불편함
사람이 C1이냐 C2냐를 골라야 했다.
둘 다 인터프리터로 시작하는 건 같다. 차이는 인터프리터를 얼마나 빨리 벗어나느냐,
그리고 벗어난 뒤 어디까지 올라가느냐다.
- Client VM (C1) — 컴파일 임계값이 낮고 컴파일 자체도 빨라서 금방 네이티브 코드로
갈아탄다. 성능이 빨리 오르지만, C1 코드의 품질이 낮아 거기가 천장이다. - Server VM (C2) — 임계값이 높고 컴파일도 오래 걸려서 인터프리터에 한참 머문다.
워밍업에 수 분이 걸리기도 한다. 대신 일단 올라가면 훨씬 높이 간다.
즉 빨리 빨라지는 것과 끝까지 빨라지는 것 중 하나를 골라야 했다. 게다가 프로파일을
모으는 구간을 가장 느린 인터프리터가 담당하고 있었으니, C2를 택하면 그 느린 구간이
오히려 더 길어졌다.
3단계 — 티어드 컴파일: "고르지 말고 다 쓰자" (JDK 7 도입, JDK 8 기본)
해결 아이디어
C1이냐 C2냐는 애초에 양자택일 문제가 아니었다. C1은 빨리 빨라지고, C2는 느리지만 끝이 높다면, 순서대로 거쳐가면 된다. 인터프리터 → C1 → C2로 같은 메서드를 승격시키는 것이다.
메커니즘 — 왜 레벨이 5개인가
여기서 한 가지 의문이 생긴다. 실행 주체는 인터프리터·C1·C2 셋뿐인데 왜 레벨은 다섯일까?
프로파일을 얼마나 모으느냐가 또 하나의 축이기 때문이다. 프로파일 수집은 공짜가 아니다. "이 호출 지점에 어떤 타입이 왔는지"를 기록하려면 그 기록 코드가 실행되어야 하고 그만큼 느려진다. 그래서 같은 C1 컴파일이라도 프로파일을 전부 모으는 버전, 카운터만 세는 버전, 아예 안 모으는 버전을 따로 둔다. 그 조합이 다섯 레벨이다.
| Level | 실행 주체 | 프로파일링 | 성격 |
|---|---|---|---|
| 0 | 인터프리터 | 전체 수집 | 느리지만 즉시 시작 |
| 1 | C1, 최대 최적화 | 없음 | 여기서 끝낼 메서드용 |
| 2 | C1 | 카운터만 | 임시 대기용 |
| 3 | C1 | 전체 수집 | C2로 가기 위한 준비 |
| 4 | C2 | 없음 | 레벨 3이 모은 걸 소비 |
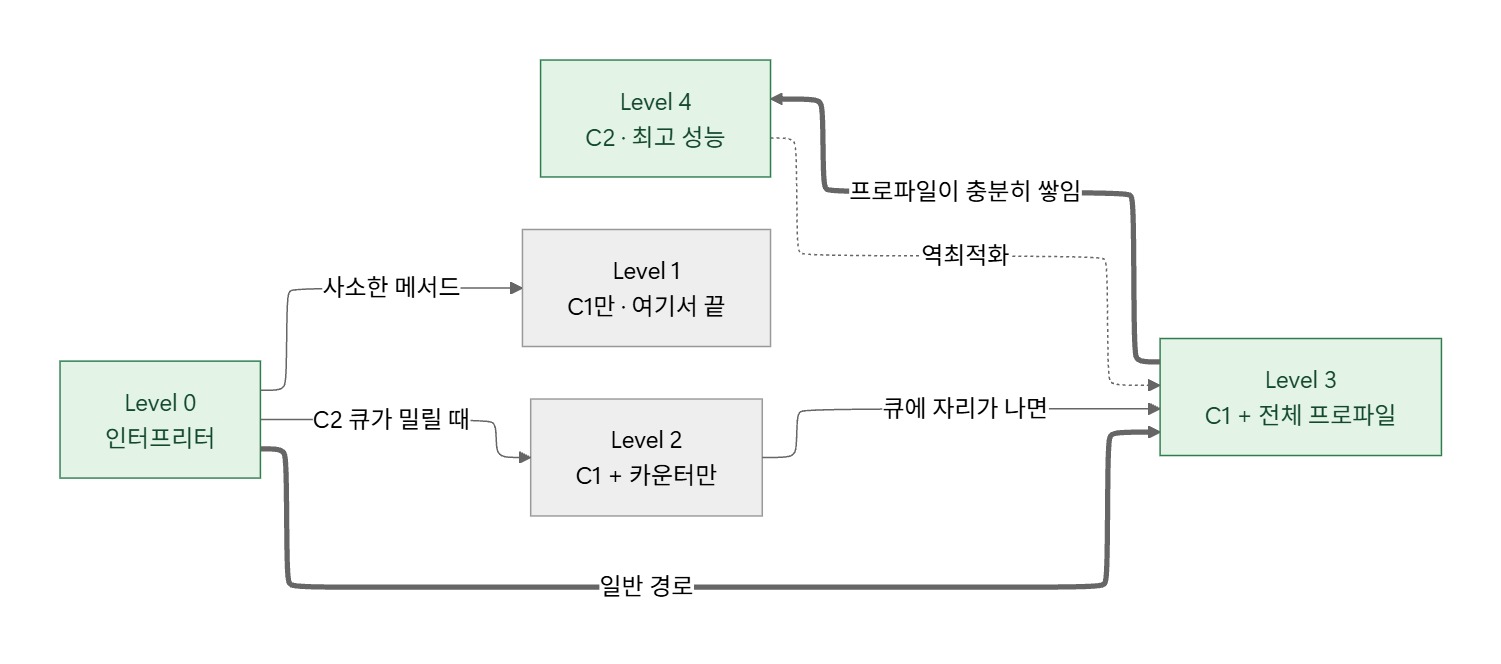
일반 경로는 0 → 3 → 4다. 그리고 이 구조의 진짜 핵심은 레벨 3이 왜 있는가에 있다.
2단계에서 남은 불편함이 "인터프리터로 프로파일 모으는 게 느리다"였다. 프로파일이 충분히 쌓여야 C2로 갈 수 있는데, 그 쌓는 구간을 제일 느린 인터프리터가 담당하고 있었던 것이다. 그래서 티어드 컴파일은 프로파일 수집 코드를 C1이 컴파일한 네이티브 코드 안에 박아 넣는다.
레벨 3 코드는 프로파일 수집 코드를 달고 다니느라 레벨 1보다 30% 정도 느리다. 하지만 인터프리터보다는 수십 배 빠르다. 결과적으로 "프로파일이 쌓이길 기다리는 구간"이 통째로 빨라졌다.
시간 축으로 보면 이렇게 흐른다.
시작 직후    ─  레벨 0. 컴파일 없이 즉시 실행
수백 ms 뒤   ─  뜨거워진 메서드가 레벨 3으로. 이미 인터프리터보다 수십 배 빠름
수 초 뒤     ─  그중 진짜 핵심만 레벨 4로. 최고 성능 도달
나머지 경로에도 다 이유가 있다.
- 0 → 1: getter/setter처럼 사소한 메서드는 프로파일링해봐야 C2가 더 잘 만들 게 없다. C1으로 한 번 컴파일하고 끝낸다.
- 0 → 2 → 3 → 4: C2 컴파일 큐가 밀려 있을 때. 어차피 오래 기다릴 거면 프로파일링 부담이 적은 레벨 2에서 빠르게 돌다가, 자리가 나면 3으로 내려가 프로파일을 채우고 4로 간다.
승격 판단도 단순 카운터가 아니다.컴파일 큐 길이에 비례하는 동적 임계값을 쓴다. 컴파일러가 바쁘면 임계값이 올라가서 아무나 큐에 밀어 넣지 않는다.
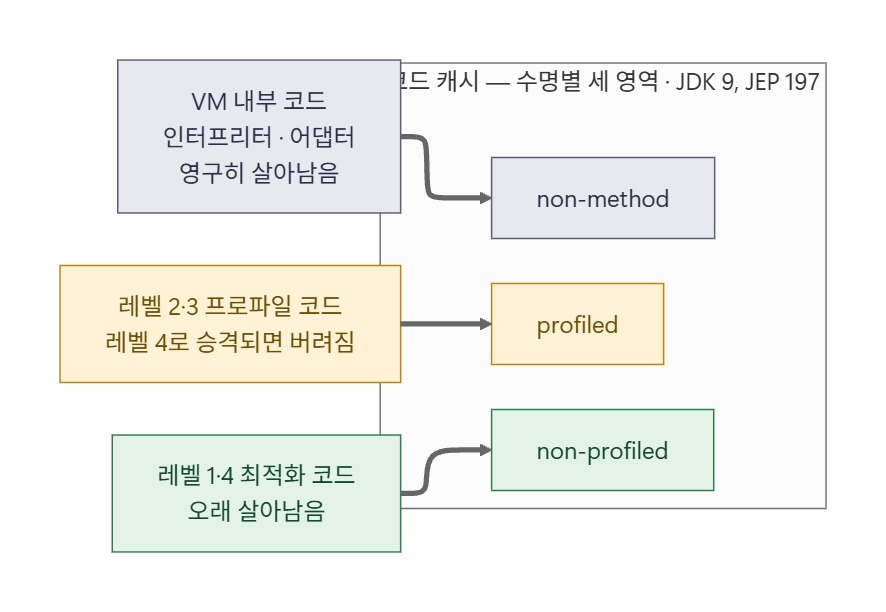
레벨 4로 올라가면 레벨 3 코드는 회수되고, 역최적화가 나면 다시 레벨 3으로 떨어져 프로파일을 새로 모은다. 코드 캐시도 이 구조에 맞춰 세 영역으로 쪼개졌다.
여담 — 코드 캐시를 나눈 이유
코드 캐시는 JIT이 만들어낸 네이티브 코드를 담아두는 공간이다. 우리가 아는 힙과는 별개이고, 크기가 고정되어 있다. 티어드 컴파일이 들어오면서 이 공간에 수명이 완전히 다른 코드가 뒤섞이게 됐다. 레벨 3 프로파일 코드는 레벨 4로 승격되는 순간 버려지고, 레벨 4 코드는 계속 살아남고, 인터프리터 같은 VM 내부 코드는 아예 죽지 않는다.
수명이 다른 것들을 한 곳에 몰아넣는 건 책장에 잡지와 사전을 같이 꽂아두는 것과 비슷하다. 잡지가 빠진 자리가 여기저기 구멍으로 남아 두꺼운 사전이 들어갈 연속된 자리가 안 나오고(단편화), 버릴 것을 찾을 때마다 절대 안 버릴 사전까지 전부 훑어야 한다(스윕 비용).
수명별로 칸을 나누자 청소기(스위퍼)는 메서드 코드가 있는 칸만 훑고 VM 내부 코드 칸은 건너뛰게 됐다. 같은 수명끼리 모여 있으니 빈자리도 덜 쪼개지고, 자주 실행되는 코드가 한곳에 모여 CPU 명령어 캐시 적중률도 올라간다.
참고로 코드 캐시가 가득 차면 JIT 컴파일이 아예 멈춘다. CodeCache is full. Compiler has been disabled 경고가 뜨고, 그 뒤로는 새 메서드가 컴파일되지 않아 인터프리터로만 돌아간다. 서버가 이유 없이 느려졌는데 원인을 못 찾겠다면 의심해볼 만하다. 크기는 -XX:ReservedCodeCacheSize로 조정한다.
효과
"빨리 빨라지는 것"과 "끝까지 빨라지는 것"을 처음으로 동시에 얻었다. 레벨 3 덕분에 초반 성능이 금방 올라오고, 레벨 4 덕분에 천장도 낮아지지 않는다. -client / -server를 고르는 일은 사실상 의미가 없어졌고, JDK 8부터 티어드가 기본값이다.
남은 불편함
1. 워밍업은 여전히 매번 처음부터.
JVM을 재시작하면 힘들게 알아낸 프로파일 데이터가전부 날아간다.
2. 프로파일 오염(profile pollution).
void process(List<String> items) {
    for (String s : items) { ... }   // items.iterator() 호출 지점
}
스프링 부트가 기동하는 동안 이 유틸리티 메서드에는 ArrayList, LinkedList, Collections.emptyList(), Arrays.asList()의 내부 타입까지 온갖 List 구현체가 지나간다. 프레임워크 초기화 코드는 원래 그렇다.
문제는 레벨 3에서 프로파일을 모으는 시기가 하필 이때라는 것이다. JVM은 "이 호출 지점은 메가모픽(타입이 3개 이상)"이라고 기록해버리고 그러면 타입 추측 인라이닝을 포기한다. 정작 서비스가 안정된 뒤엔 ArrayList만 오는데도, 초기화 때 본 것 때문에 그 코드는 끝까지 느린 채로 남는다.
3. 컨테이너·서버리스와 상극.
워밍업은 일종의 선불 투자다. 시작할 때 컴파일러 스레드가 CPU를 태워 비용을 내고, 프로세스가 오래 살면서 빠른 코드로 회수하는 구조다. 하루 종일 도는 전통적인 서버라면 남는 장사다.
그런데 쿠버네티스 오토스케일링을 생각해보자. 트래픽이 몰려 파드가 3개 뜬다. 새 파드는 워밍업 비용을 전부 새로 내야 하는데, 트래픽이 빠지면 15분 만에 죽는다. 투자만 하고 회수를 못 한 채 사라지는 것이다. 게다가 파드를 새로 띄우는 순간은 정의상 "트래픽이 몰려 도움이 급한 순간"인데, 갓 뜬 파드는 인터프리터로 느리게 돌면서 컴파일 스레드가 CPU까지 잡아먹는다. 도우러 온 파드가 오히려 제일 느린 파드가 되는 셈이다.
수백 ms 살다 죽는 AWS Lambda 같은 환경은 아예 회수가 불가능하다. GraalVM 네이티브 이미지나 CRaC 같은 기술이 나온 배경이 이것이다.
4. C2 자체의 한계.
C2는 1990년대 후반에 작성된 C++ 코드베이스다. 20년 넘게 최적화가 켜켜이 쌓이면서 새 최적화 하나를 넣으려면 기존 수십 개 패스와의 상호작용을 전부 검증해야 하는 상태가 됐다. JVM 컴파일러 버그는 애플리케이션 크래시나 조용히 틀린 계산 결과로 나타나기 때문에 위험 부담이 특히 크다.
너무 길어져 다음 편으로 이어 쓰겠다
[1] 애플릿 — 웹 페이지에 심어져 브라우저 내장 JVM 위에서 실행되던 작은 자바 프로그램.1
'Java & Kotlin' 카테고리의 다른 글
| [JVM] G1 GC의 보충설명 (0) | 2026.09.09 |
|---|---|
| [JVM] G1 GC (1) | 2026.09.02 |
| [JVM] GC 알고리즘의 역사 (0) | 2026.09.01 |