[JVM] G1 GC
지난 글의 이야기를 한 문단으로 접어두고 시작하자.
Full GC의 긴 멈춤 앞에서 두 갈래 길이 있었다. 멈춘 동안 여럿이 달려들어 빨리 끝내자는 쪽은 Parallel GC가 됐고 아예 멈추지 말자는 쪽은 삼색 마킹과 배리어로 동시 마킹까지 해냈다. 하지만 그 첫 제품인 CMS는 객체 이동을 포기한 대가로 단편화에 무너졌다. 그로 인해 얻을 수 있었던 것은 "압축을 버리면 안 된다" 라는 것이다. 그렇다면 남은 것은 하나다. 압축을 버리지 않으면서 긴 멈춤도 피하려면 어떻게 해야 할까. 그 답을 들고 나온 GC가 G1이다. 이번 글은 G1 하나만 깊게 판다.
1. Region (논문 2004, JDK 9 기본) — 힙을 2048조각으로
먼저 모순을 정리해보자. 압축은 해야 한다. 하지만 힙 전체 압축에는 긴 멈춤이 필요하다. 이 모순을 어떻게 풀까.
G1의 답은 "전체를 한 번에"를 버리는 것이다. 그런데 "일부만 압축한다"는 말을 곱씹어보면 이상한 점이 있다. 힙의 일부만 골라서 정리하려면 일단 힙이 부분으로 나뉘어 있어야 한다. 세대별 GC도 Young과 Old로 나누긴 했지만 그건 딱 두 덩어리고 Old는 여전히 하나다. Old의 일부만 치우고 싶어도 일부라는 단위 자체가 없는 것이다. 그래서 G1은 힙의 구조부터 다시 짠다.
힙을 같은 크기의 조각 region으로 쪼갠다. region 크기는 힙을 2048로 나눈 값 근처에서 1~32MB 사이의 2의 거듭제곱으로 정해진다. 우리 서버는 4GB니까 4096MB ÷ 2048, 즉 2MB짜리 region 2048개다.

여기서 기존 세대별 GC와 결정적으로 다른 점이 하나 있다. Eden, Survivor, Old가 더 이상 물리적으로 붙어 있는 연속 공간이 아니라는 것이다. region 하나하나에 Eden, Old, Survivor 하고 역할표를 붙일 뿐이다. 이러다 보니 region의 크기가 상황에 따라서 유연해진다. 기존 GC에서 Young 크기를 바꾸려면 힙의 경계선을 옮기는 큰 공사가 필요했는데 G1에서는 빈 region을 Eden이라고 정하면 끝이다.
객체 할당 이야기도 잠깐 하고 가자. Eden region 안은 늘 앞에서부터 차곡차곡 채워진 상태라 빈 공간이 항상 한 덩어리다. 그러니 "다음 객체를 놓을 자리"를 가리키는 포인터 하나만 있으면 된다. new가 들어오면 그 자리에 객체를 놓고 포인터를 객체 크기만큼 뒤로 미는 것으로 할당이 끝난다. 지난 글 3절에서 봤던 bump 할당이다. 힙 곳곳의 빈 구멍들을 뒤지며 맞는 크기를 찾아다녀야 하는 free list 방식과 달리 덧셈 한 번이 전부라, Java에서 객체 생성이 그토록 싼 이유가 바로 이것이다. 그렇게 채우다가 region이 가득 차면 빈 region 하나를 가져와 Eden 팻말을 붙이고 이어서 채운다.
그런데 스레드가 여럿이면 문제가 하나 생긴다. 모두가 같은 포인터를 밀려고 들면 그 포인터를 두고 경합이 붙는 것이다. 그래서 JVM은 스레드마다 Eden region에서 자기 몫의 구간을 정해준다. 이 전용 구간이 TLAB(Thread-Local Allocation Buffer)이다. 각 스레드는 자기 TLAB 안에서 혼자 포인터를 밀며 할당하다가 다 쓰면 새 구간을 받아온다. 자기 땅 안에서는 남과 부딪힐 일이 없으니 락 없이도 수많은 스레드가 동시에 객체를 만들 수 있다.
2. Garbage First — 이름이 곧 전략이다
이제 이 바둑판에서 청소를 어떻게 할지 생각해보자. 이전 글에서 copying 알고리즘을 확인했다. GC의 비용이 도달 가능한(reachable) 객체의 양에만 비례한다는 것. 도달하지 못하는(unreachable) 객체는 건드리지도 않고, 도달 가능한(reachable) 객체만 새 공간(To-space)으로 복사하면 헌 공간(From-space)은 통째로 버려진다. 이 성질을 region 단위에 적용하면 이렇게 된다. 어떤 region(From-space)의 도달 가능한(reachable) 객체를 전부 다른 region(To-space)으로 복사해내면 그 region(From-space)은 통째로 빈 region(From-space)이 된다. 이걸 evacuation(대피)이라고 부르는데 복사해 간 자리는 차곡차곡 쌓이니 복사가 곧 압축이다. CMS 알고리즘을 무너뜨린 단편화가 원천 봉쇄되는 것이다.
그럼 어느 region부터 대피시키는 게 이득일까. 사진 속 Old region 셋의 상태를 보자.
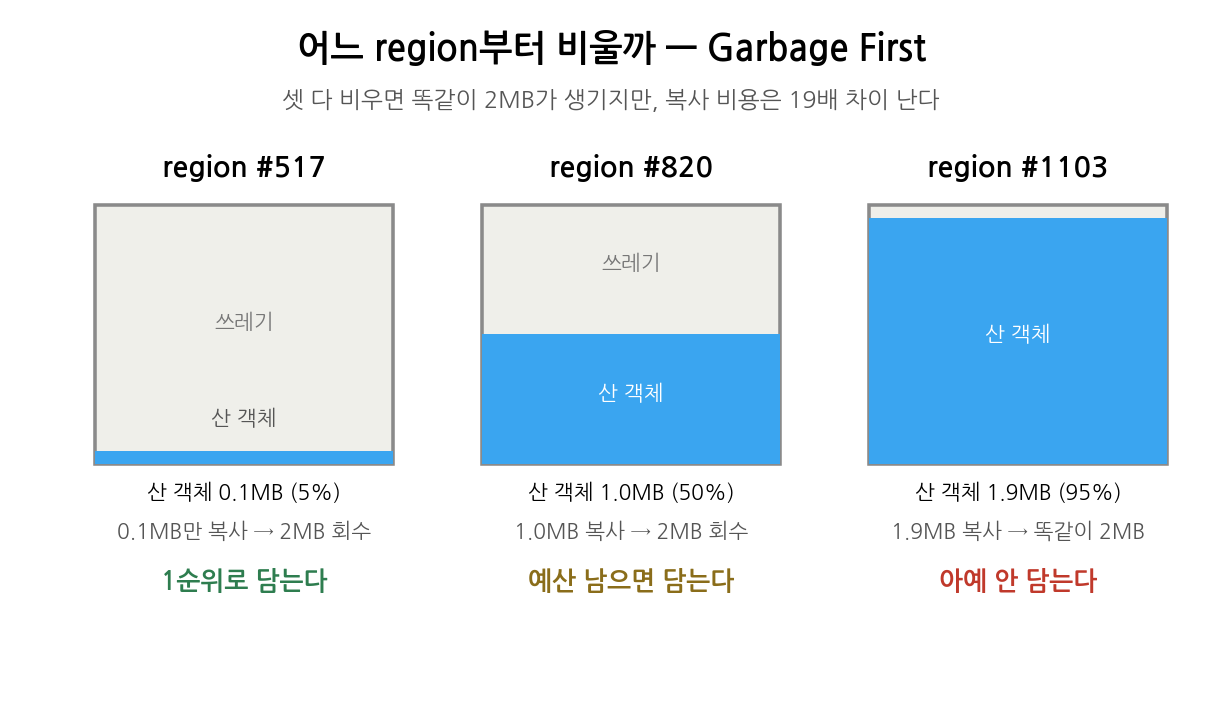
셋 다 비우면 똑같이 2MB짜리 빈 region이 생긴다. 그런데 복사 비용은 #1103과 #517이 19배 차이가 난다. 도달 가능한 객체를 복사하기 때문이다. 그래서 쓰레기가 가장 많은 region부터(Garbage First) 대피시킨다. 같은 복사 비용으로 가장 많은 공간을 회수할 수 있기 때문이다. 이것이 Garbage First의 유래이다.
G1은 새로운 알고리즘이 아니다. 지난 글에서 본 알고리즘들 copying, compact, generational, SATB 동시 마킹을 region이라는 단위 위에서 "비용 대비 회수량이 좋은 곳만 골라서" 돌리는 전략이다. 힙 전체를 압축하는 대신 이번 턴에 치울 region 몇 개를 고르고(이 묶음을 Collection Set, 줄여서 CSet이라 한다) 그 안의 도달 가능한(reachable) 객체만 대피시킨다.
그런데 지난 글을 잘 보았다면 여기서 의문이 생길 것이다.
힙의 일부만 수집한다고? 그거 minor GC가 Young만 보던 그 상황 아닌가?
(minor GC때 old 영역을 안보고 Young만 봐서 old 영역의 객체가 young 영역의 객체를 참조했는데 GC 대상이된 상황)
3. Remembered Set — 부분 수집의 대가
맞다. 정확히 같은 문제가 더 크게 돌아온다. 지난 글에서 Generational을 다시보자. minor GC는 Young만 탐색하니 Old→Young 참조를 놓칠 수 있었고 카드 테이블이 "Old의 어느 512바이트에 뭔가 썼다"를 기록해서 그 구멍을 메꿨다.
G1의 상황은 한층 고약하다. minor GC는 Old에서 오는 참조만 걱정하면 됐지만 G1은 임의의 region 몇 개를 CSet으로 고른다. 하나의 region(From-space)에 있는 도달 가능한(reachable) 객체를 대피시키려면 나머지 2047개 region 어디에서든 region(From-space) 안으로 들어오는 참조가 있는지 알아야 한다. 못 찾으면 도달 가능한(reachable) 객체를 복사에서 빠뜨리거나 복사는 했는데 옛 주소를 가리키는 참조를 하나 못 고치는 사고가 난다. 객체는 새 region(To-space)으로 이사 갔고 옛 자리는 반납되어 곧 다른 객체가 들어올 텐데 참조 하나가 아직 그 옛 주소를 붙들고 있는 것이다. 이걸 댕글링(dangling) 참조라고 부르는데 나중에 그 참조를 따라 읽는 순간 엉뚱한 데이터를 읽거나 충돌이 난다. 그렇다고 매번 힙 전체를 스캔하면 부분 수집의 의미가 없다.
그래서 G1은 카드 테이블을 한 단계 정제한 자료구조를 region마다 둔다. Remembered Set 줄여서 RSet이다. region마다 " 누가 나를 가리키나 "를 목록으로 들고 있는 것이다 region(From-space)에 있는 도달 가능한(reachable) 객체를 대피(evacuation) 시킬 때 필요한 정보이기 때문이다.
예를 들어보자. 상품 캐시 K가 Old region #517에 살고 방금 만들어진 주문 객체 V가 Eden region #12에 있다.
k.lastOrder = v; // Old(#517)의 필드가 → Eden(#12)의 객체를 가리킴이 대입이 실행되는 순간 JIT이 심어둔 쓰기 배리어가 발동한다. 개념적으로 이렇게 생겼다.
k.lastOrder = v;
// ↓ 참조를 쓴 "다음에" 실행되는 post-write barrier
if (region(k) != region(v)) {          // ① 같은 region 안 참조면 기록할 필요 없음
    if (v != null) {                    // ② null 대입도 무시
        card = cardOf(k.lastOrder);
        if (card != DIRTY) {            // ③ 이미 기록된 카드면 중복 방지
            card = DIRTY;
            dirtyCardQueue.add(card);   // ④ 내 스레드의 더티 카드 큐에 적재
        }
    }
}
코드를 위에서부터 읽어 내려가 보자. 큐에 넣기 전에 세 번을 걸러낸다. 같은 region 안에서의 참조라면 애초에 RSet에 적을 일이 아니니 버리고 null 대입도 새 참조가 생기는 게 아니니 버리고 이미 더티로 표시된 카드라면 또 적을 필요가 없으니 버린다. 이렇게까지 거르는 이유는 간단하다. 대입은 프로그램에서 쉴 새 없이 일어나는데 그때마다 무조건 기록하면 배리어 비용이 프로그램 전체에 부담을 주게 된다. 실제로는 같은 region 안 참조가 대다수라 첫 번째 필터에서 거의 다 걸러진다고 한다.
그리고 마지막 줄이 재미있는 부분이다. 세 관문을 통과한 카드를 배리어는 큐에 넣기만 하고 앱은 제 갈 길을 간다. 그 큐는 refinement 스레드라는 GC 보조 스레드들이 백그라운드에서 소화한다. 더티 카드를 실제로 열어보고 "아, #517의 이 카드에 #12로 들어가는 참조가 있구나"를 확인한 뒤 #12의 RSet에 항목을 추가하는 것이다.
왜 이렇게 두 단계로 나눴을까. 배리어가 남긴 기록을 보면 "이 카드에 뭔가 썼다"가 전부다. 그 참조가 어느 region으로 들어가는지는 아직 아무도 모른다. 알아내려면 카드를 열어 안의 참조들을 실제로 읽어봐야 하는데 그 일까지 배리어에게 시키면 대입마다 앱이 느려진다. 그래서 역할을 나눈 것이다. 앱은 여기 뭔가 있음이라고 알리고 시간이 걸리는 확인과 분류는 refinement 스레드가 앱과 나란히 돌면서 미리 해둔다.
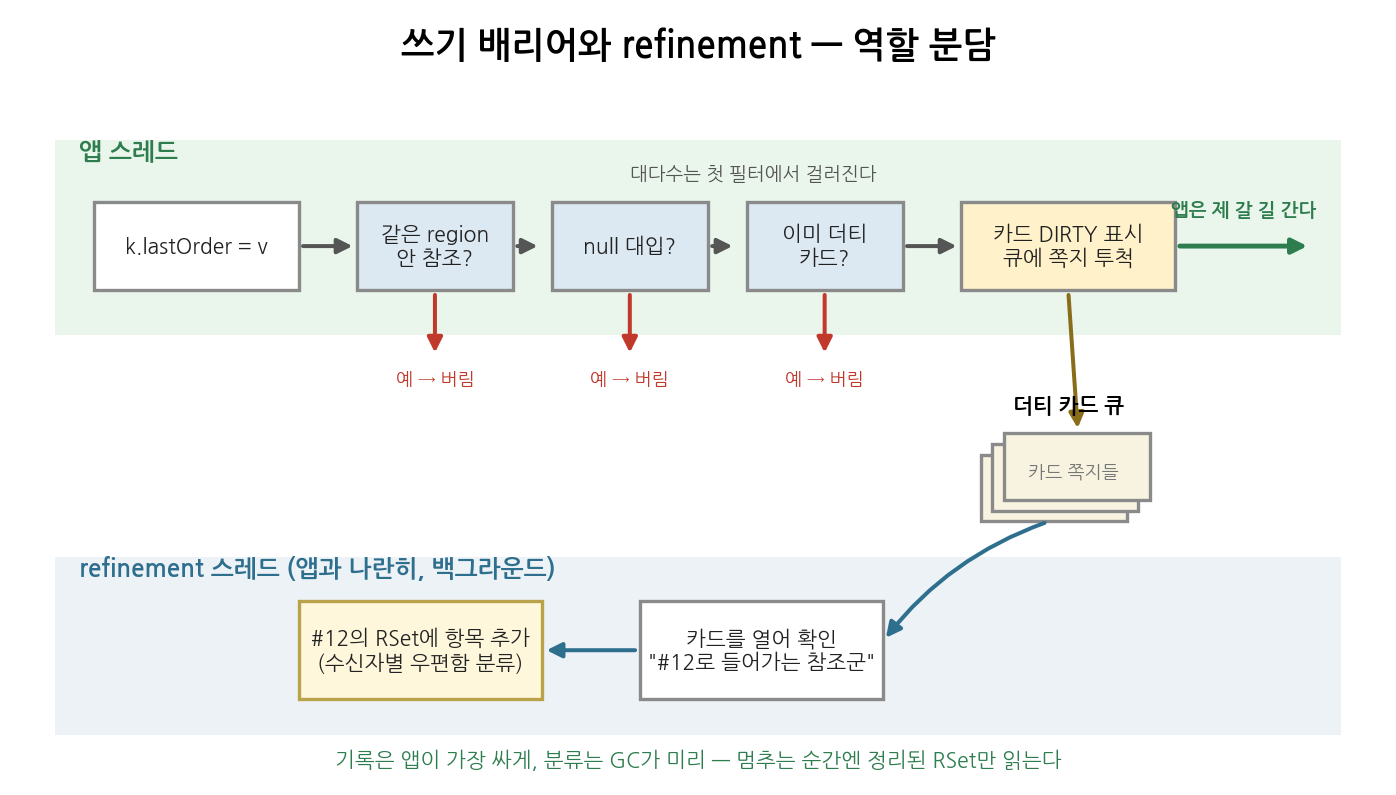
정리하면 G1의 부분 수집은 공짜가 아니다. region마다 RSet이라는 메모리 오버헤드, 모든 참조 대입에 붙는 배리어, 상시 도는 refinement 스레드의 CPU를 지불하고 산 능력이다. 지난 글의 Parallel GC를 떠올려보면 차이가 느낄 수 있다. Parallel은 멈춘 순간에만 일하고 평소에는 아무 비용도 내지 않았다. 반면 G1은 GC가 돌지 않는 평시에도 배리어와 refinement 스레드가 앱과 CPU를 나눠 쓴다. 그래서 같은 일을 시켜보면 처리량은 G1이 Parallel에 살짝 밀린다. 짧은 멈춤을 얻는 대가로 평시 성능을 조금씩 떼어 주고 있는 셈이다.
그리고 G1의 쓰기 배리어는 사실 두 개다. 방금 본 RSet용 post-write 배리어에 더해 SATB의 pre-write 배리어(덮어써지기 직전의 이전 값을 큐에 적는 것)도 함께 붙는다. G1의 동시 마킹이 SATB 방식이기 때문이다.
4. Pause Prediction — 약속을 지키는 GC
3절까지 오면서 부분 수집을 할 준비는 끝났다. 힙을 region으로 쪼갰고(1절) 어디부터 치울지 고르는 기준을 세웠고(2절) 바깥에서 들어오는 참조를 찾을 방법도 마련했다(3절). 이제 GC를 돌릴 차례인데 그 전에 G1이 사용자와 맺은 약속부터 보자.
-XX:MaxGCPauseMillis=200 (기본값 200ms)G1의 사용자 인터페이스는 사실상 이 한 줄로 요약된다. "한 번 멈출 때 200ms를 넘기지 않도록 노력하겠다"는 목표치다. 수십 개의 옵션을 손으로 맞춰야 했던 CMS와는 정반대의 철학이다. 사용자는 원하는 결과만 말하고 그걸 맞추는 방법은 GC가 알아서 찾는다.
그런데 GC가 미래의 멈춤 시간을 어떻게 알 수 있을까?
예측이 아니라 견적이다
답은 통계다. GC를 한 번 돌 때마다 든 비용을 항목별로 전부 기록한다.
- RSet에 적힌 카드를 스캔하는 데 걸린 시간
- 도달 가능한(reachable) 객체 1MB를 복사하는 데 걸린 시간
- 참조를 고치는 데 걸린 시간
- GC 루트를 훑는 데 걸린 시간
이 이력의 이동 평균을 계속 들고 있으면 평균적인 비용이 나온다. "지금 이 힙에서 Eden region 하나를 비우는 데 평균 1.2ms."
비용이 나오면 그다음은 산수다.
200ms(예산) - 고정비(루트 스캔 등) = 변동 예산
변동 예산 ÷ region 하나당 1.2ms  = 이번 판에 담을 region 개수
고정비를 따로 떼어낸 게 중요하다. GC 루트 스캔처럼 region을 몇 개 담든 늘 드는 몫이 있고 복사처럼 개수에 비례해 늘어나는 몫이 있다. G1이 조절할 수 있는 건 뒤쪽뿐이다. 그래서 예산에서 고정비를 먼저 빼고 남은 돈으로 region을 몇 개나 살 수 있는지를 계산한다. "예산이 200ms니까 이번엔 Eden 팻말을 150개까지만 달자." 감이 아니라 과거 통계로 굴러가는 예측 모델이다.
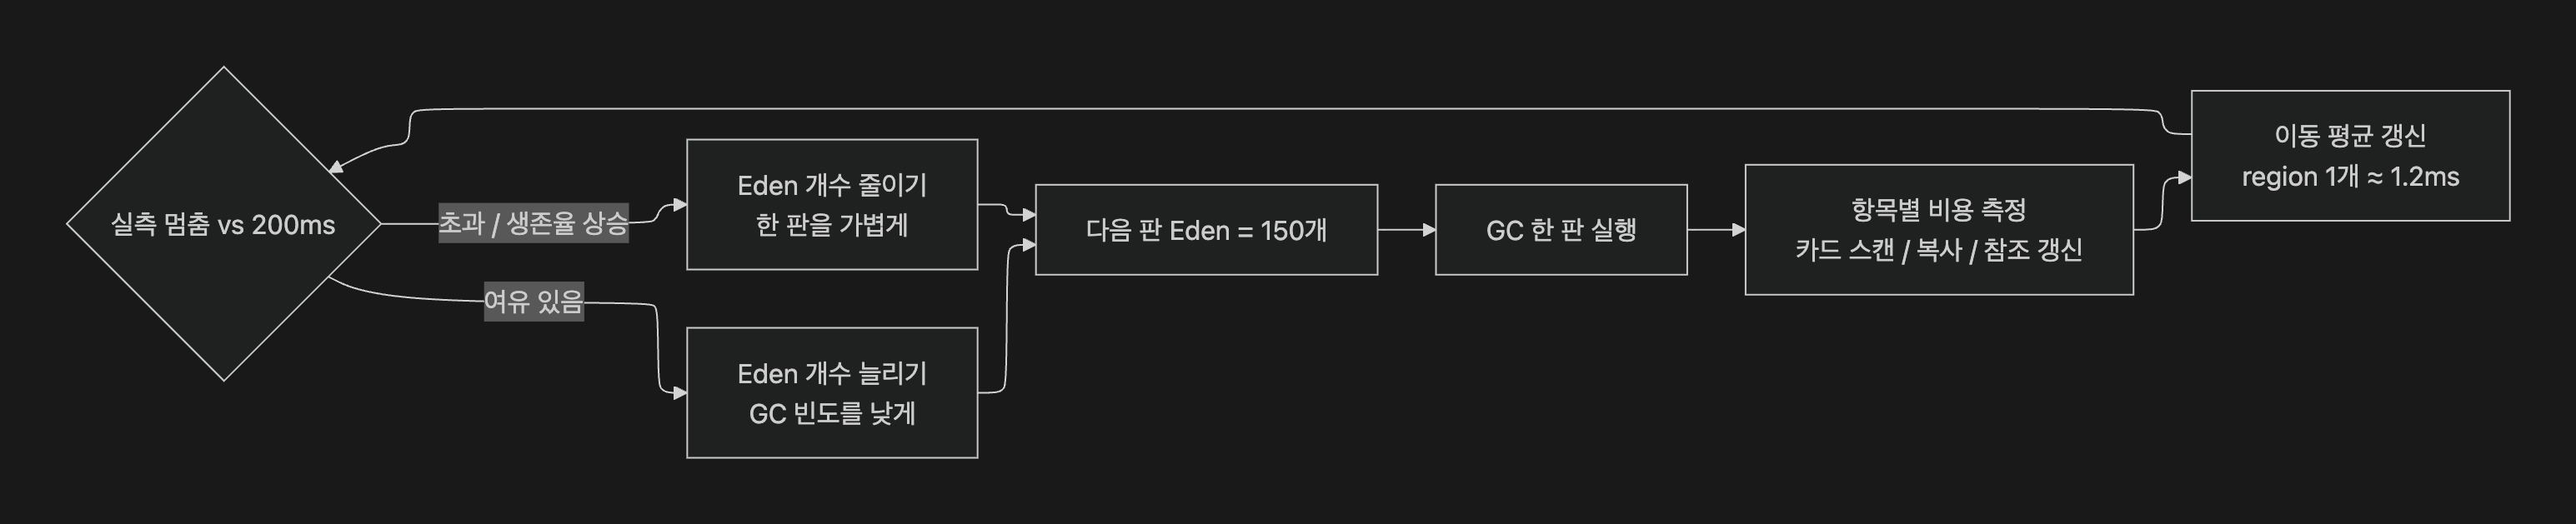
이 고리가 닫혀 있다는 게 핵심이다. 예측이 빗나가면 그 결과가 다음 판의 평균에 반영되고 그게 다시 다음 Eden 크기를 바꾼다. 트래픽이 몰려 생존율이 오르면 Eden을 줄여 한 판의 멈춤을 예산 안으로 밀어 넣고 여유가 생기면 Eden을 키워 GC 빈도를 낮춘다. 운영자가 며칠씩 값을 바꿔가며 찾던 균형점을 GC가 매 사이클 스스로 잡는 셈이다.
그리고 이게 가능한 건 순전히 1절의 바둑판 설계 덕분이다. 힙이 Young과 Old로 통째로 갈려 있으면 Young 크기를 바꾸는 건 경계선을 옮기는 공사지만 region 위에서는 빈 region에 Eden 팻말을 몇 개 다느냐로 끝난다. 작업량 조절이 곧 개수 조절이 된 것이다. 예산이라는 숫자와 힙 구조가 여기서 맞물린다.
5. Evacuation Pause — 한 판 따라가기
예산이 정해졌으니 실제 한 판을 따라가 보자. Eden region 150개, 그러니까 300MB어치가 가득 찼다. 앱을 세운다. 그렇다, G1의 young GC는 여전히 멈춤이 있다(Stop-the-World). 이 멈춤을 evacuation pause라고 부른다. 산 객체를 다른 region으로 대피시키는 시간이라는 뜻이다.
하는 일은 다섯 가지다.
- 대상 고르기 — Eden 150개와 이전 판의 Survivor region들이 CSet이 된다.
- 바깥에서 들어오는 참조 찾기 — 스택의 지역 변수, static 필드 같은 GC 루트에서 CSet 안을 가리키는 참조를 찾는다.
- 안에서 들어오는 참조 찾기 — CSet에 속한 각 region의 RSet을 읽는다. 힙의 다른 region에서 CSet 안으로 들어오는 참조가 여기서 나온다. 힙 전체가 아니라 RSet에 적힌 카드들만 열어본다.
- 옮기기 — 앞의 둘에서 찾은 참조를 출발점 삼아 산 객체를 Survivor 또는 Old region으로 복사한다. 지난 글의 copying 그대로다. forwarding pointer가 중복 복사를 막고 나이가 임계값을 넘긴 객체는 Old로 승격된다. 복사는 GC 스레드 여럿이 병렬로 하는데 스레드 간 작업량 불균형은 지난 글 6절의 work stealing이 그대로 해결한다.
- 반납하기 — CSet이었던 region들을 통째로 빈 region으로 돌려놓는다. 참조 갱신은 복사 과정에서 이미 끝났다.
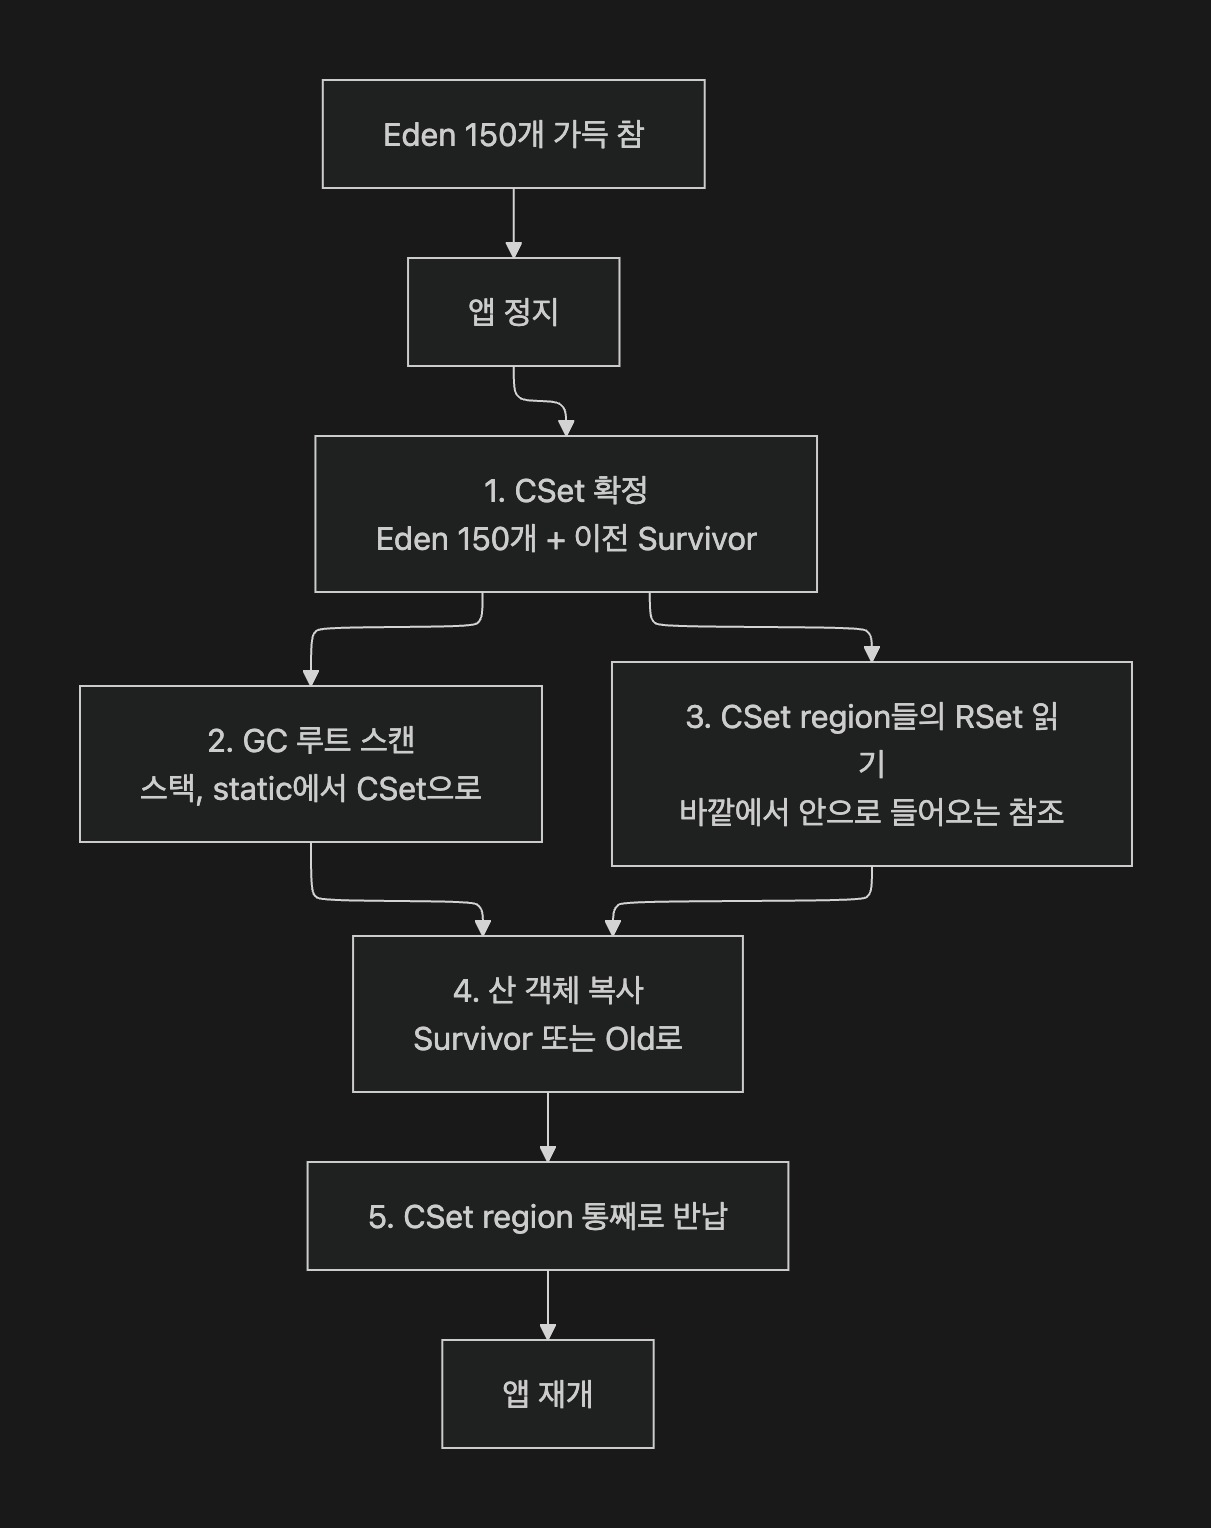
참조를 찾는 일이 두 갈래로 나뉘어 있는 게 이 절차의 전부라고 봐도 된다. 도달 가능한(reachable) 객체를 찾으려면 그 객체를 가리키는 참조가 어디 있는지를 알아야 하는데 출처는 두 곳뿐이다. 힙 바깥(ex: JVM의 stack frame)이거나 힙 안의 다른 region이거나. 바깥은 GC 루트를 그냥 스캔하면 되고 안쪽을 위해 3절에서 배리어와 refinement 스레드라는 유지비를 냈다. 그 비용을 되찾는 게 세 번째 단계다. 2047개 region을 뒤지는 대신 RSet에 적힌 카드 몇 장만 열어본다.
마지막 반납이 시원한 부분이다. 참조 갱신은 옮기면서 이미 다 끝났으니 CSet이었던 region들은 안에 뭐가 남아 있었는지 볼 것도 없이 통째로 빈 칸으로 돌려놓는다. 도달하지 못하는(unreachable) 객체를 처리하는 비용이 정확히 0이다. 2절에서 본 copying의 성질이 region 단위에서 그대로 나타난다.
그리고 이 다섯 중 실제로 시간을 잡아먹는 건 옮기기 하나다. 고르고 찾고 반납하는 일은 상대적으로 싸다. 여기서 세대 가설(대부분의 객체의 수명은 짧다)이 한번 더 나타난다. Eden 생존율은 보통 한 자릿수 퍼센트라 300MB어치 region을 치워도 실제 복사량은 수십 MB고 멈춤은 수십 ms에서 끝난다.
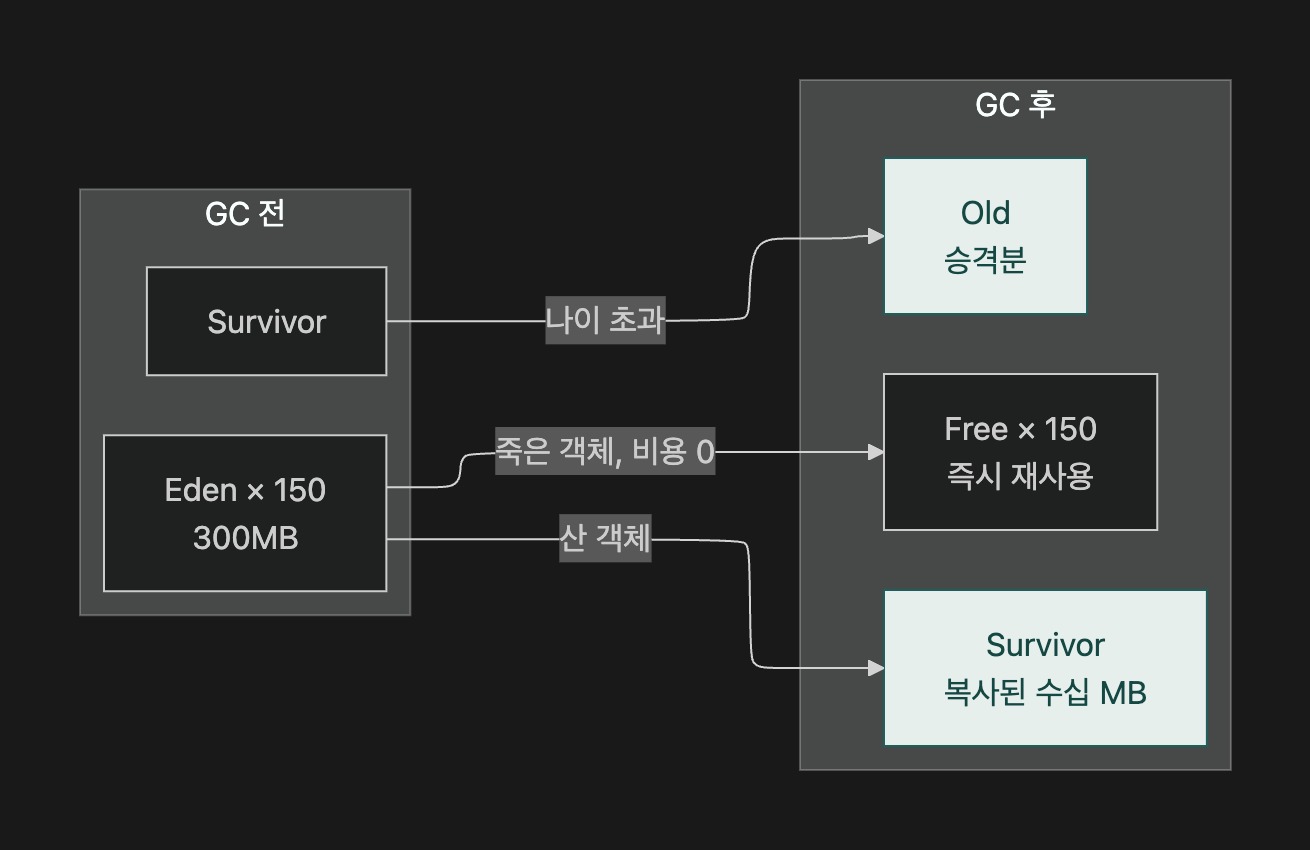
멈춤이 복사량에 비례하고 복사량이 Eden 개수에 비례하니 앞 절의 예산 모델이 정확히 여기에 물린다. Eden 개수라는 손잡이 하나로 멈춤 시간이 조절되는 것이다. 여기까지가 region 위에서 도는 자기 크기를 스스로 맞추는 세대별 copying GC다. 지난 글에 있던 재료들을 region 위에 다시 얹었을 뿐이고 아직 Old는 손도 대지 않았다. 그런데 Old는 계속 쌓이고 생존율이 높아서 "도달 가능한(reachable) 객체를 전부 복사한다"는 전략이 통하지 않는다. G1의 진짜는 여기서 시작한다.
6. 동시 마킹 — 순위표를 만드는 시간
Old를 Garbage First로 치우겠다는 말에는 전제가 하나 숨어 있다. 어느 region이 제일 지저분한지를 알아야 순위를 매길 수 있다는 것이다. 그런데 그걸 아는 방법은 하나뿐이다. 힙 전체를 마킹해서 region마다 산 객체가 몇 바이트인지 세는 것. 문제는 힙 전체 마킹이 4GB를 통째로 훑는 일이라는 점이다. 멈춰 세우고 하면 200ms 약속이 그 자리에서 깨진다. 그래서 앱과 동시에 한다. 지난 글 7절에서 나온 SATB 동시 마킹이 여기서 등판한다. 시작 신호는 Old 사용량이다. Old가 힙의 일정 비율(기본 45%에서 적응형)을 넘으면 사이클이 켜진다. 우리 서버라면 Old가 1.8GB를 넘어서는 시점이다.
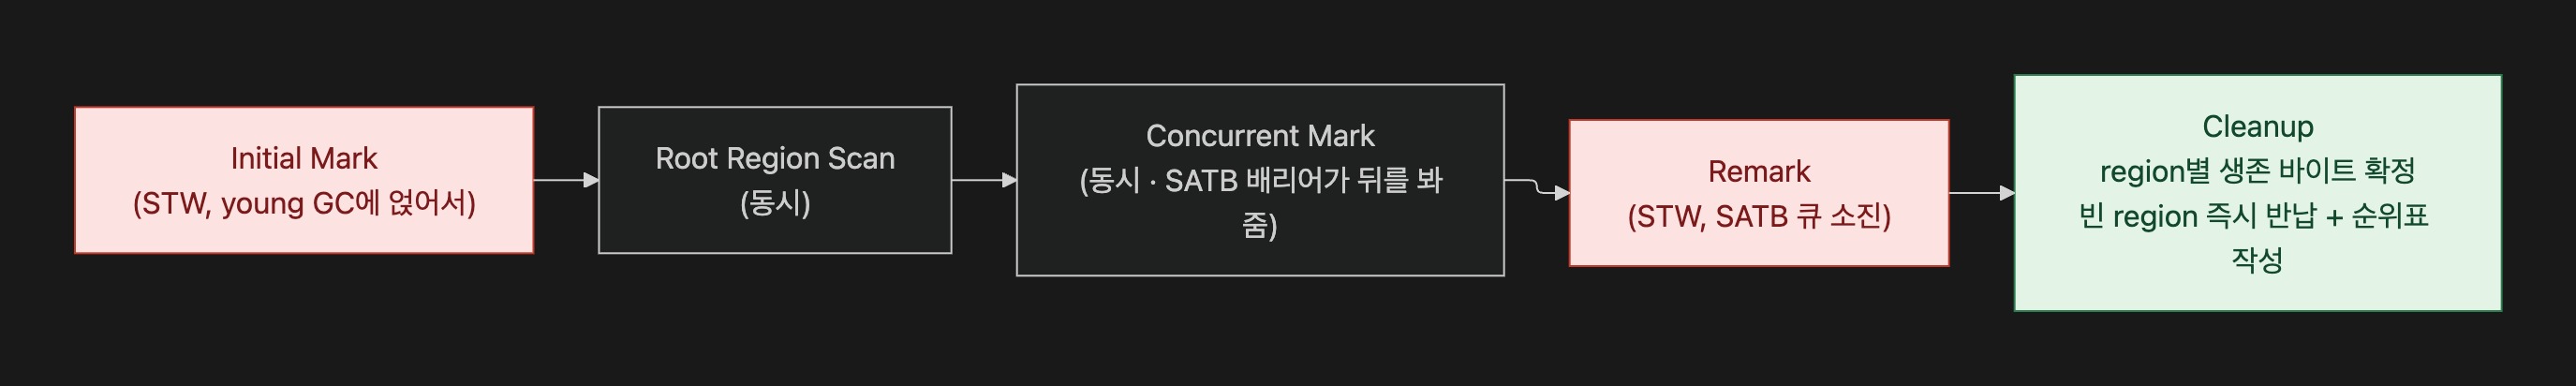
말로 풀면 이렇다. 첫 단계 Initial Mark는 루트가 직접 가리키는 객체만 표시하는 짧은 멈춤인데 어차피 멈춰야 한다면 이미 멈추는 김에 하자는 발상으로 다음 young GC의 멈춤에 얹어서(piggyback) 처리한다. 멈춤 횟수를 아끼는 잔기술이다.
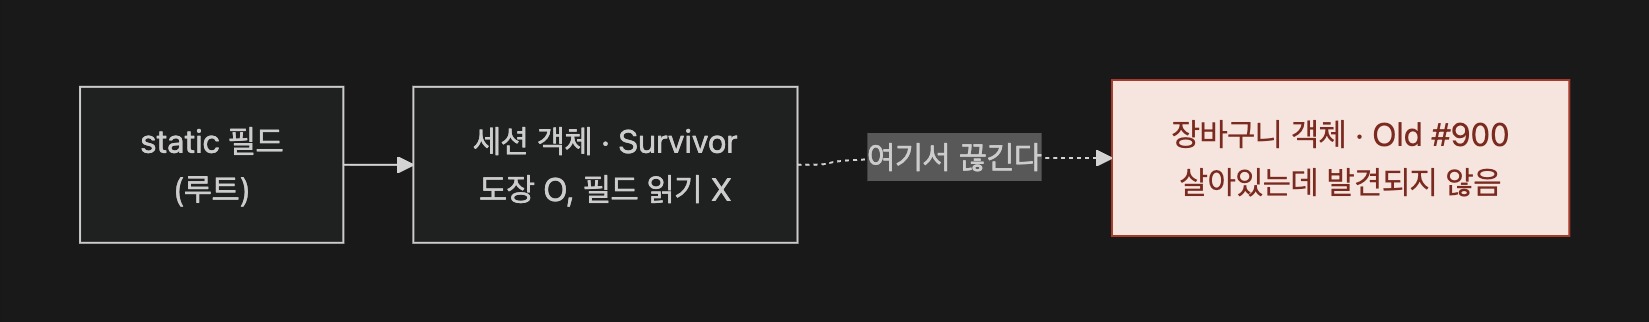
Root Region Scan은 그 읽지 않은 필드를 대신 읽어주는 단계다. Survivor 안을 훑어 Old로 나가는 참조를 뽑아 마킹의 출발점에 얹어준다. Survivor를 추가 출발점, 즉 루트 region으로 쓴다고 해서 붙은 이름이다.
하필 Survivor만 보는 건 Initial Mark가 young GC에 얹혀 있어서다. 그 시점에 Eden은 방금 비워졌으니 살아있는 young 객체가 남은 곳은 Survivor뿐이다. 이 단계는 앱과 동시에 돌지만 마감이 있다. 그 Survivor region들은 다음 young GC가 가장 먼저 대피시킬 대상이라 한번 반납되고 나면 읽을 것이 없다. 그래서 다음 young GC가 오기 전에 끝나야 하고 못 끝냈으면 GC가 기다린다.
Concurrent Mark가 본체다. 앱과 나란히 돌면서 힙 전체의 참조 그래프를 따라간다. 그 사이 앱이 참조를 끊으면 어떻게 되나. SATB의 pre-write 배리어가 덮어써지기 직전의 이전 값을 큐에 남겨두므로 마킹 시작 시점의 스냅샷 기준으로 산 객체를 잃지 않는다.
마지막 Remark에서 큐에 쌓인 잔여분을 소진하고 마킹을 닫는다. 여기가 짧게 끝나는 게 SATB의 값어치다. 정답이 시작 시점에 고정되어 있으니 앱이 그동안 뭘 만들었든 그건 이번 판의 관심사가 아니다. CMS가 고른 Incremental Update는 반대로 새로 생긴 참조를 계속 따라잡아야 해서 Remark가 좀처럼 끝나지 않았다.
그리고 SATB를 고른 이유가 하나 더 있다. 기준 시점이 고정되어 있으니 마킹이 끝나면 region별 생존 바이트가 딱 떨어진 숫자로 나온다. 이게 곧 "어느 방이 제일 지저분한가" 지도가 되어 Garbage First 선별의 입력이 된다. 설계와 알고리즘의 궁합이다. Cleanup에서 결실이 나온다. 산 객체가 0인 region은 복사할 것도 없으니 그 자리에서 즉시 빈 region으로 반납하고 나머지 Old region들을 쓰레기 비율 순으로 줄 세운 순위표를 만든다.여기서 한 가지 짚고 가자. 동시 마킹은 빈 region 반납을 빼면 아무것도 치우지 않는다. 몇 초에 걸쳐 힙 전체를 훑고 CPU를 쓰지만 이 사이클의 산출물은 회수된 메모리가 아니라 정보다. 실제 청소는 그다음이다.
7. Mixed GC — 이름값을 하는 순간
순위표가 준비되면 이후 몇 번의 GC는 Mixed GC로 돈다. CSet에 young region 전부에 순위표 상위의 old region 몇 개를 섞는다(mixed라는 이름이 여기서 왔다). 순위표가 준비되면 이후 몇 번의 GC는 Mixed GC로 돈다. CSet에 young region 전부에 더해 순위표 상위의 old region 몇 개를 섞는다. mixed라는 이름이 여기서 왔다. 동작은 5절의 evacuation pause와 완전히 같다. 루트와 RSet에서 참조를 찾고 산 객체를 복사하고 CSet region을 통째로 반납한다. 달라진 건 CSet 목록에 old가 몇 줄 끼어 있다는 것뿐이다. 200ms에서 young 몫을 빼고 남는 시간만큼만 old를 담는다. 2절의 세 region을 다시 보자. region 하나는 2MB다.
#1103이 제외되는 게 흥미로운 지점이다. 살아있는 비율이 임계값(G1MixedGCLiveThresholdPercent, 기본 85%)을 넘는 region은 후보에서 빠진다. 2MB를 비우자고 1.9MB를 복사하는 건 남는 장사가 아니다. 쓰레기가 적은 방은 치우지 않는 게 이득이라는 지극히 경제적인 판단이고 애초에 Garbage First라는 이름이 뜻하는 바이기도 하다.
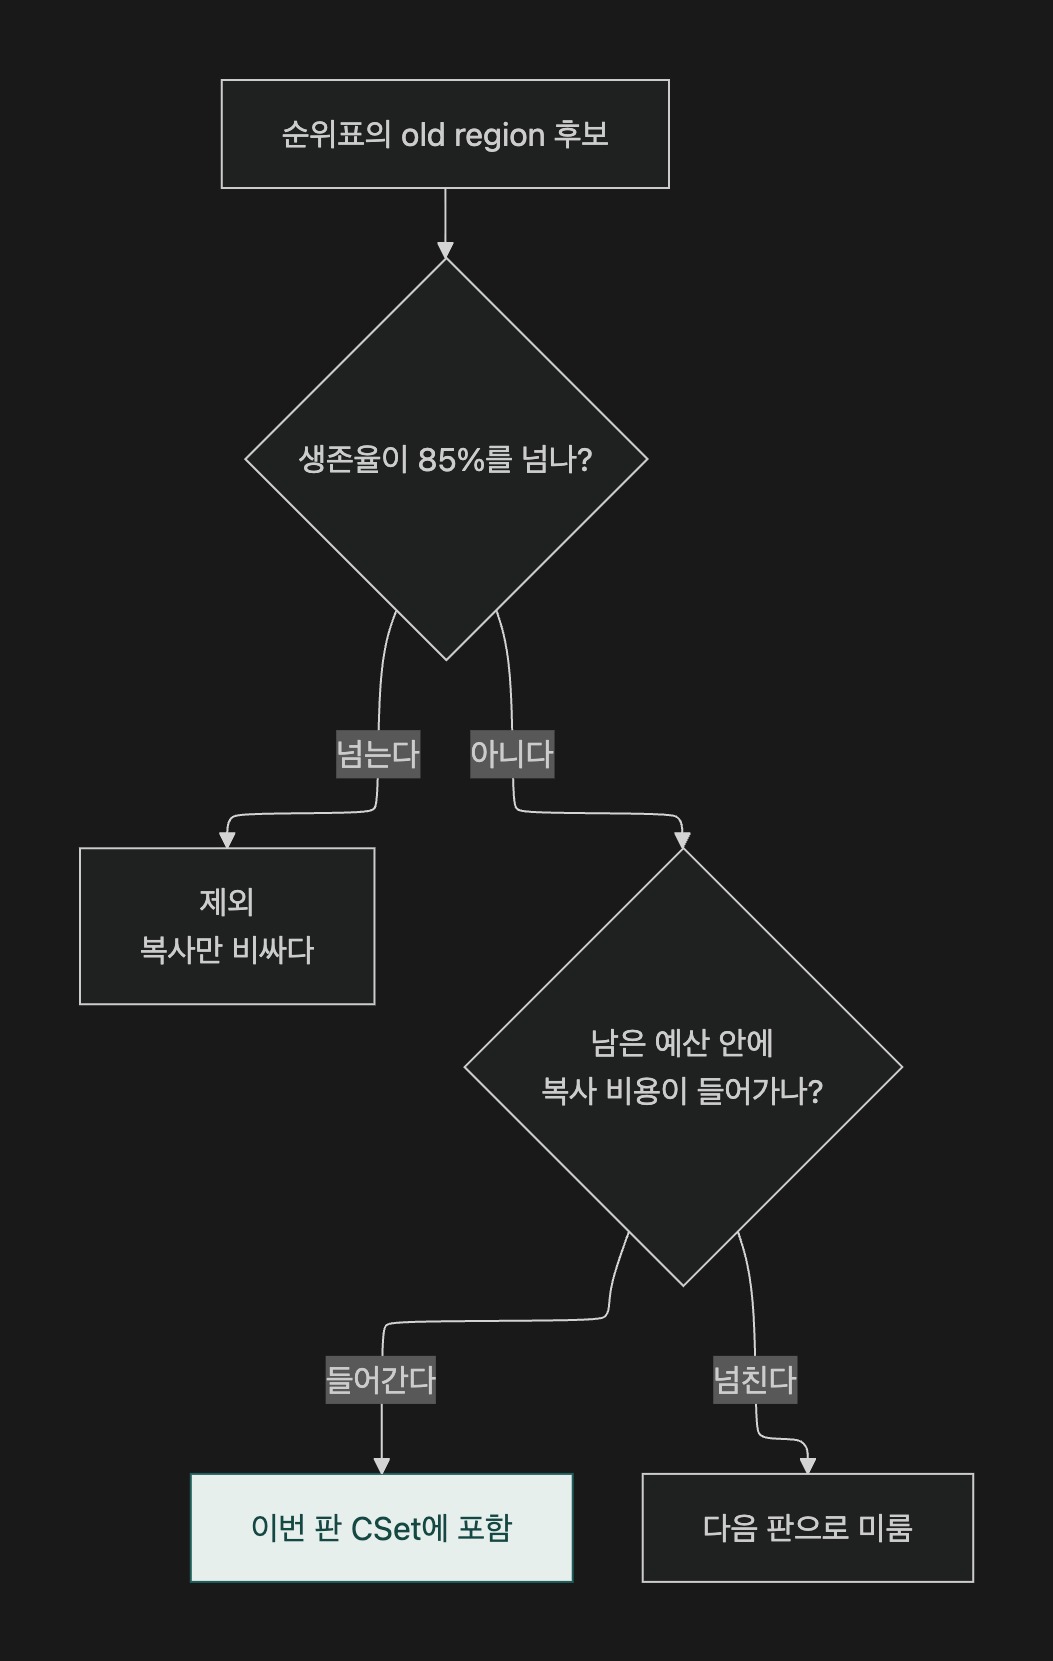
그렇게 순위표를 소진하다가 "남은 후보를 다 치워봐야 힙의 5%(G1HeapWastePercent)도 안 나온다" 싶으면 Mixed GC를 멈추고 평소의 young GC로 돌아간다. 한 번에 다 치우지 않고 보통 여덟 번 정도(G1MixedGCCountTarget)에 나눠 치우는 것도 매 판의 멈춤을 예산 안에 가두기 위해서다.
이제 지난 글 마지막 문장이 완성된다. 압축을 잘게 쪼개서 조금씩 힙 전체 compact 한 방 대신 쓰레기 많은 region 몇 개씩을 young GC의 멈춤에 얹어 대피시키는 것. 대피 자체가 copying이므로 옮겨 간 자리는 자동으로 압축돼 있고 CMS를 무너뜨린 단편화는 구조적으로 쌓일 수가 없다.
8. Humongous — 바둑판의 예외
그런데 region이 2MB인데 3MB짜리 객체가 오면 어떻게 될까. 우리 서버가 대용량 주문 내역 조회로 byte[] 3MB를 만드는 순간이다. region 절반을 넘는 객체를 G1은 humongous(거대) 객체로 분류하고 특별 취급한다. 연속된 빈 region들을 통짜로 잡아 Humongous 팻말을 붙이고 객체를 눕힌다. 3MB면 연속 region 2개다. 이 객체는 Eden을 거치지 않고 태어나자마자 Old 취급이며, 크기가 크니 대피(복사)도 하지 않는다.
문제는 여기서 생긴다. 복사하지 않는 객체는 그 자리에서 죽고 그 자리에서 회수된다. humongous 할당과 해제가 반복되면 연속된 빈 region이 부족해지는 단편화가 region 단위에서 재발할 수 있는 것이다. 여유 공간은 총량으로 충분한데 연속 2칸이 없어 할당이 실패하는 현상이다. humongous가 잦은 서비스에서 G1이 갑자기 Full GC를 터뜨리는 단골 원인이라 아예 region 크기를 키워서(-XX:G1HeapRegionSize=8m 등) 웬만한 큰 객체가 humongous로 분류되지 않게 하는 처방이 흔히 쓰인다. 다행히 JDK 8u60부터는 아무도 참조하지 않는 humongous를 young GC 때 바로 회수하는 최적화가 들어가 짧게 쓰고 버리는 대형 배열의 피해는 줄었다.
9. 그래도 멈춘다 — G1의 천장
마지막으로 G1이 무너지는 시나리오를 보자. 대피는 산 객체를 다른 region으로 복사하는 일이므로, 받아줄 빈 region이 있어야 성립한다. 트래픽 폭주로 승격이 몰리거나 humongous가 빈 region을 다 삼켜서 복사해 갈 곳이 없어지면(evacuation failure) G1도 비상수단을 꺼낸다. 힙 전체를 세워두고 정리하는 Full GC다. 그나마 JDK 10부터 이 Full GC가 병렬로 돌게 되어(단일 스레드였던 CMS의 비상수단보다는 낫다) 최악은 면했지만 수 초의 멈춤이 돌아온다는 본질은 같다.
그리고 비상 상황이 아니어도 넘을 수 없는 천장이 하나 있다. 5절에서 본 대로 evacuation은 처음부터 끝까지 멈춘다. 이유는 지난 글 7절 끝에서 이미 봤다. 객체를 옮기는 동안 앱이 옛 주소를 읽어버리면 사고이기 때문에 읽기를 낚아채는 장치 없이는 이동을 앱과 동시에 할 수 없다. G1은 그 장치 없이 갈 수 있는 곳까지 간 GC다. 멈춤을 없앤 게 아니라 멈춤을 예산 안에 가두는 데 성공한 것이고 그래서 힙이 수십 GB로 커지고 산 객체가 많아지면 복사 해야하는 것이 많아져 default 예산(변경 가능)인 200ms를 지키는 일 자체가 버거워진다.
멈춤을 정말로 ms 단위로, 나아가 힙 크기와 무관한 상수로 만들려면 결국 모든 참조 읽기에 검사를 붙이는 것을 건드려야 한다. 20년 동안 "느려서 안 된다"던 읽기 배리어를 실제 제품에 넣어버린 GC들이 있다. ZGC와 Shenandoah다.
해당 내용은 다음 글에서 다룬다.
'Java & Kotlin' 카테고리의 다른 글
| [JVM] G1 GC의 보충설명 (0) | 2026.09.09 |
|---|---|
| [JVM] GC 알고리즘의 역사 (0) | 2026.09.01 |
| [JVM] JIT(Just-In-Time) 컴파일러의 발전과정 알아보기 - 1 (0) | 2026.08.27 |