[JVM] GC 알고리즘의 역사
0. 문제의 탄생 — 수동 메모리 관리
C에서 힙 메모리는 사람이 직접 반납한다.
char *buf = malloc(1024);
...
free(buf);      // 잊으면 → 누수 (프로세스가 살아있는 한 계속 샘)
free(buf);      // 실수로 한 번 더 → 힙 자료구조 파괴, 크래시 or 보안 취약점
use(buf);       // 해제 후 사용 → 댕글링 포인터, 그 자리에 뭐가 들었을지 모름
셋 다 컴파일러가 못 잡아준다. 같은 메모리를 가리키는 포인터가 여러 개일 수 있어서 "이 시점 이후 아무도 안 쓴다"를 증명할 수 없기 때문이다. 그래서 나온 결론이 이것이다. "객체가 더 이상 안 쓰이는 시점"을 판정하는 일 자체를 아예 기계에게 넘겨버리자. 이게 GC다. 그런데 문제는 기계가 그걸 대체 어떻게 알 수 있냐는 것이다.
1. 참조 카운팅 (1960) — 세다가 0이 되면 회수
그래서 처음 생각해낸 것이 객체마다 "나를 가리키는 참조가 지금 몇 개인가"를 세어두자는 방법이다. 참조가 하나 생기면 +1, 하나 사라지면 −1, 그러다 0이 되는 순간 아무도 나를 안 가리킨다는 뜻이니 그 자리에서 즉시 회수한다. 예시로 살펴보자
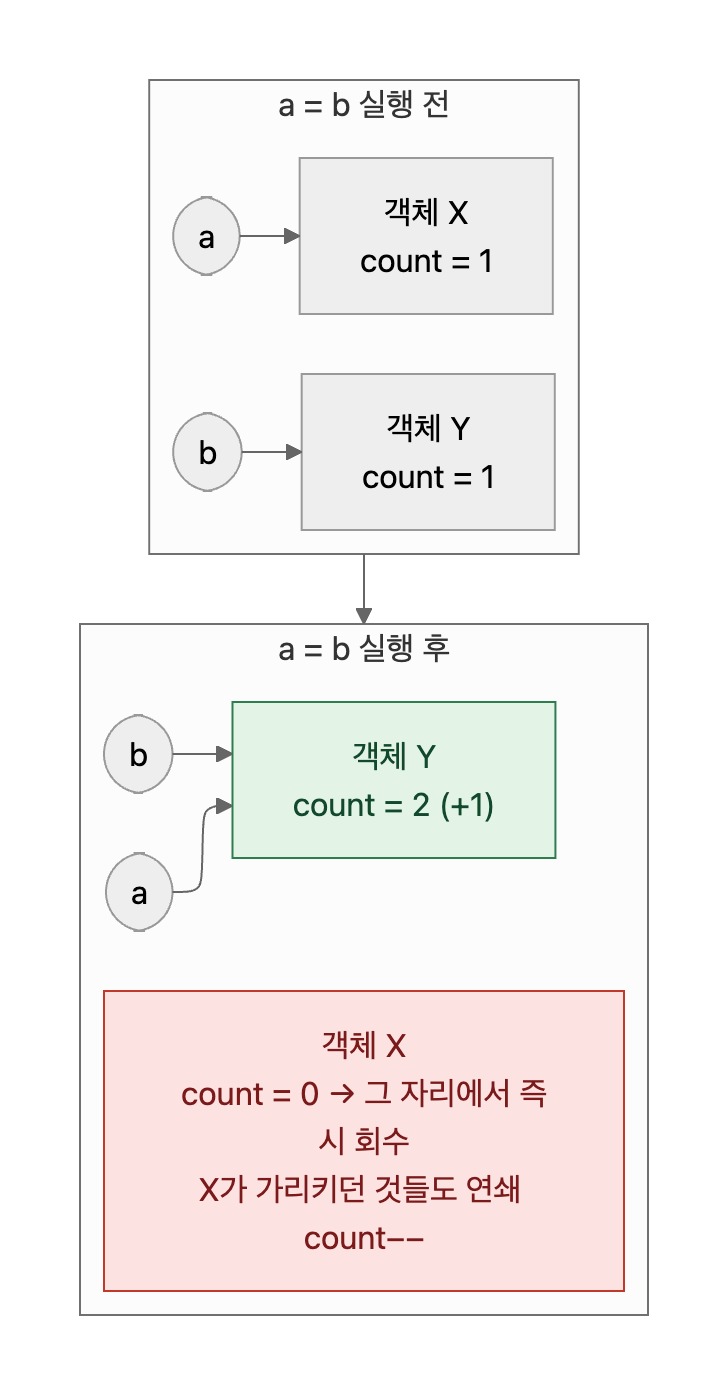
a = b;
// 실제로 벌어지는 일:
// b가 가리키는 객체의 count++         (새 참조 생김)
// a가 원래 가리키던 객체의 count--     (이전 참조 사라짐)
// 그 count가 0이 되면 → 즉시 해제, 그 객체가 가리키던 것들도 연쇄적으로 count--
이 방식의 장점은 회수가 즉각적이고 예시에 볼 수 있듯이 GC의 일이란 게 결국 대입문마다 따라붙는 카운트 증감 몇 번이 전부다. 이러다보니 "힙 전체를 훑는 청소 시간" 같은 별도의 큰 단계가 아예 없고 비용이 프로그램 실행 중간중간에 끼어 들어가는 형태다. 그래서 한 번에 오래 멈추는 일이 없다. 그래서 지금도 Python, Swift, C++의 `shared_ptr`이 이 방식을 보완하여서 사용한다.
그런데 해당 방식에는 치명적인 구멍이 하나 있다. 부모가 자식을 가리키고 자식이 다시 부모를 가리키는 트리를 생각해보자. 아주 흔한 코드다. 양방향 연결 리스트도 서로를 리스너로 등록한 객체 둘도 마찬가지다. 이런 덩어리를 아무도 안 쓰게 되는 순간을 그려보면
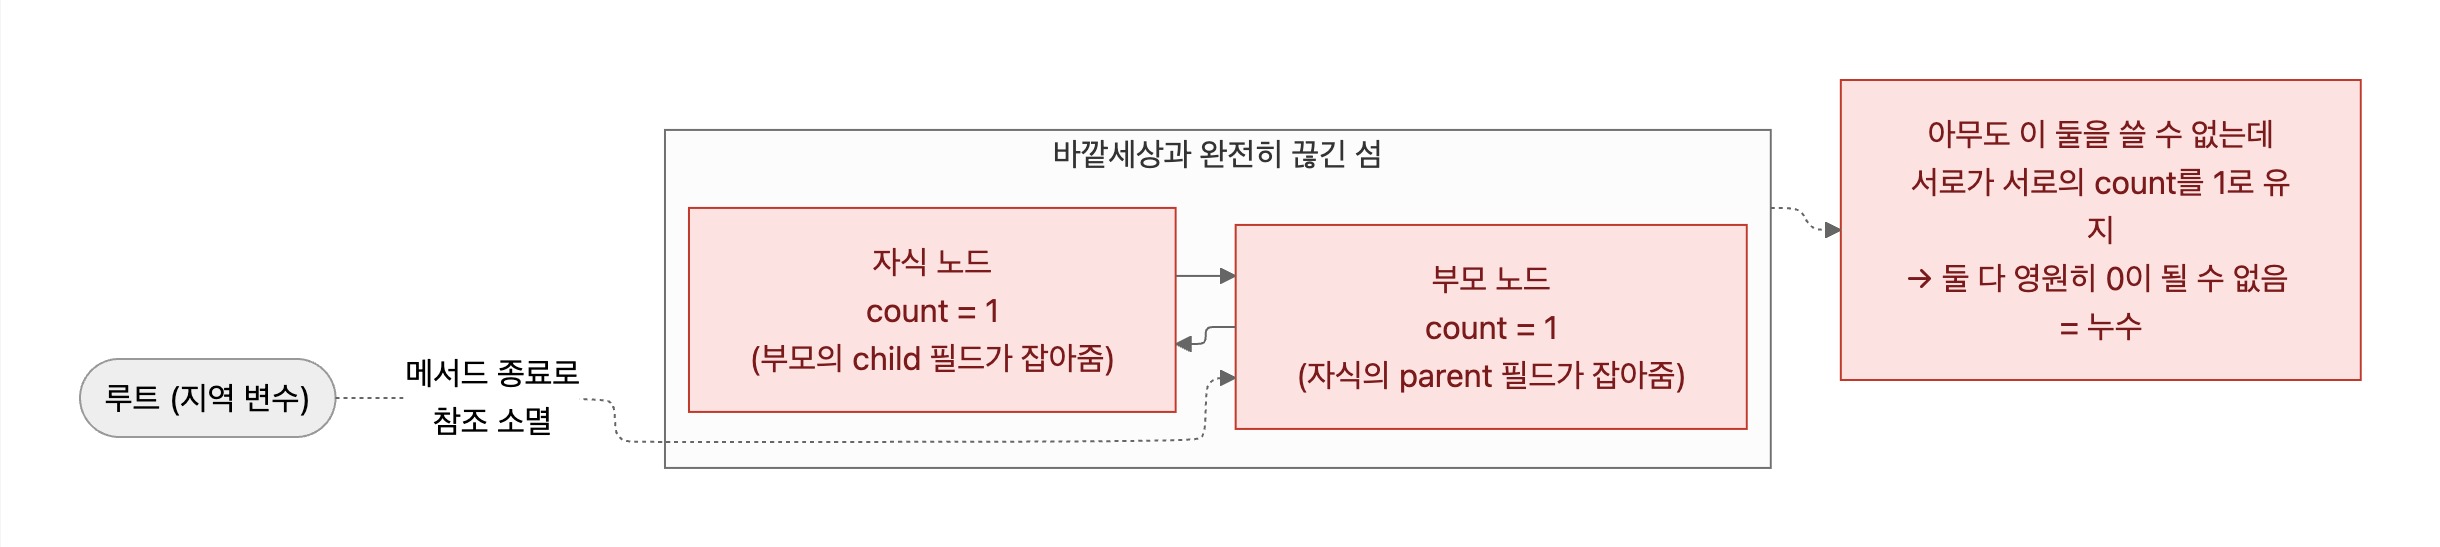
바깥세상과는 완전히 끊겼는데 서로가 서로의 카운트를 1로 붙잡고 있어서 영원히 회수되지 않는다. 자동 메모리 관리를 하겠다고 만든 장치에서 누수가 나는 것이다. 이것이 순환 참조 문제다.
문제는 또 있다. 위에서 봤듯 참조 하나 바꾸는 데 카운트 증감이 두 번씩 따라붙으니 모든 대입이 느려지고 멀티스레드에선 이게 원자적이어야 해서 더 비싸진다. 그리고 "멈춤이 없다"던 장점도 사실 완전하지 않다. 백만 노드짜리 연결 리스트의 head를 놓는 순간을 생각해보면 노드 1의 카운트가 0이 되고 그래서 노드 2의 카운트가 0이 되고… 백만 번의 연쇄 해제가 그 자리에서 한꺼번에 생긴다.
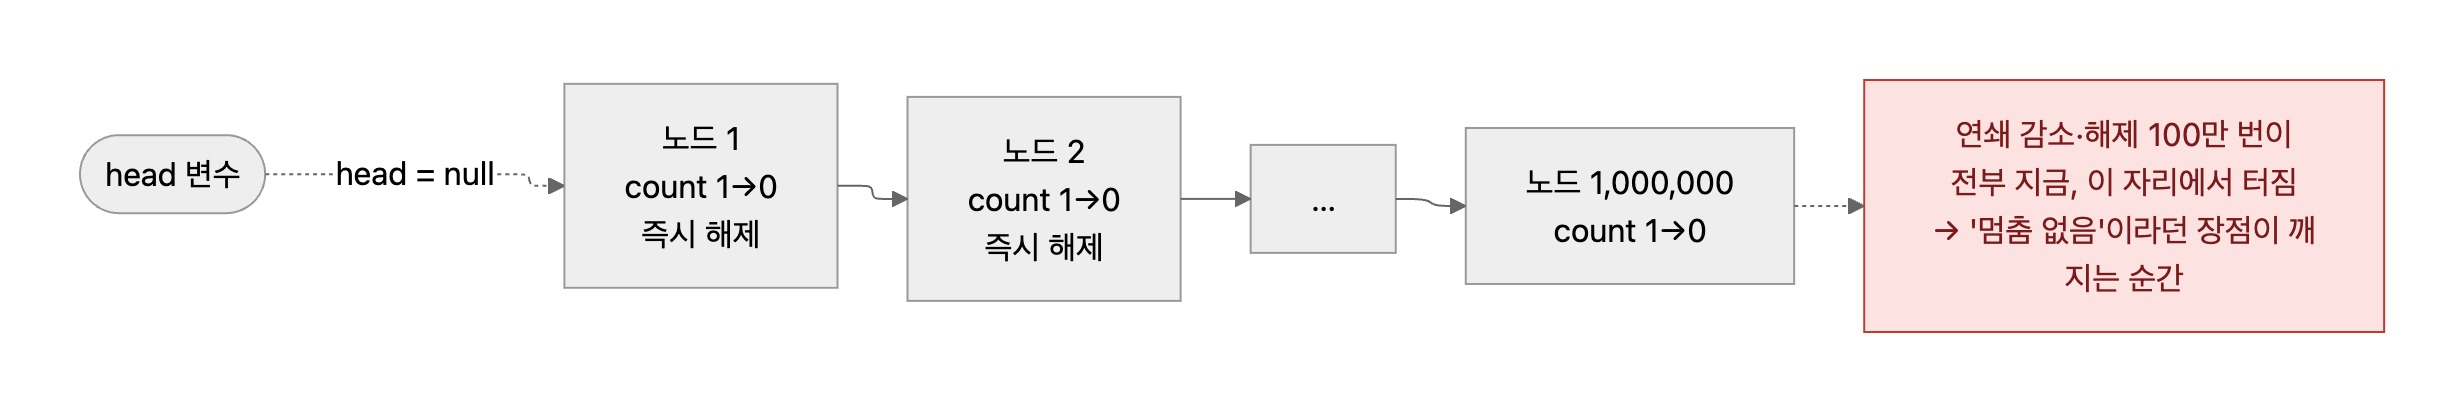
Java는 이 길을 처음부터 버렸다. 왜, 그리고 대신 뭘 택했는지가 다음 절이다.
2. Mark-Sweep (1960) — 세지 말고, 루트에서 따라가 보자
순환 참조가 왜 안 풀렸는지 곱씹어보면 답이 보인다. 아까 부모 자식 그림으로 생각해보면 부모의 count 1은 자식이 잡아준 것이고 자식의 count 1은 부모가 잡아준 것이었다. 그런데 그 자식은 지금 어떤 상태인가? 자기도 루트에서 끊긴 아무도 안 쓰는 쓰레기다. 즉 부모를 살아있다고 판정하게 만든 유일한 근거가 이미 죽은 객체가 보내는 참조인 셈이다. 죽은 놈이 가리키고 있어 봐야 그 참조를 통해 부모가 다시 쓰일 일은 영영 없다. 그런데도 카운트에는 산 놈의 참조든 죽은 놈의 참조든 똑같이 1로 잡힌다. 카운트는 나를 가리키는 참조의 개수만 셀 뿐 그 참조를 보낸 쪽이 살아있는지는 못 보는 것이다. 이 것이 각 객체가 자기 주변만 보는 지역적 정보의 한계다.
그럼 살아있다를 제대로 정의하면 뭘까. 결국 앞으로 코드가 이 객체를 다시 쓸 가능성이 있는가다. 그리고 코드가 어떤 객체에 접근하는 경로는 정해져 있다. 지금 실행 중인 메서드의 지역 변수나 static 필드처럼 코드에서 이름으로 직접 접근할 수 있는 변수들(이것들이 바로 GC 루트)에서 출발해 참조를 타고 타고 들어가는 수밖에 없다. 거꾸로 말하면 루트에서 아무리 참조를 따라가도 닿지 않는 객체는 count가 몇이든 두 번 다시 쓰일 수 없다. 그게 진짜 쓰레기다.
이 관점 전환을 처음 구현한 사람이 McCarthy다. 1960년, 자동 메모리 관리를 처음으로 내장한 언어인 Lisp을 만들면서 객체마다 참조의 카운트를 세는 대신 루트에서 출발해 참조를 실제로 따라가 보는방식을 택했다. 따라가서 닿으면 산 것, 못 닿으면 쓰레기라고 판정을 짓게 하였다. 그래서 이 계열을 추적(tracing) GC라고 부른다.
동작은 두 단계다. 먼저 Mark다. GC 루트에서 출발해 참조를 따라 그래프를 탐색하면서 만나는 객체마다 헤더의 mark 비트를 켠다. 여기서 1절의 순환 문제가 어떻게 되는지 그림을 통해 보자
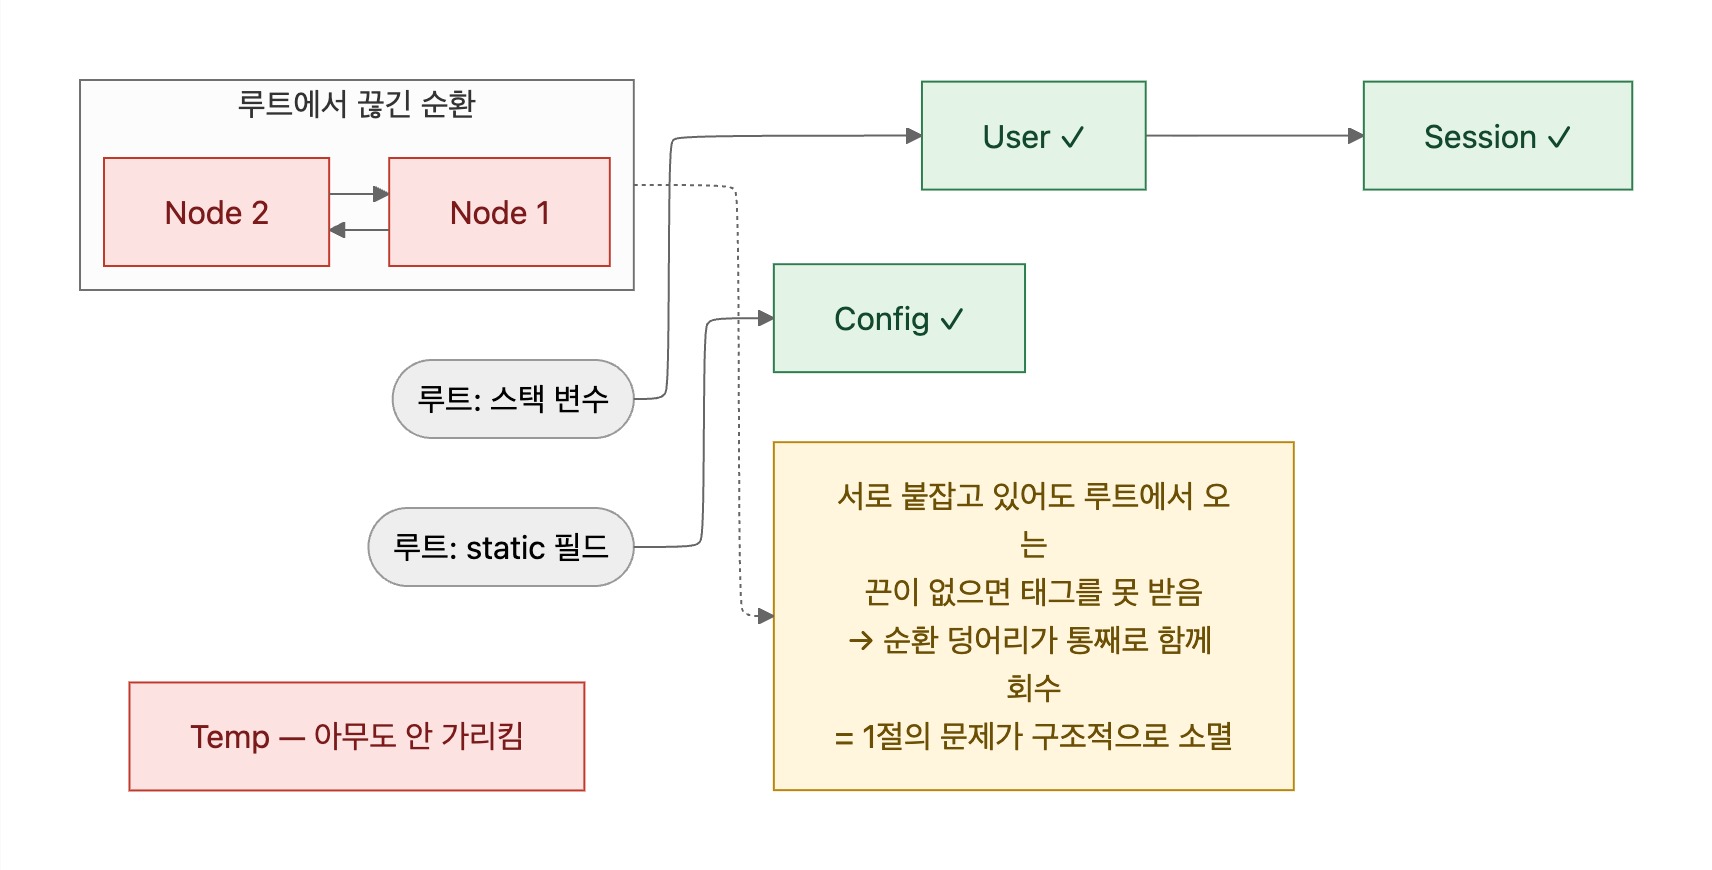
Node 1과 2가 아무리 서로를 붙잡고 있어도 루트에서 오는 끈이 끊기면 둘 다 태그를 못 받는다. 그러니 자연히 함께 회수된다. 순환 참조가 특별 처리 없이 구조적으로 풀려버린 것이다.
다음은 Sweep이다. 힙을 처음부터 끝까지 선형으로 훑으면서 mark 안 된 블록들을 free list(빈 칸 연결 리스트)에 매단다. 이후에 객체를 선언하는 new가 들어오면 이 리스트에서 요청 크기에 맞는 구멍을 찾아서 채운다.
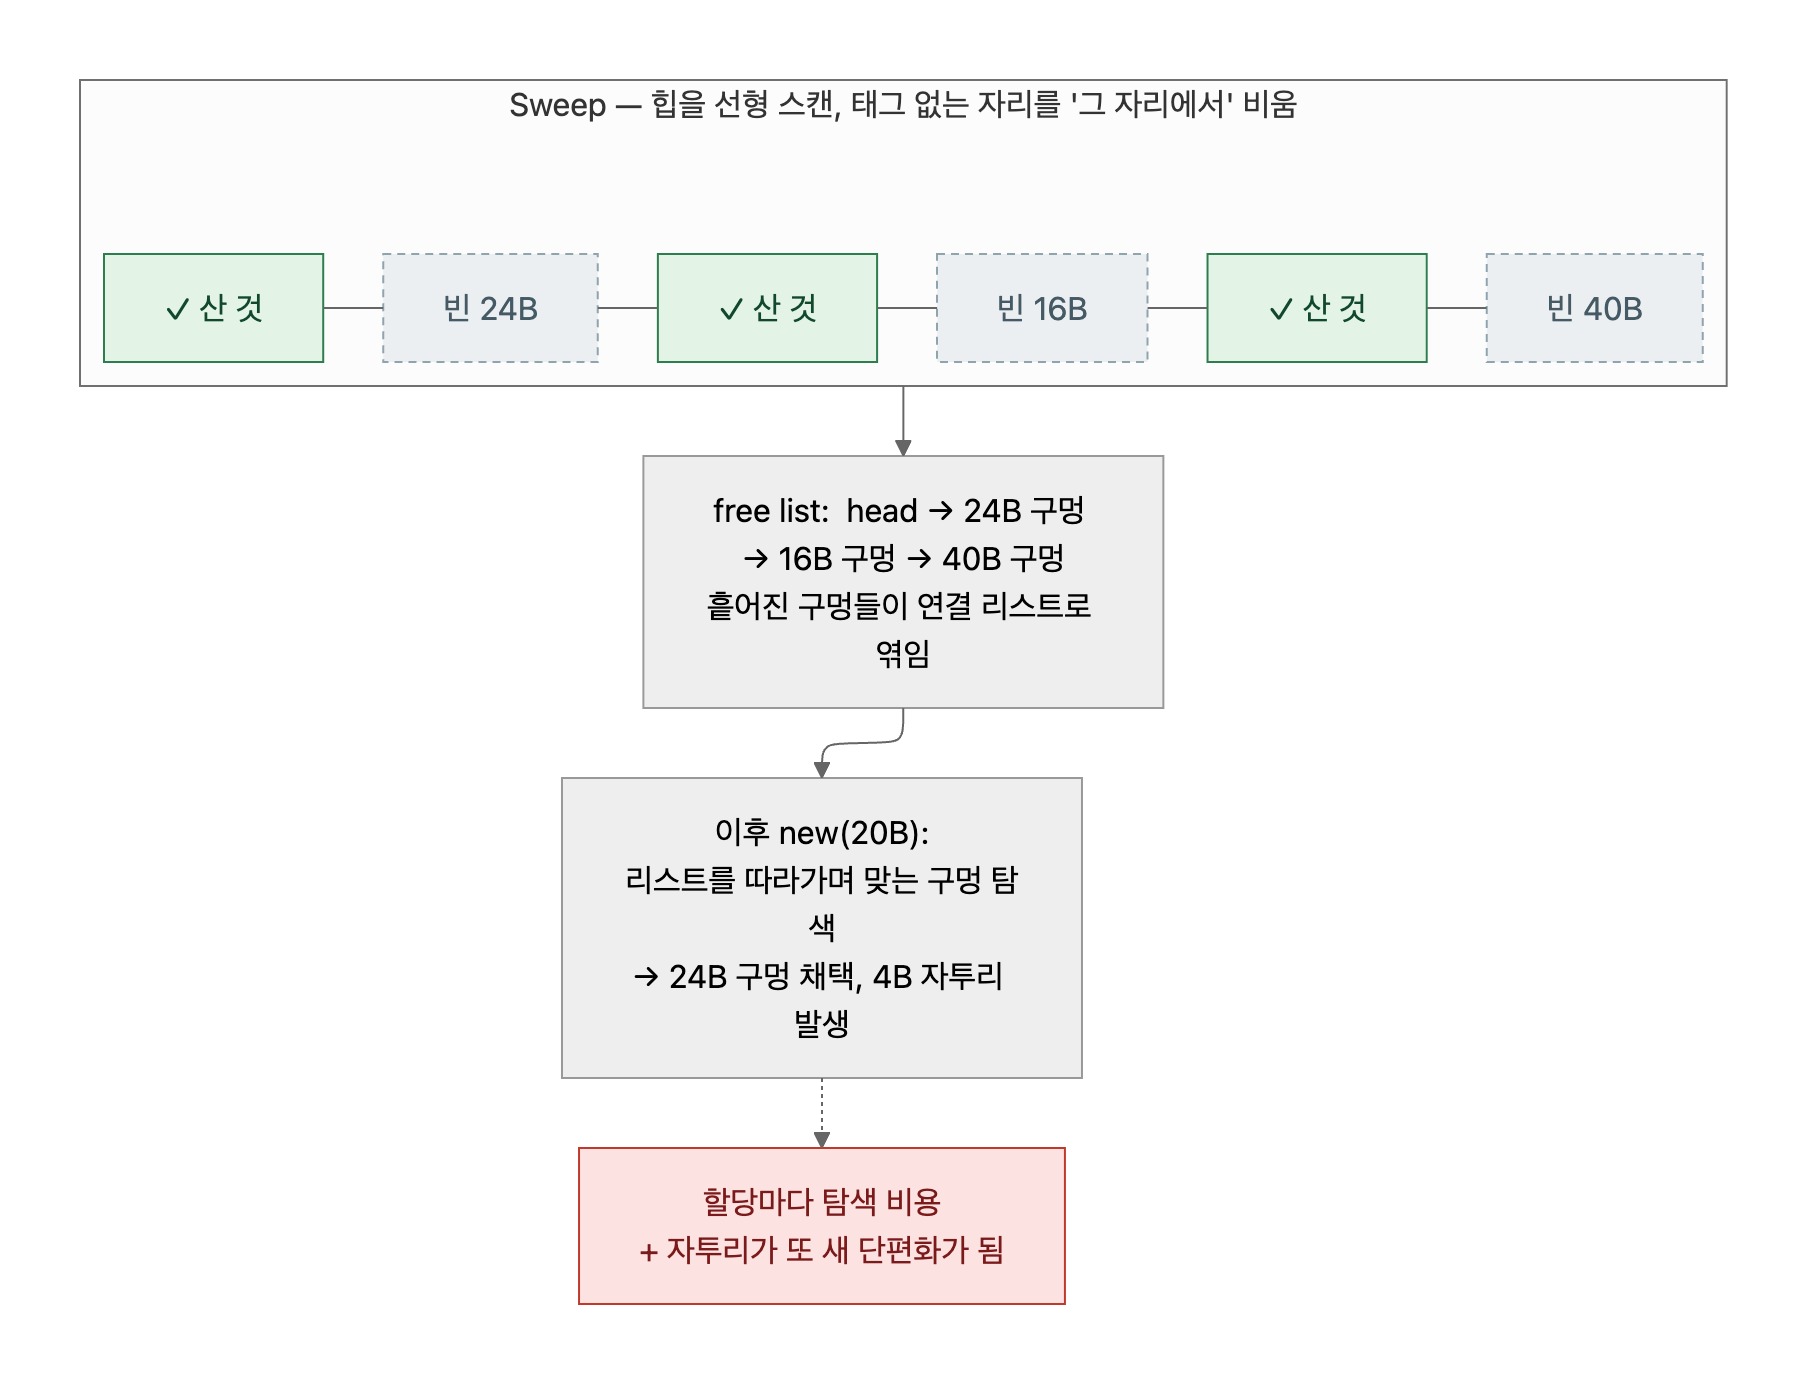
위 그림을 보면 다음에 발생할 문제를 확인 할 수 있다. 죽은 자리를 "그 자리에서" 비우다 보니 빈 칸이 힙 곳곳에 제각각 크기로 조각조각 흩어진다는 점이다. 이걸 단편화(fragmentation)라고 부르는데 오래 쌓이면 어이없는 일이 벌어진다. 여유 공간을 다 합치면 100MB나 남았는데 1MB짜리 연속 공간이 하나도 없어서 1MB 할당을 진행 하는 것에 OutOfMemoryError가 나는 것이다. 공간은 남았는데 쓸 수가 없다.
그리고 문제가 하나 더 있다. 이 모든 과정을 애플리케이션을 완전히 세워둔 채(Stop-the-World) 진행해야 한다는 것이다. 왜 멈춰야 할까? 탐색하는 도중에 앱이 참조를 바꿔버린다고 상상해보자. 방금 탐색 끝이라고 표시한 객체에 새 참조가 꽂히면 그 끝에 매달린 산 객체들을 통째로 놓치고 회수해버릴 수도 있다. 이걸 멈추지 않고 푸는 방법은 한참 뒤에야 등장하고 당시에는 답을 미루고 일단 세상을 세우는 쪽을 택했다.
3. Mark-Compact — 치운 자리를 밀어붙이자
단편화를 해결하는 가장 직관적인 방법은 뭘까. sweep으로 구멍을 내지 말고 mark가 끝난 뒤에 살아있는 객체들을 힙 한쪽 끝으로 빈틈없이 밀어붙이면 된다. 산 것들이 앞쪽에 밀집하고 뒤는 통짜 빈 공간이 되니 단편화가 사라진다. 할당도 아주 단순해진다. 빈 공간이 한 덩어리니까 빈 공간의 시작을 가리키는 포인터 하나만 두면 되고 객체 할당을 하게 되면 그 자리에 객체를 놓고 포인터를 객체 크기만큼 뒤로 밀면 끝이다. free list를 뒤지며 맞는 구멍을 찾아다닐 필요가 없어지는 것이다. 이 방식을 bump 할당이라고 부른다.
전과 후를 보면 얼마나 깔끔한지 알 수 있다
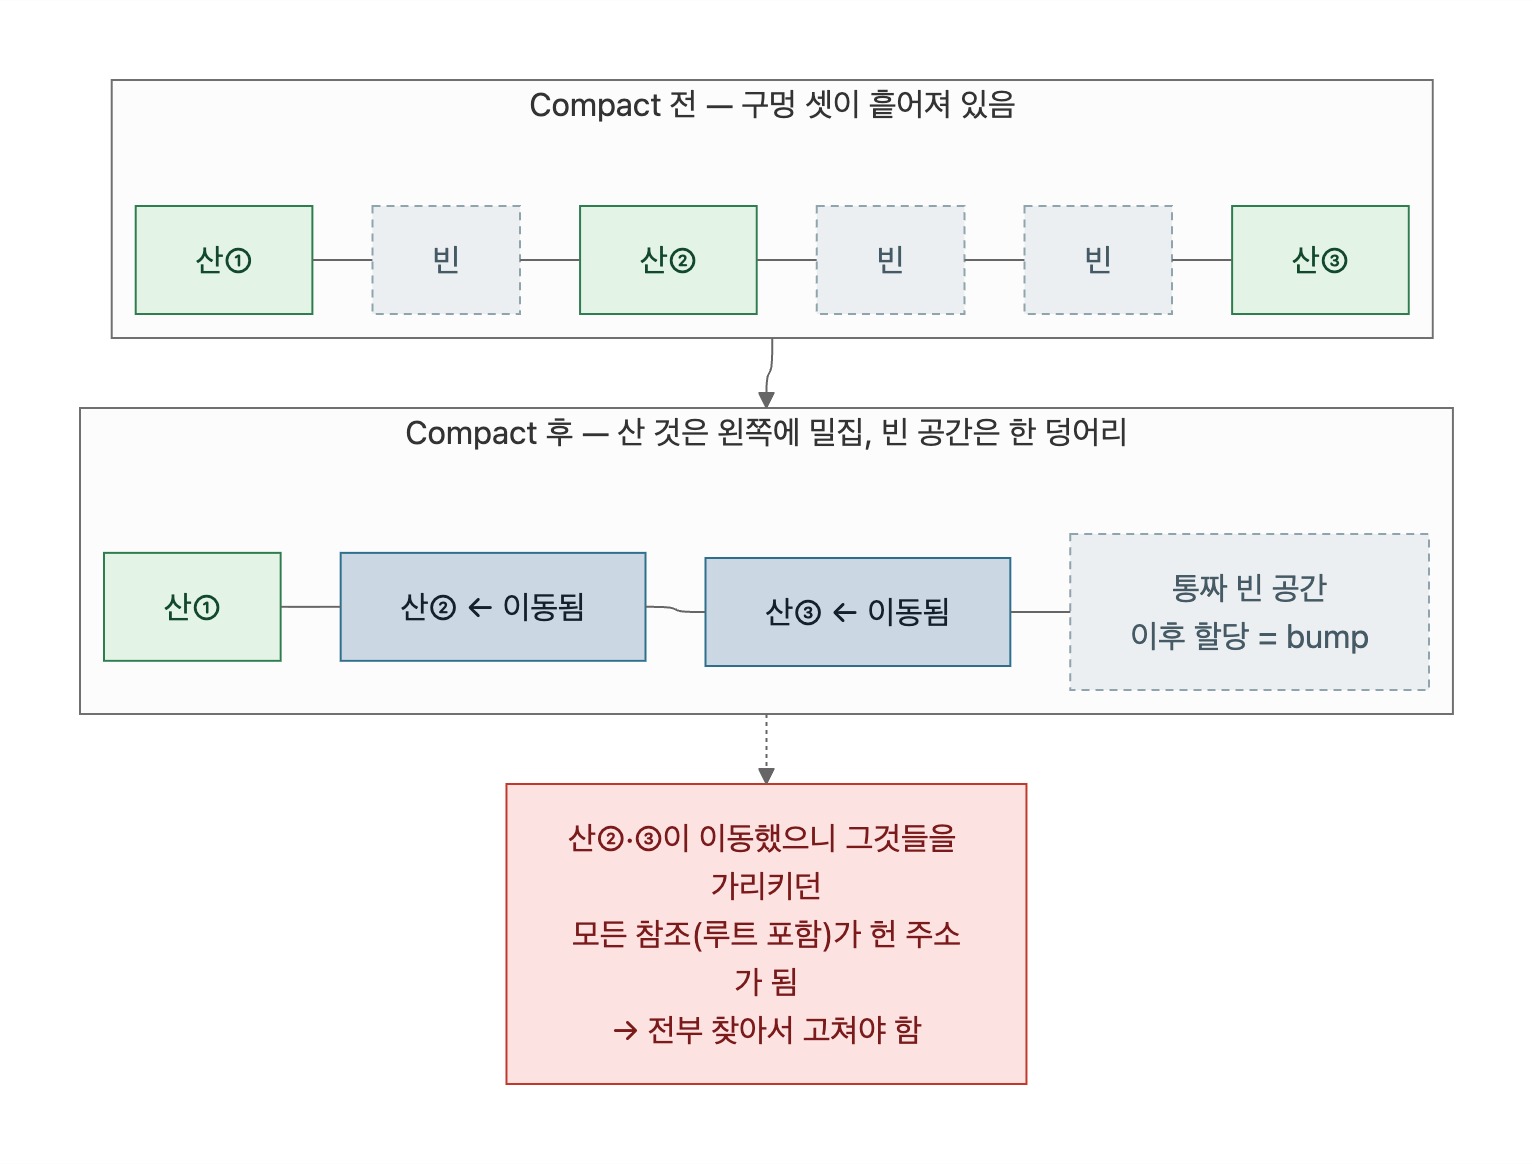
그런데 위 그림의 주석에 이미 문제가 적혀 있다. 객체를 옮기면 그 객체를 가리키던 모든 참조가 헌 주소가 된다. 전부 찾아서 고쳐줘야 한다. 이 작업에 실제로 얼마나 많은 일이 필요한지 보자. 가장 고전적인 mark-compact 알고리즘은 mark가 끝난 뒤에도 힙 전체를 세 번이나 더 훑어야 한다.
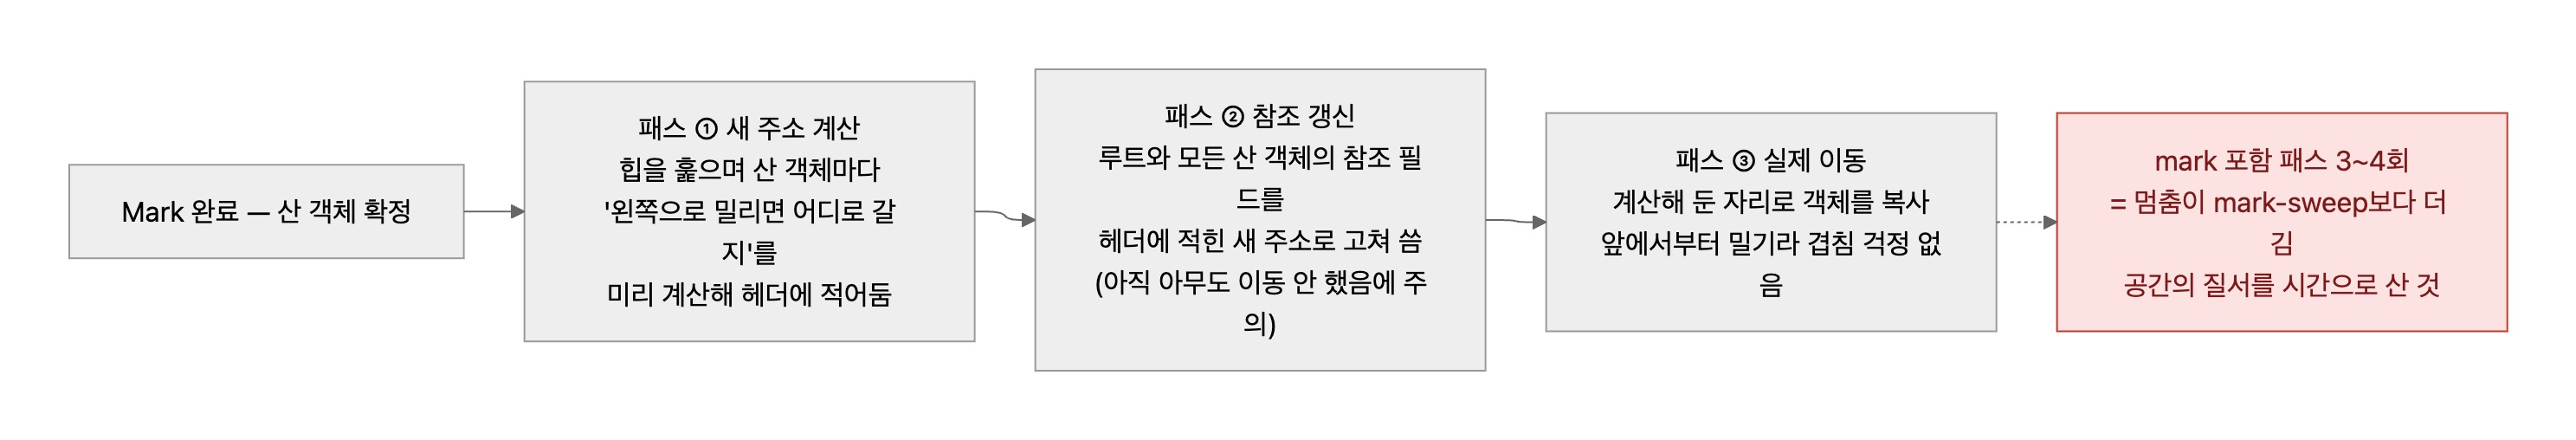
이렇게 힙을 훑다보니 멈춤은 mark-sweep보다 오히려 길어진다. 단편화를 없애는 대신 그만큼의 훑기 작업을 추가로 감수한 것이다. 그리고 여기서 GC 역사 전체를 관통하는 딜레마를 처음으로 확인할 수 있다. 이동을 하자니 참조를 전부 찾아 고치는 작업이 따라붙고, 이동을 안 하자니 단편화가 쌓인다는 것이다. mark-compact 알고리즘은 그 중 이동 쪽을 택하였고 좀 더 긴 멈춤이라는 대가를 치뤘다.
4. Copying / Semi-space (1969~70) — 산 것만 이사 가자
2절도 3절도 공통의 찜찜함이 있다. 작업량이 힙 크기에 묶여 있다는 점이다. sweep이든 compact든 어느 자리가 비었는지 확인하려면 결국 힙의 모든 블록을 처음부터 끝까지 지나가야 한다. 그래서 힙에 쓰레기가 아무리 많아도 훑어야 하는 양은 조금도 줄지 않는다. GC란 죽은 객체를 치우려고 하는 일인데 정작 그 비용은 죽은 객체의 양이 아니라 힙 전체의 크기가 결정하는 것이다
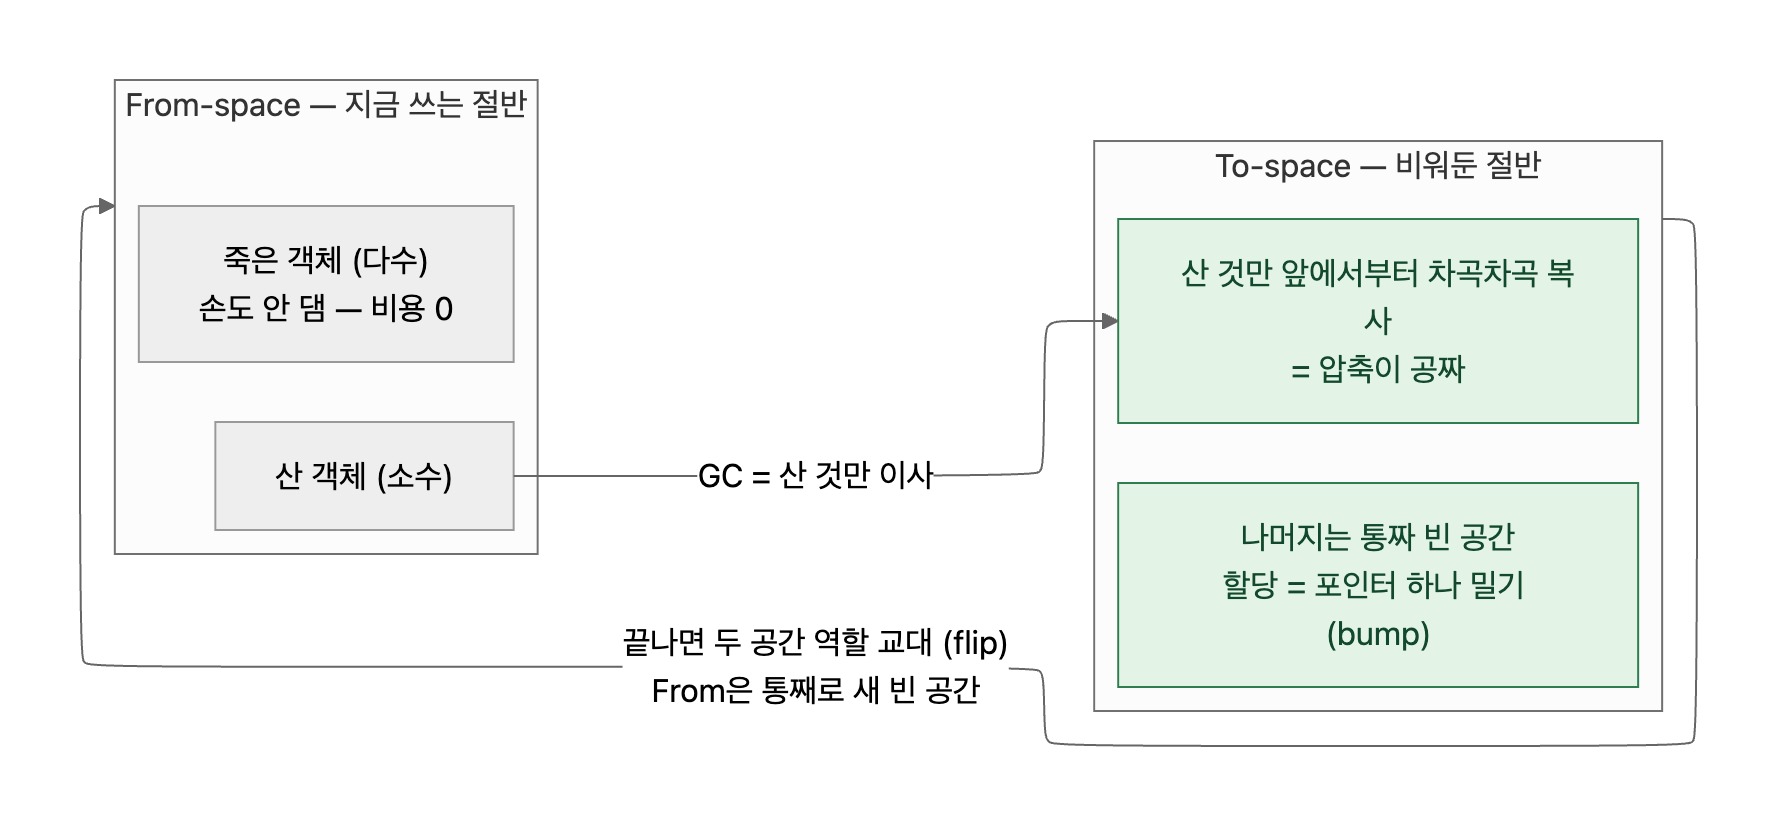
그래서 Fenichel–Yochelson과 Cheney가 발상을 뒤집는다. 죽은 것을 치우지 말고, 산 것만 새 공간으로 이사시킨 다음 헌 공간을 통째로 버리자. 실제 이사와 똑같다. 쓰레기를 하나하나 골라 버리는 게 아니라 쓸 물건만 새집에 옮기면 헌 집에 남은 건 자동으로 전부 버려진 셈이 된다.
구현은 힙을 절반으로 나누는 것에서 시작한다.
그럼 산 객체들을 실제로 어떻게 복사할까. 준비물은 To-space 위의 포인터 두 개가 전부다.
- free는 다음 객체를 복사해 넣을 자리를 가리킨다. 객체를 하나 복사할 때마다 그 크기만큼 뒤로 밀린다.
- scan은 복사돼 들어온 객체들 중 "아직 속을 안 열어본 첫 번째 객체"를 가리킨다. 여기서 속을 연다는 건 그 객체의 참조 필드들을 확인해서 그 객체가 가리키는 것들까지 마저 복사해 오는 일이다.
그러니까 To-space를 앞에서부터 보면 항상 처리까지 끝난 객체들, 복사만 되고 아직 처리 안 된 객체들, 빈 공간 세 구간으로 나뉘고 scan과 free가 각각 두 번째와 세 번째 구간의 시작점이다. 가운데 구간(복사만 되고 아직 처리 안 된 객체들)이 곧 할 일 목록이라서 별도의 큐가 필요 없다. 이제 실제 흐름을 작은 예시로 따라가 보자. 루트가 X와 Y를 가리키고 X와 Y가 둘 다 Z를 가리키는 상황이다.
- 시작. 루트가 직접 가리키는 X와 Y를 To로 복사한다. To는 X, Y가 되고 free는 Y 뒤를, scan은 맨 앞 X를 가리킨다. 그리고 From의 X와 Y가 있던 자리에는 X로 이사 갔음, Y로 이사 갔음이라는 안내문(forwarding pointer)을 남겨둔다.
- scan이 가리키는 X의 속을 연다. X는 Z를 가리키는데 Z는 아직 From에 있다. 그러니 Z도 To로 복사한다. To는 X, Y, Z, free는 Z 뒤로 전진, From의 Z 자리에도 안내문을 남긴다. X 처리가 끝났으니 scan은 다음 객체인 Y로 이동한다.
- Y의 속을 연다. Y도 Z를 가리킨다. 그런데 From의 Z 자리에 가보니 이미 안내문이 붙어 있다. 그럼 복사는 하지 않고 Y 안의 참조만 Z의 주소로 고쳐 쓴다. 같은 객체가 두 번 복사되는 사고를 안내문이 막아주는 것이다. scan은 Z로 이동한다.
- Z의 속을 연다. 더 가리키는 게 없으니 그대로 끝. scan이 한 칸 이동하면 free와 같은 위치가 된다. 할 일 목록이 비었다는 뜻이고 이 순간이 종료다. 루트에서 닿는 모든 객체가 To에 복사된 상태다.
- 마지막으로 두 공간의 역할을 교대한다(flip). From은 통째로 새 빈 공간이 된다.
이 예시가 끝난 순간의 두 공간을 그림으로 보면 이렇다.
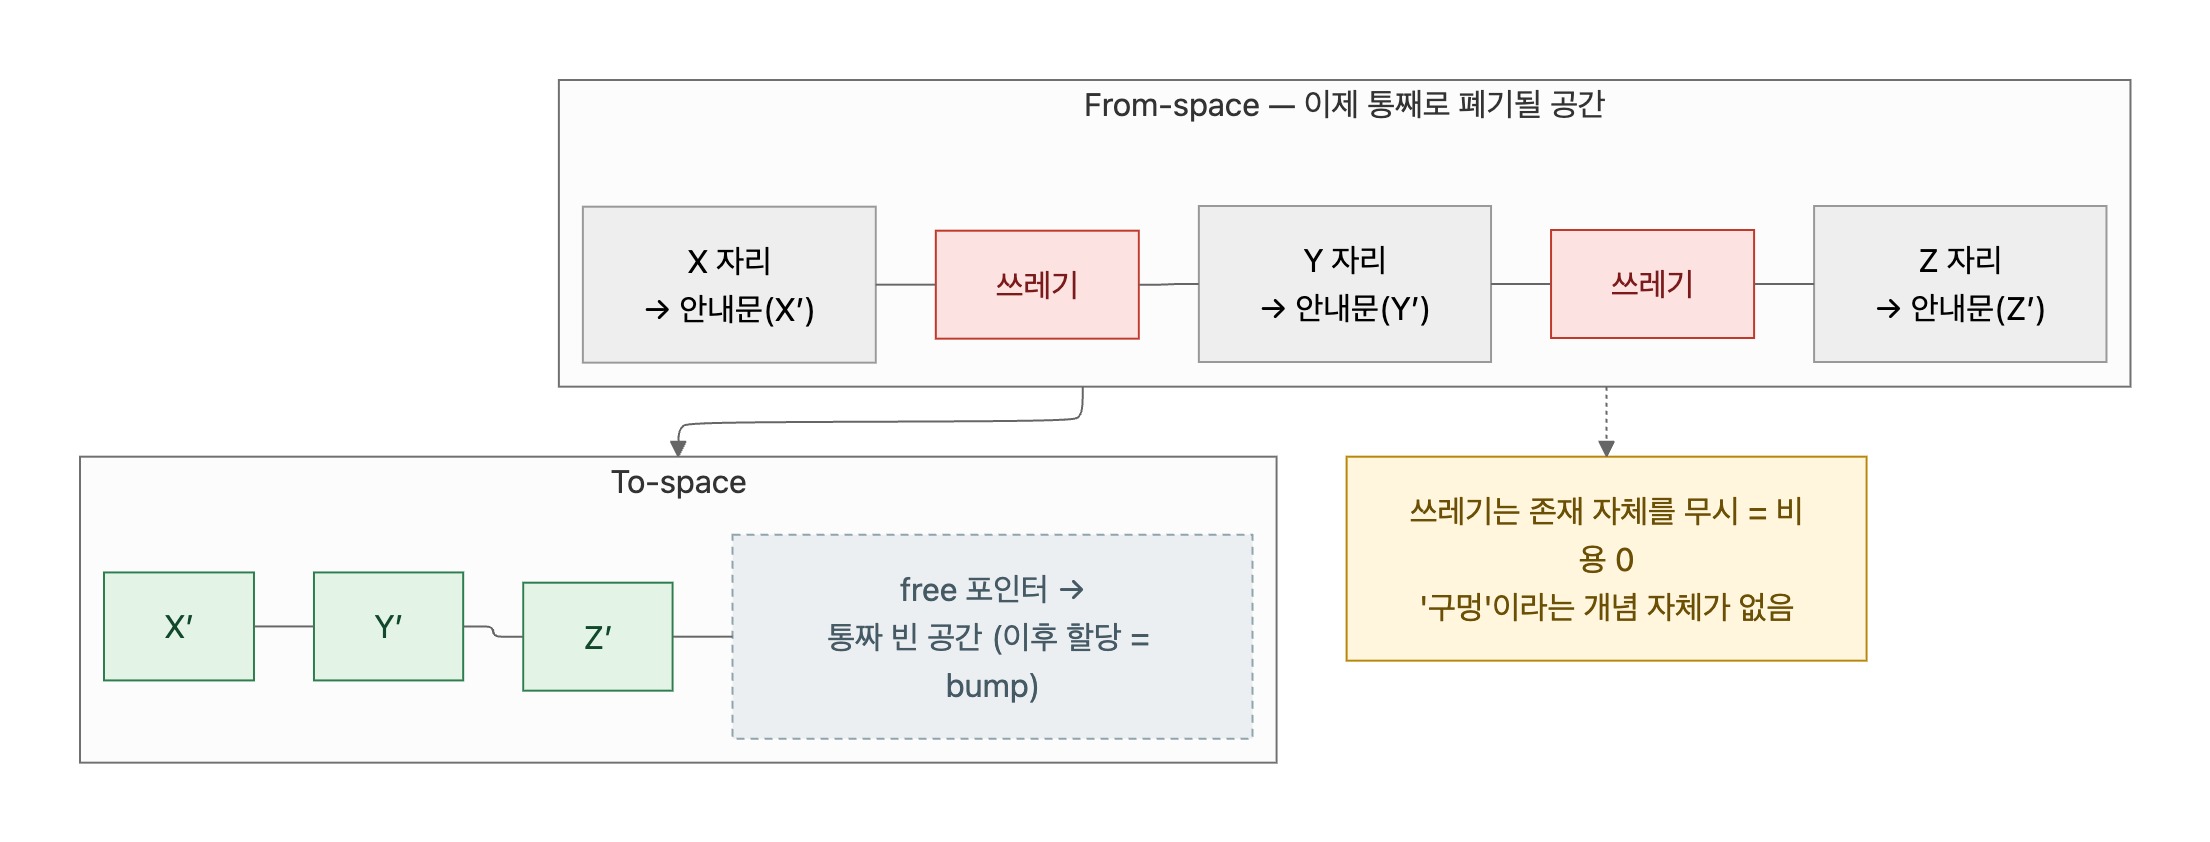
여기서 눈여겨볼 점이 있다. 위 과정 내내 우리가 손댄 객체는 전부 산 객체들 뿐이었다는 것이다. 루트에서 참조를 따라가며 진행하니 애초에 산 객체에만 도착하게 되고 루트에서 닿지 않는 죽은 객체들의 자리에는 한 번도 찾아가지 않는다. 복사는커녕 죽었는지 확인하는 작업조차 없다. 2절의 sweep은 죽은 자리를 골라내려고 힙 전체를 지나가야 했는데 여기서는 죽은 객체를 치우는 작업 자체가 존재하지 않는 것이다. From-space를 통째로 버리는 순간 그 안에 있던 쓰레기도 같이 사라질 뿐이다.
이 한 번의 발상 전환으로 세 가지 문제가 한꺼번에 잡힌다. 비용이 산 객체에만 비례하고(살아남는 게 1%면 1%만 복사하니, 쓰레기가 많을수록 오히려 빨라지는 역설) 복사하며 차곡차곡 쌓으니 3절이 힙 전체 훑기 세 번을 들여 얻었던 압축이 별도 작업 없이 따라오며 할당은 bump가 되어 2절의 free list 문제도 사라진다. 물론 이로 인해서 잃는 것도 있다. 힙의 절반이 항상 놀아야 한다. 그리고 더 큰 문제가 있는데 오래 사는 객체를 매 사이클 다시 복사해야 한다는 것이다. 캐시, 싱글턴, 커넥션 풀처럼 절대 안 죽는 것들을 GC 돌 때마다 왼쪽 집→오른쪽 집→왼쪽 집… 영원히 이사시키는 건 순수 낭비다. 그러니까 copying은 "금방 죽는 다수"에겐 완벽하고 "오래 사는 소수"에겐 최악이다.
여기서 우리는 생각할 수 있다.
그럼 둘을 분리해서 각자에게 맞는 방법을 쓰면 되지 않을까?
5. Generational (1984) — 통계를 믿고 힙을 쪼개자
그 "분리하자"는 아이디어에 근거를 준 것이 Ungar의 관찰(1984)이다. 실제 프로그램을 측정해봤더니 객체 대부분은 만들어지자마자 죽더라는 것이다. 이게 그 유명한 약한 세대 가설(weak generational hypothesis)이다. 실제 코드를 떠올려보면 수긍이 간다. 반복문을 한 바퀴 돌 때마다 만들어지는 임시 문자열은 다음 바퀴가 시작되기도 전에 쓸모를 다한다. 웹 서버라면 요청 하나를 처리하는 동안 만든 객체들 대부분이 응답을 보내는 순간 전부 필요 없어진다. 이런 식으로 할당의 대다수는 태어난 지 몇 ms 안에 쓰레기가 되고 반대로 캐시나 커넥션 풀처럼 프로그램이 끝날 때까지 사는 소수가 있다. 수명이 극단적으로 갈리는 두 부류가 한 힙에 섞여 있는 셈이니 모든 객체를 똑같이 다룰 이유가 없다. 이 통계에 맞춰 부류별로 알고리즘을 배치하면 된다.
그래서 힙을 둘로 쪼갠다. 갓 태어난 것들이 사는 Young에는 "금방 죽는 다수"에 완벽한 copying을, 오래 살아남은 것들이 사는 Old에는 mark-compact를 배치한다.
Young의 내부 구조부터 보자. Young은 다시 세 칸으로 나뉜다.
- Eden: 모든 새 객체가 태어나는 곳. new로 만들어지는 객체는 일단 전부 여기에 놓인다.
- Survivor S0, S1: Eden 옆에 붙은 작은 칸 두 개. 이 한 쌍이 바로 4절의 From/To-space다. Eden에서 살아남은 객체들이 GC 때마다 이 둘 사이를 복사되며 왕복한다.
그리고 Young에서 오래 버틴 객체가 최종적으로 넘어가는 큰 구역이 Old다.
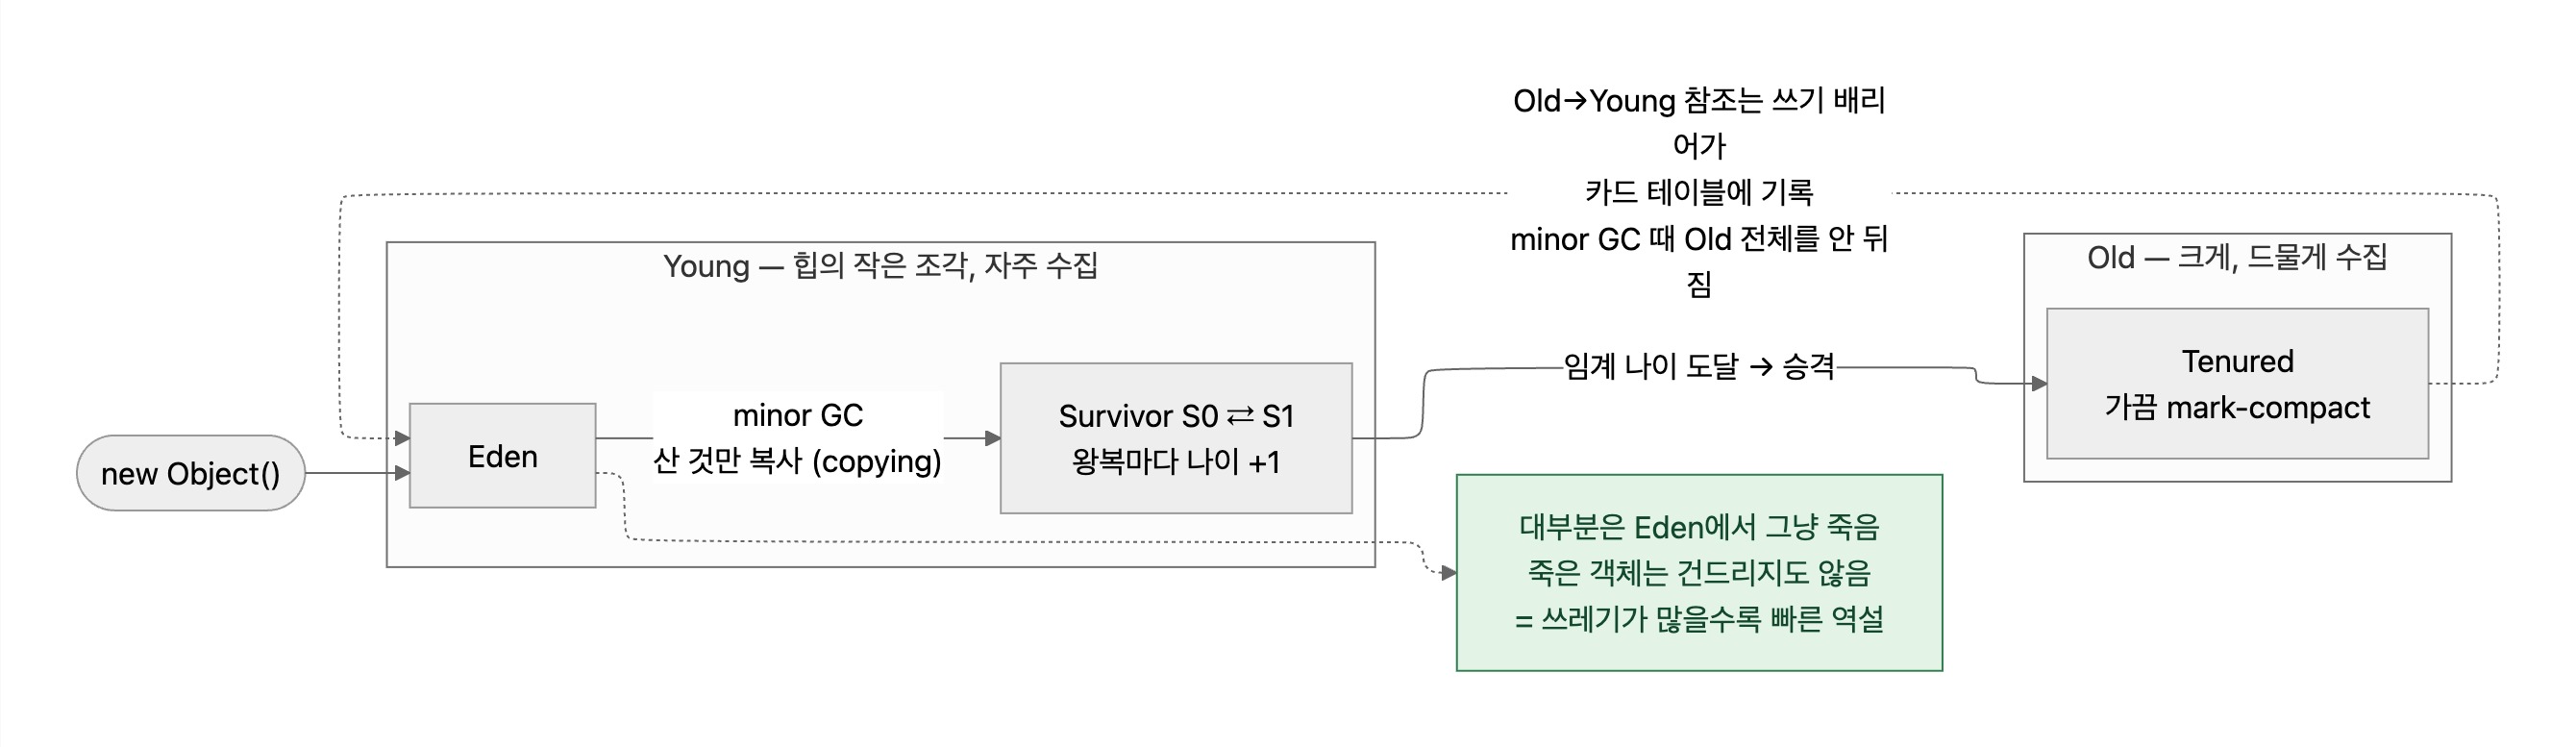
이제 객체 하나의 일생을 따라가 보자.
- 객체가 만들어지면 전부 Eden에 놓인다. Eden은 통짜 빈 공간이라 bump 할당이다. 그래서 Java에서 객체 할당은 포인터 하나 미는 수준으로 싸다.
- Eden이 가득 차면 minor GC가 돈다. Eden과 현재 사용 중인 Survivor 한쪽의 산 객체만 반대쪽 Survivor로 복사한다. 4절의 copying 그대로다. 세대 가설대로라면 이 시점에 대다수는 이미 죽어 있으니 복사할 양이 적고, 끝나면 Eden은 통째로 빈 공간이 된다.
- 객체는 minor GC에서 살아남을 때마다 헤더에 적힌 나이가 1씩 오른다. 이 나이가 임계값(기본 15 근처)을 넘으면 Old로 옮겨진다. 이걸 승격(promotion) 이라고 한다. "오래 사는 부류"로 판정된 것이니 더는 GC마다 복사하지 않는다. 4절의 문제였던 수명이 긴 객체 반복 복사가 여기서 풀린다
그럼 4절의 또 다른 문제였던 "힙 절반 낭비"는 어떻게 됐을까. Survivor 한 쌍이 semi-space인 건 맞지만 크기를 비대칭으로 잡는다. 어차피 대다수가 Eden에서 죽으니 복사받는 쪽이 클 필요가 없기 때문이다. 기본 비율이 Eden 8 : S0 1 : S1 1이라 놀리는 공간이 절반이 아니라 Young의 10% 수준으로 내려온다.
그런데 구멍이 하나 있다. minor GC는 Young만 본다. 그런데 이런 코드가 있다면?
oldCache.put(key, youngValue); // Old에 있는 캐시가 → 갓 태어난 객체를 가리킴
이 코드가 왜 문제를 일으키는지, `youngValue`가 가리키는 객체를 V라고 부르고 시간 순서대로 그림으로 따라가 보자.
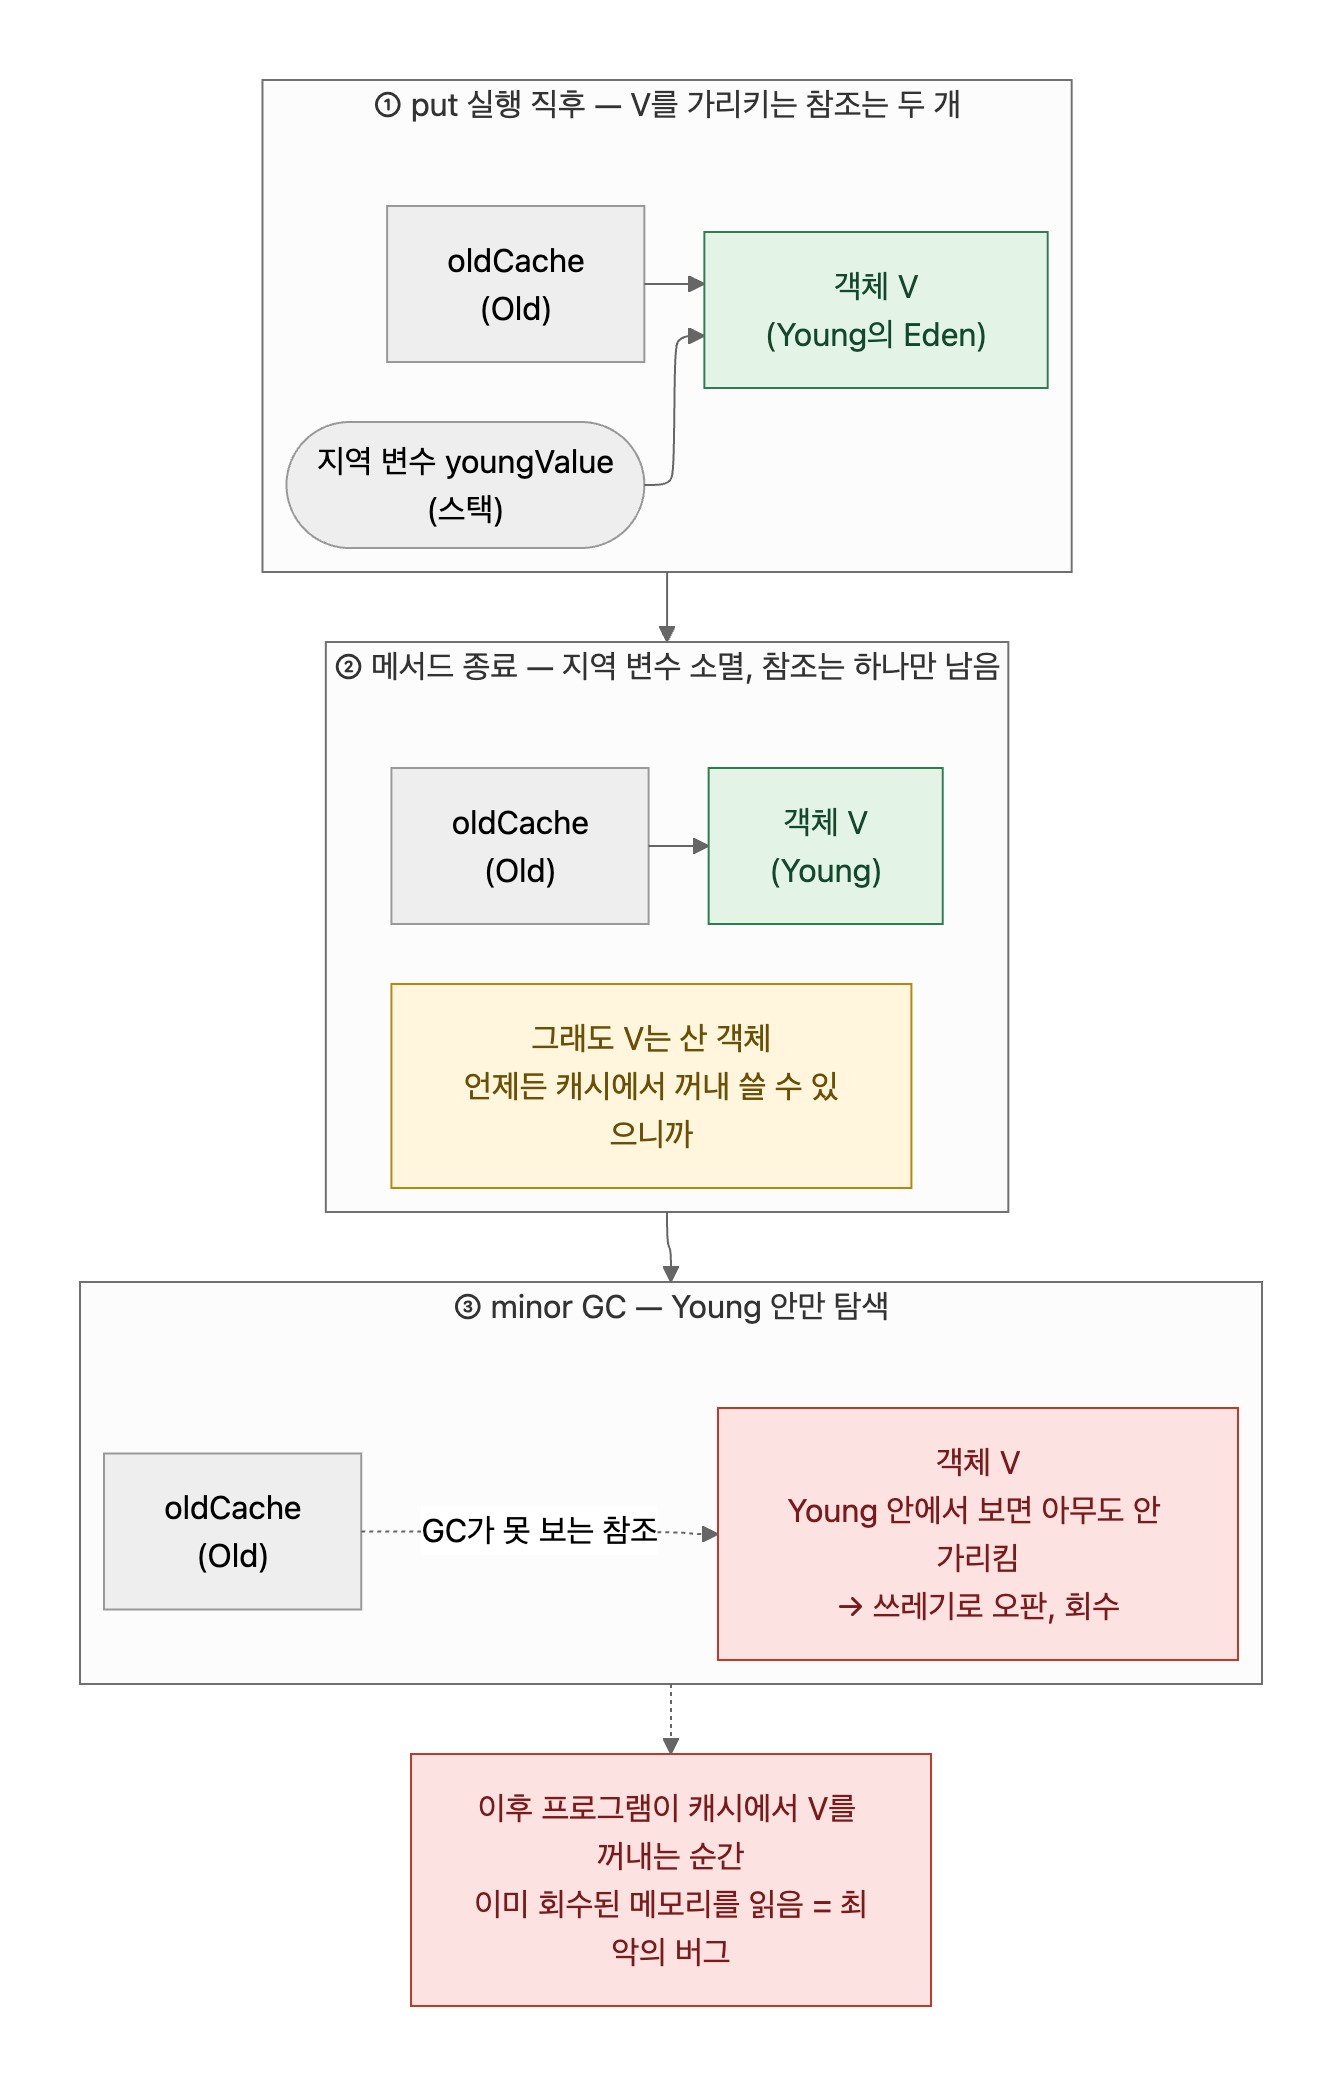
1에서 V를 가리키는 참조는 두 개다. 스택의 지역 변수와 Old에 있는 캐시의 필드. 2에서 메서드가 끝나 지역 변수가 사라지면 캐시의 필드 하나만 남는다. 그래도 V는 여전히 산 객체다. 언제든 캐시에서 꺼내 쓸 수 있으니까. 문제는 3이다. minor GC는 Young 안만 탐색하니 V의 유일한 생존 근거인 Old에서 오는 참조를 볼 수 없다. GC 입장에서 V는 아무도 안 가리키는 객체로 보이고 그대로 회수된다. 그리고 나중에 프로그램이 캐시에서 V를 꺼내는 순간 이미 회수된 메모리를 읽게 된다.
그렇다고 minor GC 때마다 Young을 가리키는 참조가 있는지 Old 전체를 뒤질 수도 없다. 작은 Young만 빠르게 치우려고 세대를 나눈 의미가 사라지기 때문이다. 참고로 반대 방향 즉 Young 객체가 Old 객체를 가리키는 건 문제가 안 된다. minor GC는 Old를 회수하지 않으니 그쪽 참조는 놓쳐도 잘못될 게 없다.
문제를 정리하면 이렇다. Old에서 Young으로 들어오는 참조가 어디에 있는지 알아야 하는데, Old 전체를 뒤지지 않고 알아낼 방법이 필요하다. 여기서 생각을 바꿔보면 참조가 만들어지는 바로 그 순간을 붙잡으면 된다. 어차피 Old→Young 참조는 누군가 Old 객체의 필드에 대입을 실행해야만 생긴다. 그러니 참조를 저장하는 코드가 실행될 때마다 "여기에 뭔가 썼다"는 기록을 자동으로 남기게 하면 나중에 그 기록만 확인하면 된다. 이렇게 참조를 읽거나 쓰는 순간에 끼어들어 GC를 위한 일을 해주는 장치를 배리어(barrier) 라고 부른다.
구현은 컴파일러가 모든 참조 저장 코드 뒤에 기록용 명령 몇 개를 자동으로 붙여 넣는 식이다.
obj.field = value;
// JIT이 뒤에 붙이는 쓰기 배리어 (개념적으로)
CARD_TABLE[ &obj.field >> 9 ] = DIRTY;   // "힙의 이 512바이트 구역(카드)에 뭔가 썼음"
힙을 512바이트 단위 카드로 나눈 바이트 배열이 카드 테이블이다. minor GC는 이제 Old 전체가 아니라 더러워진 카드의 512바이트씩만 확인하면 된다. 아파트 전 세대를 탐문하는 대신 방문 기록이 남은 집만 가보는 것이다.그럼 아까 회수될 뻔했던 V의 상황이 카드 테이블 덕분에 어떻게 달라지는지 그림으로 보자. Old에 있는 그 캐시 객체를 K라고 표시했다.
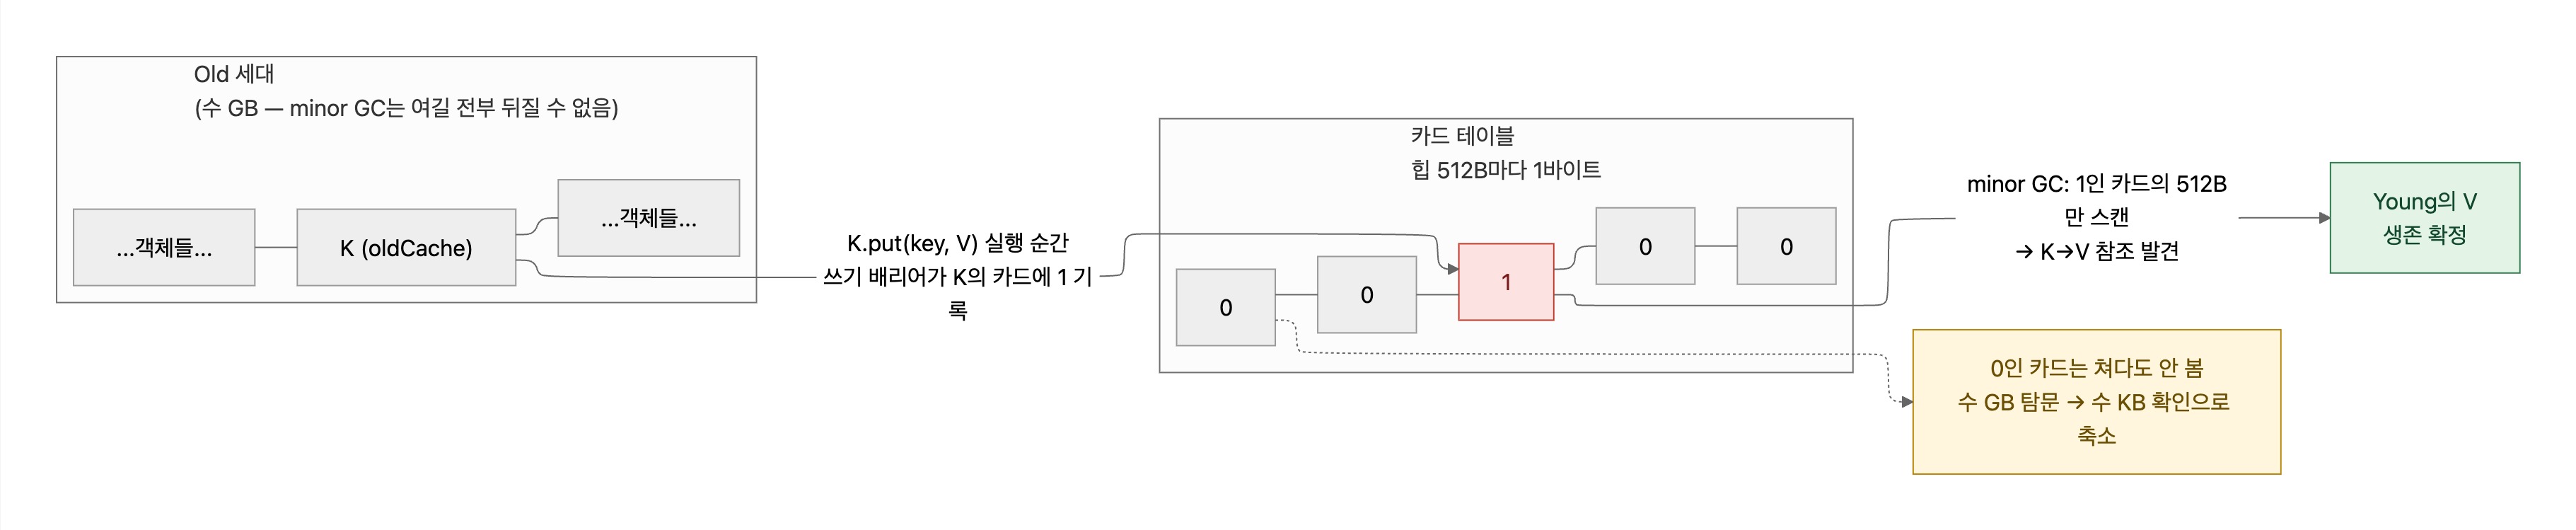
이것으로 세대별 수집의 그림이 완성됐다. 새 객체는 Eden에서 태어나고 minor GC가 작은 Young만 빠르게 돌며 단명한 다수를 치우고 살아남은 소수만 Old로 승격되며 놓칠 뻔한 세대 간 참조는 카드 테이블이 메워준다. 이 구조에서는 GC 작업의 대부분을 수 ms면 끝나는 minor GC가 담당하게 된다. Old까지 손대는 일은 어쩌다 한 번이면 되기 때문이다. 그리고 지금까지 나온 mark-compact, copying, 세대 구분을 그대로 묶어 단일 스레드로 구현한 것이 Java 1.0의 Serial GC다. 1코어짜리 작은 컨테이너에서는 지금도 현역이며 세대를 나누는 이 골격은 이후 등장하는 모든 HotSpot GC가 그대로 이어받는다.
하지만 Old도 결국 찬다. 승격된 객체가 계속 쌓이면 언젠가는 Old를 치워야 하는데 이때 도는 것이 힙 전체를 대상으로 mark-compact를 수행하는 Full GC다. 당연히 멈춤이 길다. 힙이 작던 90년대에는 참을 만했지만 힙이 수 GB로 커지자 이 멈춤이 수 초 단위가 되기 시작했다. 그리하여 이 문제를 풀기위해 두 가지 방향이 나오게 된다. 멈추는 건 어쩔 수 없으니 멈춘 동안이라도 빨리 해치우자는 쪽과 아예 멈추지 않는 방법을 찾자는 쪽이다.
6. Parallel GC — 알고리즘은 그대로, 일꾼만 N배
먼저 첫 번째 방향부터 보자. 멈춤을 피할 수 없다면 짧게라도 만들자는 것이다. 알고리즘은 한 글자도 안 바꾸고 멈춘 동안 놀고 있는 코어들을 전부 투입한다. 이론상 멈춤은 일량 ÷ 스레드 수가 되어야 한다.
그런데 나눠서 한다는 것이 생각만큼 간단하지 않다. GC의 작업은 그래프 탐색이다. 루트가 수백에서 수천 개 있으니 일단 이걸 GC 스레드들에게 나눠준다. "스레드 1은 이 루트들, 스레드 2는 저 루트들" 이런 식이다. 각 스레드는 자기 몫의 루트에서 출발해 참조를 따라가고 객체 하나를 처리하면 그 객체가 가리키는 것들이 새 할 일로 생기니 각자 자기 작업 큐(deque) 에 넣어두고 하나씩 꺼내 처리한다.
여기 함정이 있다. 루트를 똑같은 개수로 나눠줘도 일의 양은 전혀 균등하지 않다는 것. 객체 그래프 모양은 예측 불가이기 때문이다. 스레드 1이 받은 루트는 따라가 보니 달랑 객체 3개짜리 작은 그래프라 금방 끝나는데 스레드 2가 받은 루트는 알고 보니 거대한 컬렉션이여서 객체 100만 개가 줄줄이 딸려 나온다. 다른 스레드들은 다 끝내고 놀고 있는데 스레드 2 혼자 100만 개를 처리하고 있으면? 가장 느린 스레드가 끝날 때까지 멈춤이 계속되니 일량 ÷ 스레드 수 공식이 깨지고 사실상 싱글 스레드 GC와 다를 게 없어진다.
그래서 work stealing(작업 훔치기) 이 등장한다. 자기 큐가 비어버린 스레드는 놀지 않고 다른 스레드의 큐 반대편 끝에서 일감을 훔쳐온다.
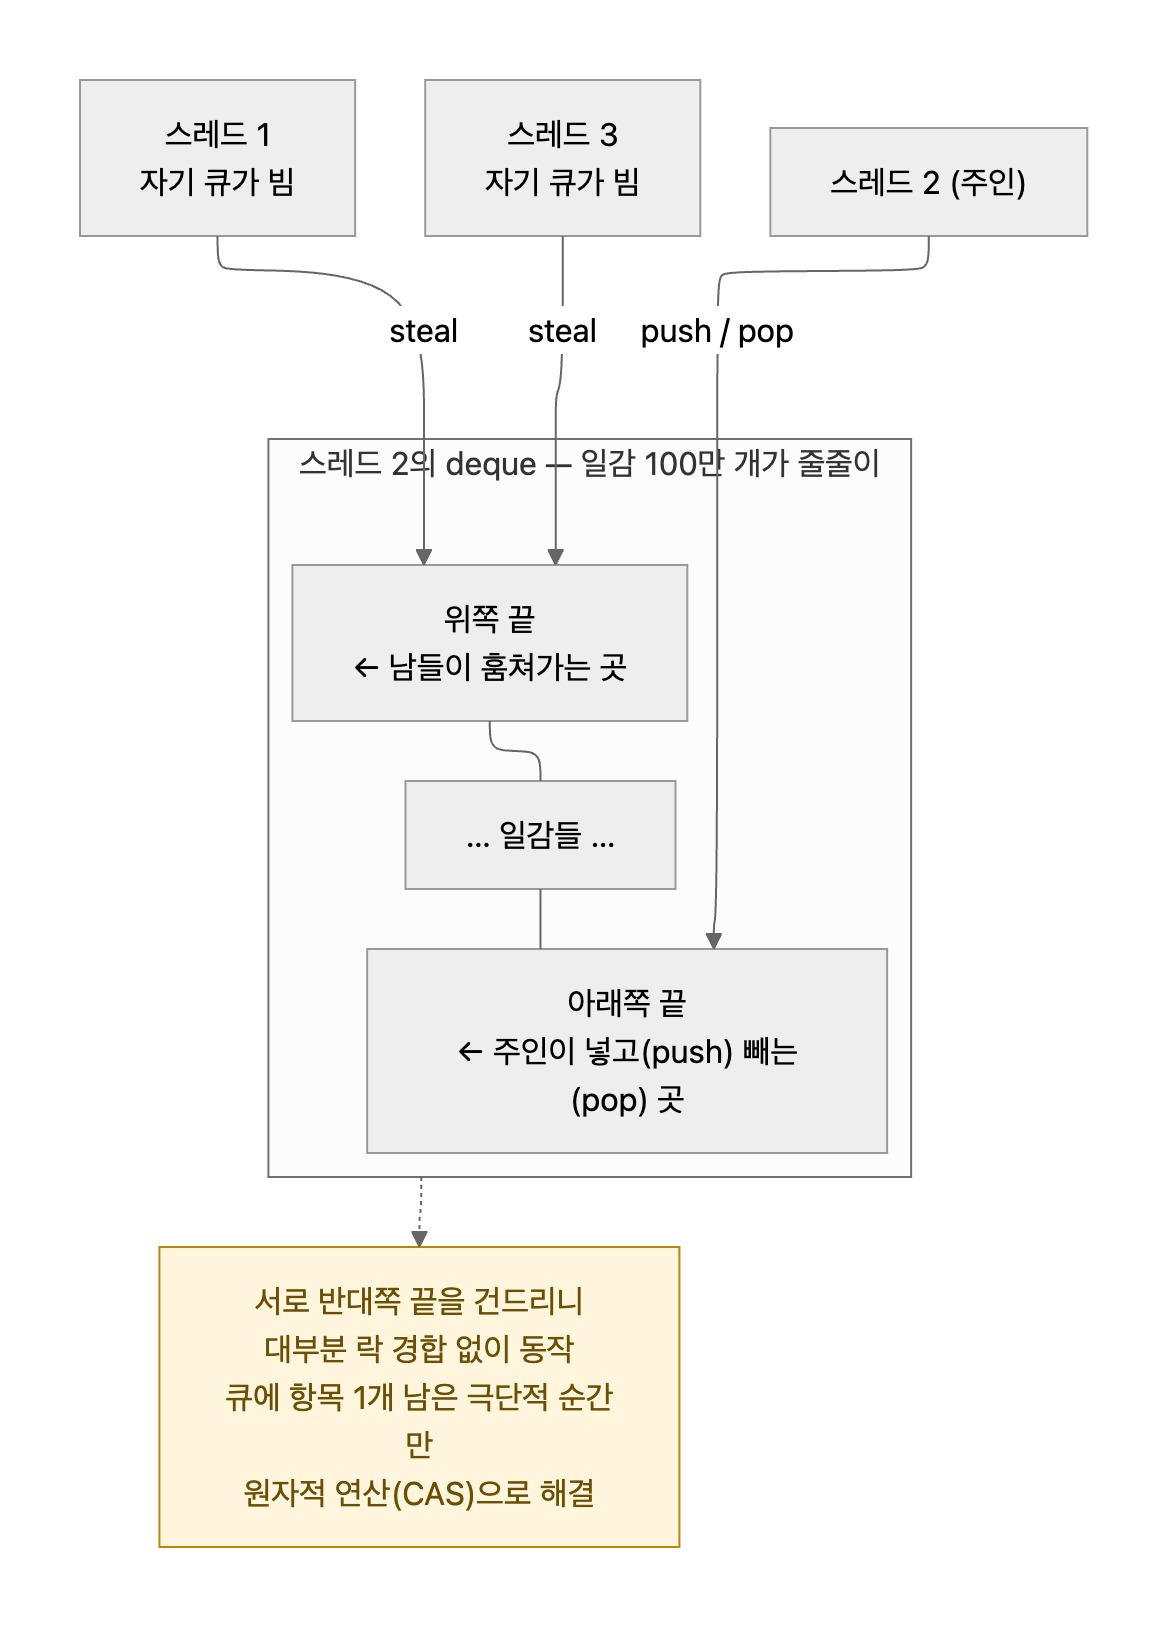
주인은 자기 큐의 아래쪽에서만 넣고 빼고 노는 스레드들은 위쪽에서 가져간다. 서로 다른 끝을 건드리니 대부분의 경우 락 경합 없이 돌아가고 두 스레드가 같은 항목을 두고 싸우는 건 큐에 항목이 1개 남은 극단적 순간뿐이라 그때만 원자적 연산(CAS)으로 해결한다.
이 방식이 Parallel GC다. CPU 코어가 여러 개인 서버가 흔해지던 2000년대 초에 등장했고, JDK 5부터는 코어가 2개 이상인 머신에서 자동으로 기본 GC가 됐다. JDK 6부터는 Old를 압축하는 작업까지 병렬로 처리하게 됐으며(Parallel Old), 이 기본 자리는 JDK 8까지 이어졌다.
Parallel GC의 강점은 처리량이다. 처리량이란 전체 실행 시간 중에서 GC가 아니라 앱이 실제로 일한 시간의 비율을 말한다. 중간에 멈추긴 하지만 여러 코어가 달려들어 최대한 빨리 끝내니 같은 시간 동안 해내는 일의 총량으로 보면 이만한 방식이 없다. 그래서 밤새 돌려놓는 배치 작업이나 통계 계산, 빌드처럼 중간에 몇 초 멈추든 상관없고 전체 소요 시간만 중요한 작업이라면 2026년인 지금도 Parallel이 정답인 경우가 많다.
하지만 한계도 분명하다. 여덟 명이 나눠 해서 멈춤이 8분의 1로 줄었을 뿐 힙이 커지면 멈춤도 같이 길어진다는 사실 자체는 바뀌지 않았다. 예를 들어 4GB 힙의 Full GC가 2초 걸린다고 하자. 배치 작업이라면 전체 소요 시간에 2초가 더해질 뿐이니 아무 문제가 없다. 그런데 웹 서비스라면 이야기가 다르다. 그 2초 동안 들어온 모든 요청이 응답을 못 받고 기다린다. 평소 20ms면 응답하던 서비스가 하필 GC가 도는 순간에 요청을 보낸 사용자에게는 2초짜리 응답을 주는 것이다. 사용자 눈에는 서비스가 가끔씩 느려지는 것으로 보인다.
이런 서비스에서 중요한 건 일의 총량(처리량)이 아니라 요청 하나하나가 얼마나 빨리 응답받느냐, 즉 지연(latency) 이다. 그리고 지연을 잡으려면 멈춤을 여럿이 나눠서 빨리 끝내는 것으로는 부족하다. 멈춤 자체를 없애야 한다.
7. 동시 마킹 — 삼색 추상화와 "잃어버린 객체"
이제 두 번째 방향이다. 아예 멈추지 않는 방법을 찾는 쪽이다.
GC의 멈춤 시간을 뜯어보면 제일 오래 걸리는 작업은 mark, 그러니까 루트에서 참조를 따라가며 산 객체를 표시하는 탐색이다. 그렇다면 이 마킹부터 앱을 세워두고 하지 말고 앱이 도는 동안 옆에서 나란히 돌려보자는 발상이 나온다.
그런데 앱을 세우지 않는 순간 곧바로 문제가 생긴다. GC가 객체 그래프를 탐색하는 동안에도 앱은 계속 실행되면서 새 객체를 만들고 참조를 연결하고 끊는다. 탐색 중인 그래프가 실시간으로 바뀌는 것이다. GC 입장에서 앱은 자기가 조사하고 있는 지도를 계속 고쳐대는 존재인 셈이라 GC 문헌에서는 앱 스레드를 mutator(그래프를 변형시키는 자)라고 부르기도 한다. 이 글에서는 그냥 앱이라고 하겠다.
이 질문을 다루려면 먼저 마킹이 어디까지 진행됐는지를 표현할 방법이 필요하다. Dijkstra가 정리한 삼색 추상화가 그것인데 탐색 과정에서 각 객체가 놓이는 상태를 세 가지 색으로 나눈다.
- 흰색: 아직 발견되지 않은 객체. 마킹이 끝날 때까지 흰색이면 쓰레기로 판정된다.
- 회색: 발견은 됐지만 처리가 안 끝난 객체. 나는 산 것으로 확인됐는데 내가 가리키는 것들은 아직 안 따라가 봤다는 뜻이다.
- 검정: 처리가 끝난 객체. 나도 확인됐고 내가 가리키는 것들도 전부 발견해 뒀다. 그래서 검정은 두 번 다시 방문하지 않는다.
마킹은 단순한 규칙의 반복이다. 회색 객체를 하나 꺼내서 그것이 가리키는 흰색 객체들을 회색으로 칠하고 자신은 검정이 된다. 처음에는 루트가 직접 가리키는 객체들이 회색으로 시작하고 이 규칙을 반복하다 회색이 하나도 안 남으면 탐색이 끝난 것이다. 그때까지 흰색으로 남은 객체가 쓰레기다.
이제 마킹이 진행되는 도중에 앱이 끼어드는 순간을 보자. A는 검정, B는 회색, C는 흰색이고 현재 C로 가는 참조는 B→C 하나뿐인 상황에서 앱이 이 두 줄을 연달아 실행한다.
a.ref = c;      // ① 검정 A가 흰색 C를 새로 가리킴
b.ref = null;   // ② C로 가는 유일한 회색 경로(B→C)가 끊김
해당 구문이 실행되는 것을 생각해보자.이제 C로 가는 참조는 A→C뿐인데 A는 검정이라 다시 방문하지 않는다. B를 마저 탐색해도 C는 안 나온다. 이미 끊겼으니까. 마킹이 끝나면 C는 흰색인 채로 남고 살아있는 C가 회수된다. 이것이 lost object 문제다. 시간 순서로 그려보면
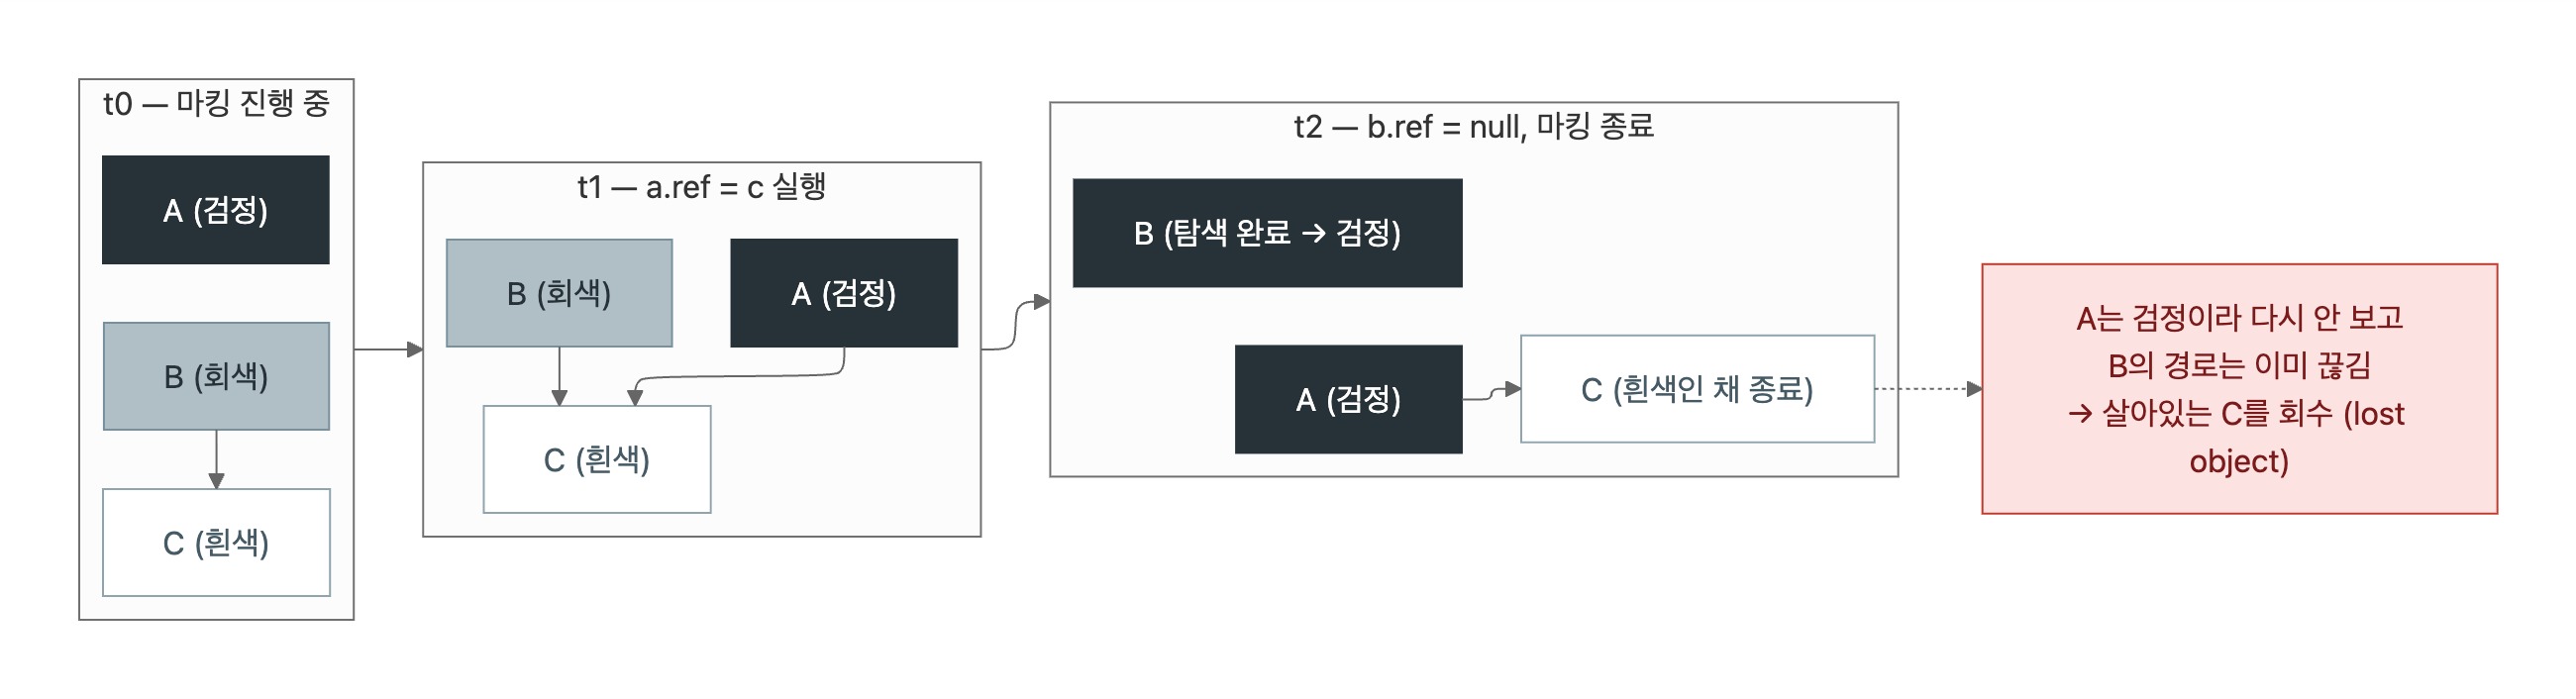
방금의 사고를 되짚어 보면 조건이 보인다. 살아있는 객체를 잃어버리려면 두 가지가 모두 일어나야 했다. 검정 객체가 흰색 객체를 새로 가리키게 되는 참조 추가, 그리고 그 흰색으로 가던 회색 쪽 경로가 전부 끊기는 참조 삭제다. 둘 중 하나라도 안 일어났다면 C는 어떻게든 발견됐을 것이다. 뒤집어 말하면 둘 중 한쪽만 확실히 감시해도 산 객체를 잃는 일은 없다.
그런데 참조 추가와 삭제를 어떻게 감시할까. 여기서 짚어볼 사실이 하나 있다. 참조가 추가되는 것도 삭제되는 것도 결국 같은 obj.field = value, 즉 필드에 객체를 넣는 대입에서 일어난다는 점이다. 이 대입이 실행되는 순간에는 두 가지 value가 지나간다. 하나는 새로 저장되는 value, 즉 지금 새로 생기는 참조다. 다른 하나는 덮어써지기 직전까지 필드에 들어 있던 이전 value, 즉 지금 사라지는 참조다. 그러니 카드 테이블 때처럼 대입 코드에 명령 몇 개를 끼워 넣으면 그 자리에서 새 값을 잡아둘 수도 있고 이전 값을 잡아둘 수도 있다. 쓰기 배리어가 여기서 두 번째 일을 맡게 되는 것이다. 그리고 새 값(참조 추가) 쪽을 잡느냐, 이전 값(참조 삭제) 쪽을 잡느냐로 두 가지 방식이 갈린다.
Incremental Update — 새로 이어지는 참조를 쫓아간다
참조 추가, 즉 대입의 새 값 쪽을 감시하는 방식이다. 삼색 추상화를 만든 Dijkstra 쪽에서 나온 방법이다. 배리어가 하는 일은 이렇다. 대입이 실행될 때 새로 저장되는 값을 들여다보고 그것이 아직 발견되지 않은 흰색 객체라면 회색으로 칠해 탐색 대상에 다시 넣는다. 검정에 새 참조가 꽂혀도 그 상대가 회색이 되어 있으니 잃어버리지 않는 것이다.
다만 이 방식에는 꼬리가 남는다. 마킹이 진행되는 내내 이런 새 참조가 계속 생기니 마킹을 끝내려면 그동안 새로 이어진 부분들을 다시 따라가 보는 재탐색(remark) 시간이 필요하고 이때는 잠깐 멈춰야 한다. 문제는 다시 열어본 곳에서 또 새 흰색 객체가 나오고 그걸 탐색하는 동안 또 참조가 바뀌고… 끝없는 따라잡기 게임이 된다는 것.
SATB — 시작 순간을 정답으로 못 박는다
이번에는 반대로 이전 값 쪽을 감시하는 방식이다. SATB(Snapshot-At-The-Beginning)는 질문 자체를 바꾼다. "마킹이 시작된 순간에 살아있던 객체는 이번 사이클에선 전부 산 것으로 치자." 마치 마킹 시작 순간에 힙 전체의 스냅샷을 찍고 그 사진 속에서 도달 가능했던 객체만 지키면 된다는 것이다. 사진 이후에 무슨 일이 벌어지든 이번 GC의 정답은 스냅샷이 기준이다.
물론 실제로 힙 전체를 복사해서 사진을 찍어두는 것은 아니다. 사진은 어디까지나 논리적인 기준일 뿐이다. 그래서 문제가 하나 남는다. 마킹은 그 사진 속 그래프를 천천히 따라가는데 그동안 앱은 실제 그래프를 계속 바꾸고 있으니 사진과 현실이 조금씩 어긋난다는 것이다.
다행히 어긋남이 전부 위험한 것은 아니다. 참조가 추가되는 쪽은 괜찮다. 사진 속에 원래 있던 객체라면 사진 기준으로 이미 다른 경로로 도달 가능했던 것이니 참조가 하나 더 생겨도 달라질 게 없고 사진을 찍은 뒤에 새로 태어난 객체는 애초에 별도 규칙으로 처리한다. 마킹 중에 할당된 객체는 그냥 전부 산 것으로 표시하는 것이다. 위험한 쪽은 참조 삭제다. b.ref = null이 실행되는 순간, 사진 속에서 C로 가던 경로가 현실에서 사라진다. 마킹이 아직 B→C를 따라가기 전이었다면 사진 기준으로는 분명히 살아있던 C를 이제 영영 찾을 수 없게 된다.
그래서 SATB의 배리어는 이 값을 저장해둔다. b.ref = null 같은 대입이 실행될 때 덮어써지기 직전에 b.ref에 들어 있던 값(여기서는 C)을 큐에 적어두는 것이다. 이 전체 과정을 그림으로 보면 이렇다.
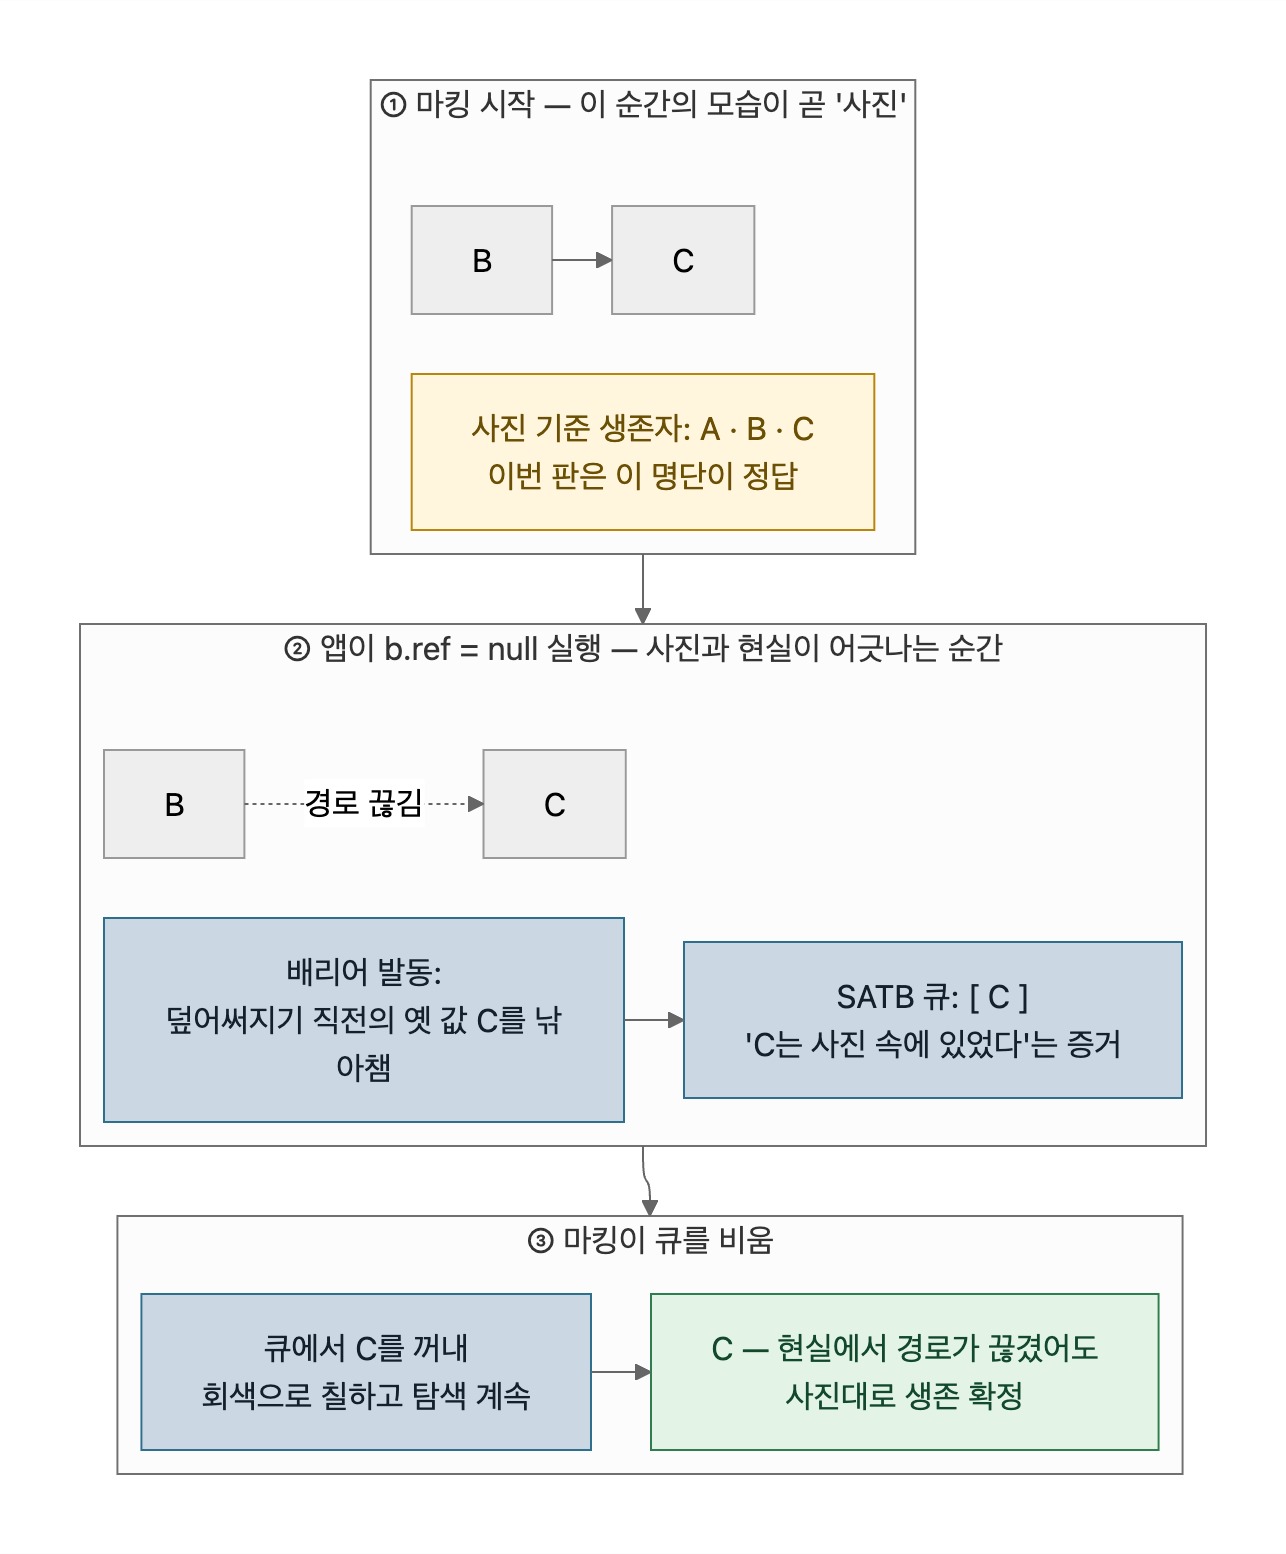
큐에 적어두는 행위는 이 참조는 이전에 존재했었다는 사실을 보장하는 일이다. 마킹은 나중에 이 큐를 비우면서 거기 적힌 객체들을 회색으로 칠하고 탐색을 이어간다. 결과적으로 사진 속에서 도달 가능했던 객체는 현실에서 경로가 끊겨도 반드시 발견된다.
아까의 두 줄에 대입해보면, a.ref = c는 SATB가 신경도 안 쓴다. 추가는 사진을 훼손하지 않으니까. 반면 b.ref = null에서는 배리어가 발동해이전 값 C가 큐에 기록되고, C는 살아남는다. 참조 추가를 잡고 삭제를 무시하는 Incremental Update와 정확히 반대다. 산 객체를 잃으려면 추가와 삭제가 둘 다 필요하니 어느 한쪽만 확실히 잡으면 되는데 SATB는 삭제 쪽을 잡기로 한 것뿐이다.
그럼 SATB는 왜 따라잡기 게임이 없을까. Incremental Update는 검정에 새 참조가 꽂힌 지점이 마킹 내내 계속 쌓이니까 쫓아다녀야 했다. 반면 SATB는 정답 자체가 시작 시점이 고정되어 있어절대 안 변한다. 배리어 큐에 쌓인 이전 값들만 소진하면 끝인데 이 큐는 유한하다. 그래서 마킹 종료가 훨씬 깔끔하고 멈춤이 짧다.
물론 단점도 있다. 시작 시점에 살아있었으면 산 것이라는 규칙으로 인해 마킹 시작 직후에 진짜로 죽은 객체도 시작 시점엔 살아있었으니 이번 GC엔 못 치운다. 심지어 b.ref = null이 C를 진짜로 버리는 중이었어도(아무도 C를 다시 안 가리킴), 배리어는 사정을 모르니 일단 C를 큐에 넣고 살려준다. 그래서 SATB 쪽이 다음 사이클로 미뤄지는 쓰레기(floating garbage)가 좀 더 많다. 하지만 이건 안전한 방향의 오류다. 죽은 걸 한 판 더 살려두는 건 메모리 낭비일 뿐이고 다음 사이클에 회수되면 그만이지만, 산 걸 죽이는 건 정합성 파괴다. 차원이 다르다.
요약하면 Incremental Update는 지금 새로 이어지는 것들을 쫓아가는 방식이고 SATB는 시작 순간을 정답으로 못 박고 그 정답을 지우려는 시도(이전 값 덮어쓰기)만 증거로 남기는 방식이다. 그런데 어느 쪽을 선택하든 똑같은 한계가 하나 남는다. 동시에 돌 수 있게 된 건 마킹뿐이라는 것이다. 객체를 옮기는 작업은 여전히 앱을 멈춰야 한다. 객체를 옮기려면 그 객체를 가리키던 모든 참조를 새 주소로 고쳐야 하는데 고치는 사이에 앱이 이전 주소로 읽어버리면 사고이기 때문이다.
이걸 멈추지 않고 해내려면 방법은 하나뿐이다. 마킹 때 쓰기 순간을 낚아챘듯이 이번에는 앱이 참조를 읽는 순간을 낚아채는 것이다. 읽어온 주소가 이사 가기 전의 이 주소라면 그 자리에서 새 주소로 바꿔서 건네주면 된다. 그런데 여기에 걸리는 게 있었다. 쓰기는 어쩌다 한 번이지만 읽기는 코드 곳곳에서 쉴 새 없이 일어난다. 필드 하나 가져오는 것도 객체의 메서드 하나 호출하는 것도 전부 참조 읽기다. 그 모든 읽기마다 검사 코드를 붙이면 프로그램 전체가 느려질 게 뻔하다는 것이 당시의 판단이었고 그래서 이 한계는 그 뒤로 20년 동안 풀리지 않는다.
8. CMS (2002 ~ JDK 14) — 동시 마킹의 첫 제품화, 그리고 단편화의 복수
이 동시 마킹을 실제 JVM에 처음 넣은 GC가 CMS다. 이름부터가 Concurrent Mark Sweep, 그러니까 앱과 동시에(Concurrent) 마킹하고(Mark) 쓸어담는다(Sweep)는 뜻이다. 이 이름 안에 CMS가 무엇을 택하고 무엇을 버렸는지가 다 들어 있다. 윗 내용에서 봤들이 해당 시점에는 마킹까지만 앱과 동시에 돌릴 수 있었고 객체를 옮기는 건 여전히 앱을 멈춰야 했다. 그래서 CMS는 아예 옮기지 않기로 한다. 옮기지 않으면 참조를 고칠 일도 없으니 그 문제 자체가 사라지기 때문이다. 대신 죽은 자리를 그 자리에서 비우는 2절의 sweep 방식으로 돌아간다. 이름이 Compact가 아니라 Sweep으로 끝나는 이유다.
적용 범위는 Old다. 마킹은 새 값 쪽을 감시하는 Incremental Update 방식을 골랐다. Young은 손대지 않고 기존처럼 앱을 세운 채 copying으로 치웠는데 minor GC는 원래 몇 ms면 끝나니 굳이 동시로 만들 이유가 없다고 본 것이다.
CMS의 사이클은 네 단계로 돈다
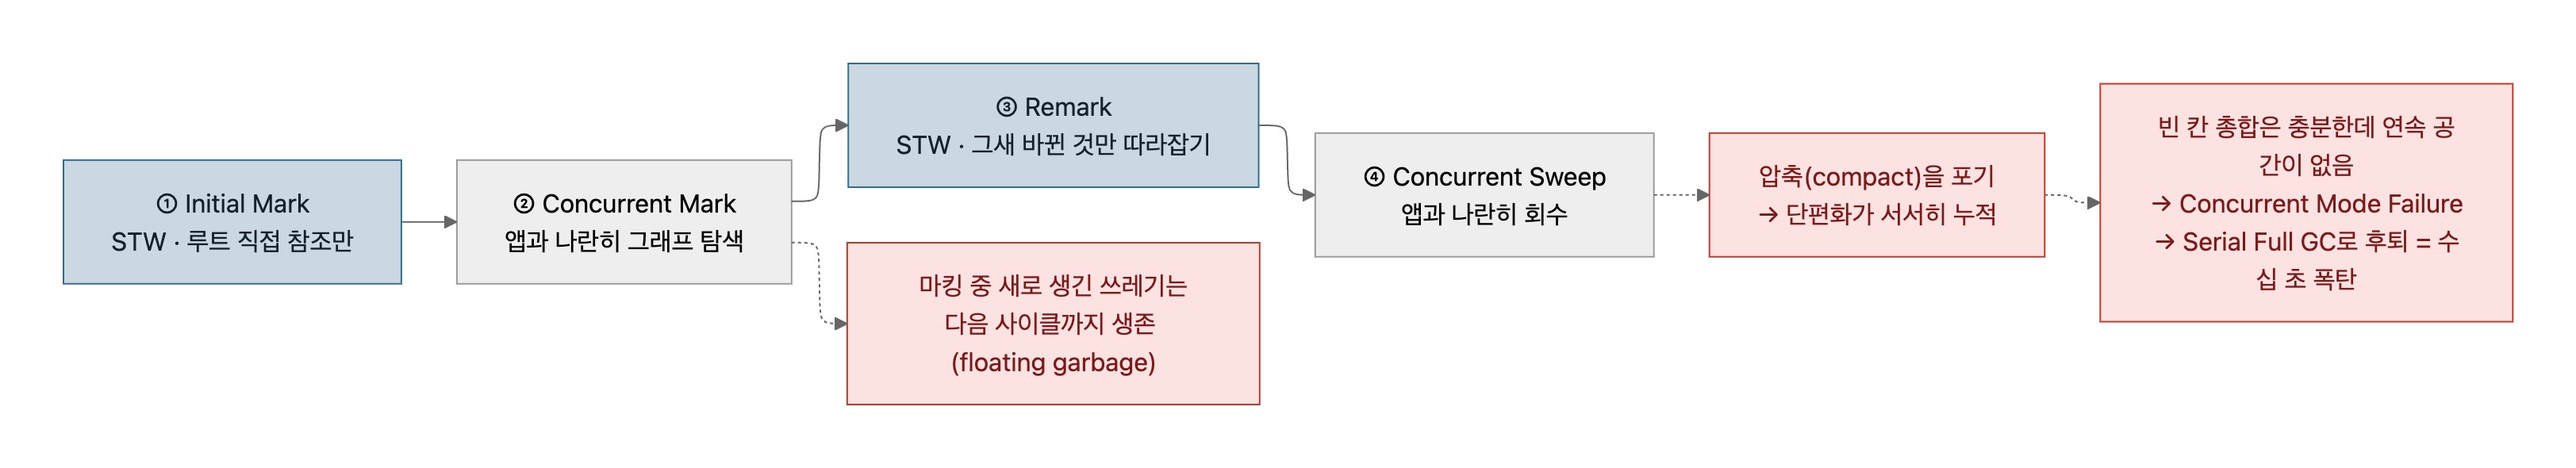
멈춤은 Initial Mark(루트가 직접 가리키는 것만 표시하니 짧다)와 Remark(Incremental Update가 기록해 둔 dirty 카드들을 재탐색하는 것, 즉 7절에서 말한 remark 비용) 두 번뿐이다. 수 초씩 멈추던 Old 정리가 수십 ms 멈춤 두 번으로 바뀌었다. 저지연 Java 시대의 개막이었다.
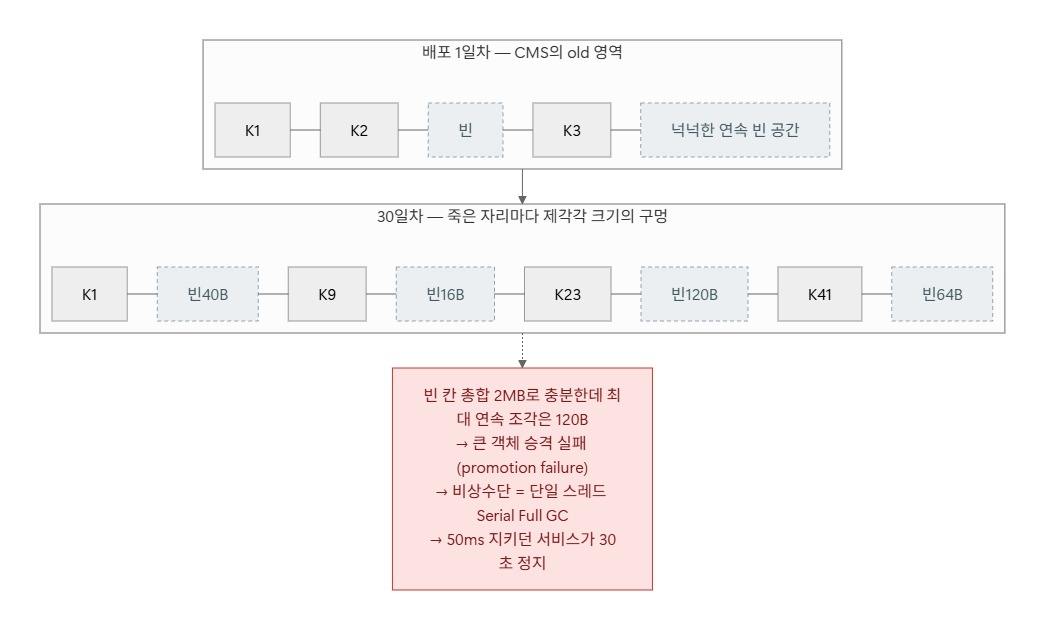
그런데 실제 운영에서는 이런 일이 벌어진다. 배포 후 며칠은 완벽하게 돌아간다. 하지만 sweep은 죽은 자리를 그 자리에서 비우는 방식이다. 2절에서 봤던 단편화가 그대로 돌아온다는 뜻이다. 시간이 지날수록 Old 곳곳에 제각각 크기의 구멍이 쌓여 간다.
이 상태에서 사고가 나는 경로는 크게 두 가지다. 하나는 큰 객체를 Old로 승격시키려는데 빈 공간을 다 합치면 충분한데도 그만한 크기의 연속 공간이 없어서 넣을 자리를 못 찾는 경우다. 다른 하나는 앱이 객체를 만들어내는 속도가 GC가 치우는 속도를 앞질러서 동시 마킹이 끝나기도 전에 Old가 꽉 차버리는 경우다.
둘 중 어느 쪽이든 CMS는 더 이상 동시로는 처리할 수 없다고 판단하고 비상수단으로 넘어간다. 그런데 그 비상수단이 앱을 완전히 세워두고 스레드 하나가 힙 전체를 정리하는 단일 스레드 Full GC였다. 평소 50ms에 응답하던 서비스가 갑자기 오랜 시간 멈추는 것이다. 서버가 오랜 시간 멈추면 서버가 살아있는지 확인하는 헬스체크가 실패하기에 충분한 시간이라 로드밸런서는 이 서버가 죽었다고 판단하고 트래픽에서 빼버린다. 빠진 몫의 트래픽이 남은 서버로 몰리면 그쪽 Old는 더 빨리 차오르고 거기서도 같은 상황이 터지고 이렇게 서버들이 도미노처럼 쓰러지는 연쇄 장애가 발생한다.
이 과정을 그림 두 장으로 압축하면 이렇다.
자잘한 문제도 계속 따라다녔다. 앱과 동시에 마킹하는 방식에는 원초적인 낭비가 있는데 마킹이 도는 도중에 죽은 객체는 이번 GC에는 산 것으로 집계되어 다음 GC에야 치워진다는 점이다. 그만큼 힙에 여유 공간을 항상 넉넉하게 잡아둬야 했다. GC가 앱과 동시에 도는 만큼 CPU도 앱과 상시 나눠 써야 했다. 게다가 동시 마킹을 언제 시작할지 같은 것들을 운영자가 수십 개의 옵션으로 직접 맞춰줘야 했는데 이 튜닝이 워낙 까다로워 악명이 높았다. 결국 CMS는 JDK 9에서 폐기가 예고되고 JDK 14에서 완전히 제거된다.
하지만 CMS의 실패로 얻은 것은 분명했다. 단편화를 피하려면 압축을 버려서는 안 된다. 그리고 애초의 문제는 압축 자체가 아니라 힙 전체를 한 번에 압축하려니 멈춤이 길어진다는 것이었다. 그렇다면 압축을 버릴 게 아니라 작게 나눠서 조금씩 하면 된다. 이 생각이 다음 GC의 출발점이 된다.
다음 GC는 다음 글에서 자세히 다루도록 하겠다.
'Java & Kotlin' 카테고리의 다른 글
| [JVM] G1 GC의 보충설명 (0) | 2026.09.09 |
|---|---|
| [JVM] G1 GC (1) | 2026.09.02 |
| [JVM] JIT(Just-In-Time) 컴파일러의 발전과정 알아보기 - 1 (0) | 2026.08.27 |